眾所皆知 M5 Ultra 與 DGX Spark 都是當前消費端最多人吹捧的本地端 AI 電腦,應該很多人會好奇他們兩者在本地端應用方面誰更強?不過 M5 Ultra 目前最高等級是 256GB RAM(512GB 10月底上市),而 DGX Spark 單機僅有 128GB RAM,所以直接對比也並不公平。國外支援 AI YouTuber Alex Ziskind 近日就把 Mac Studio(M5 Ultra、256GB)與雙機 DGX Spark 集群(各 128GB x 2)拉出來對決,結果可能會讓你意想不到。
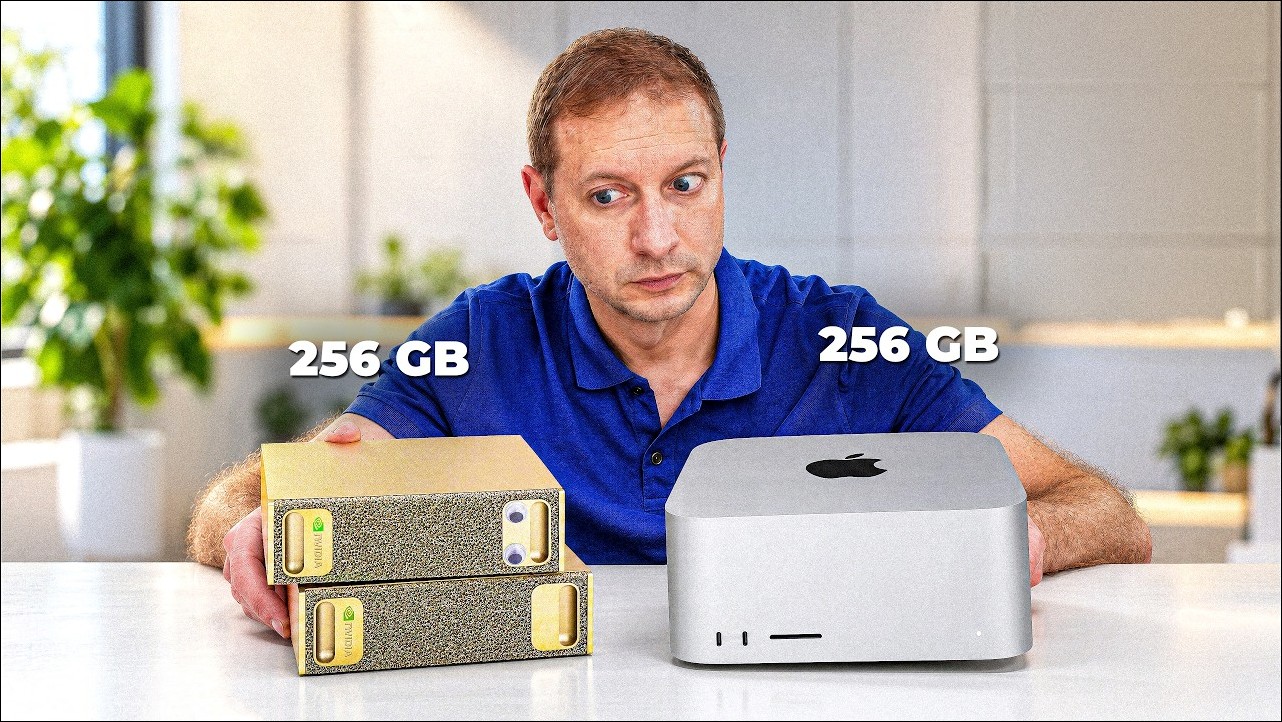
M5 Ultra vs DGX Spark 兩種 256GB 的長相
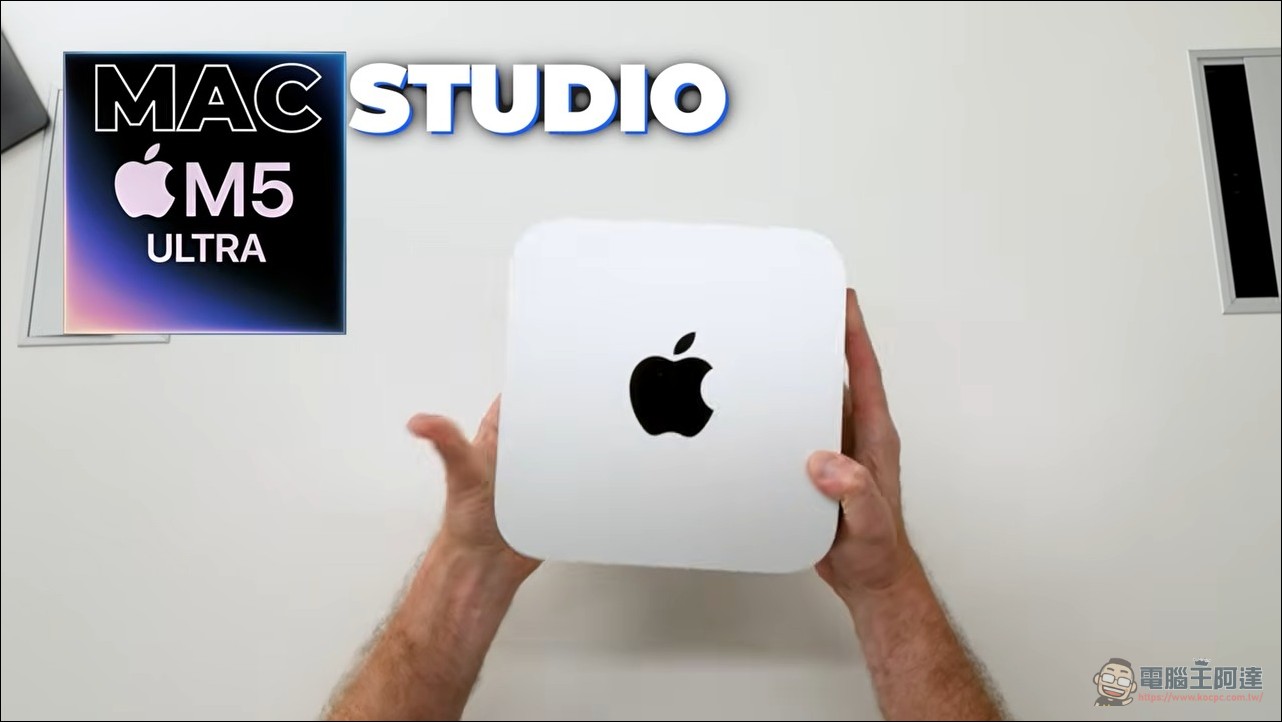
兩邊的帳面記憶體一樣大,長相完全不同。Mac Studio 這台是 M5 Ultra 頂配,256GB 統一記憶體、8TB SSD,他手上這台組態要價 14,000 美元、約新台幣 45.5 萬元。
另一邊是兩台 NVIDIA DGX Spark,每台 128GB 加 4TB 儲存,開賣時每台 3,999 美元、現在官方定價漲到 4,699 美元(約新台幣 15.3 萬元),兩台加起來約 30.5 萬元,再加一條不便宜的 200Gbps QSFP 線材。
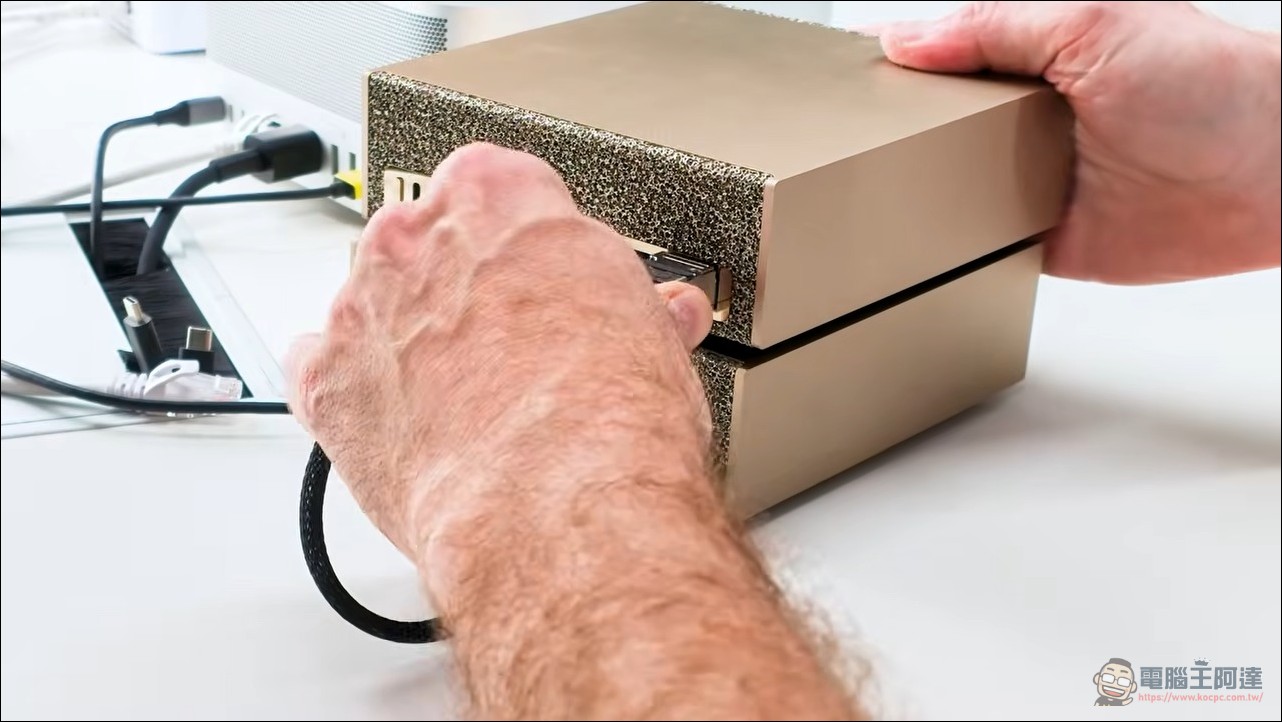
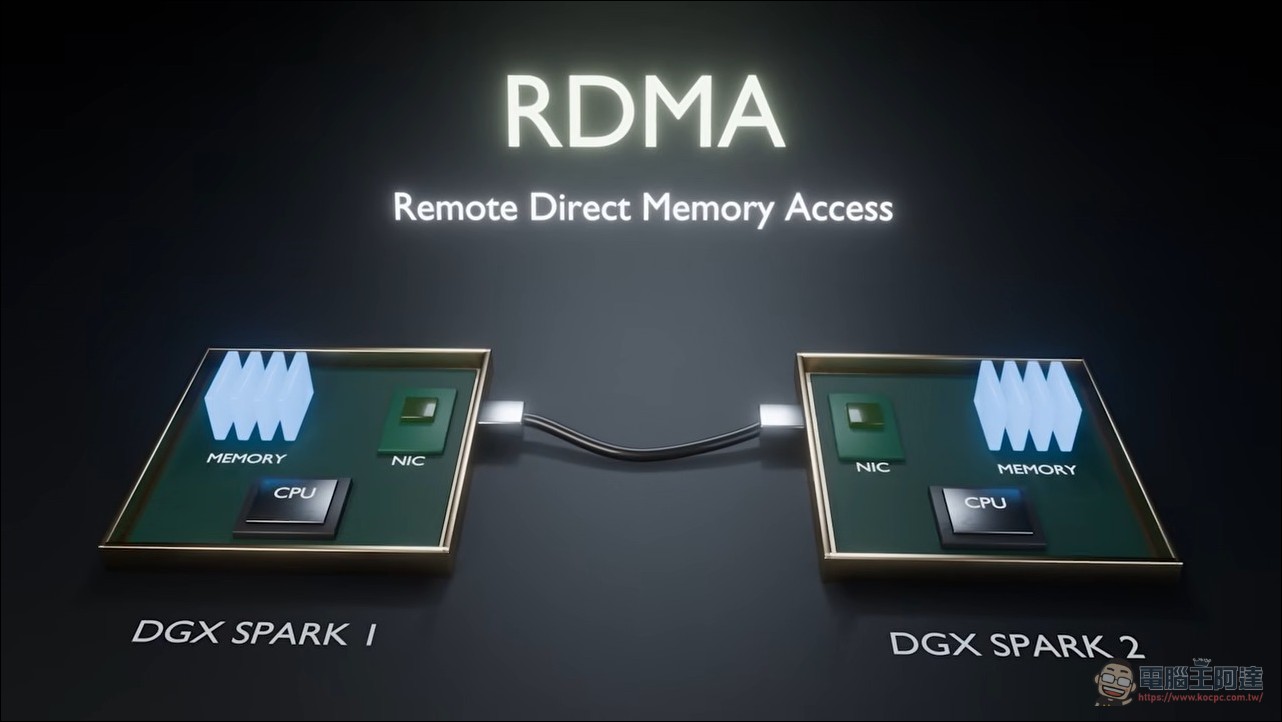
那條線跑的是 RoCE(RDMA over Converged Ethernet),讓兩台機器能直接讀寫對方的記憶體;模型則靠 vLLM 的張量平行(Tensor Parallel)切開,每一層對半分到兩台機器上,每生成一個 token 都要在線上互傳半成品,下一層才能開始(其實蘋果也有類似的技術 RDMA-over-Thunderbolt,使用 TB5 線材)。為什麼一定要兩台?DeepSeek V4 Flash 量化後約 150 到 160GB,塞不進單台 128GB 的 Spark;拆成兩台後每台佔用約 111GB,剛好留下運作空間。Mac 則是整包裝進單一記憶體池。他測的模型是 DeepSeek V4 Flash 與 Qwen 3.8 Flash Next,兩邊都跑 4-bit 量化版本。
生成速度打平,記憶體頻寬定勝負
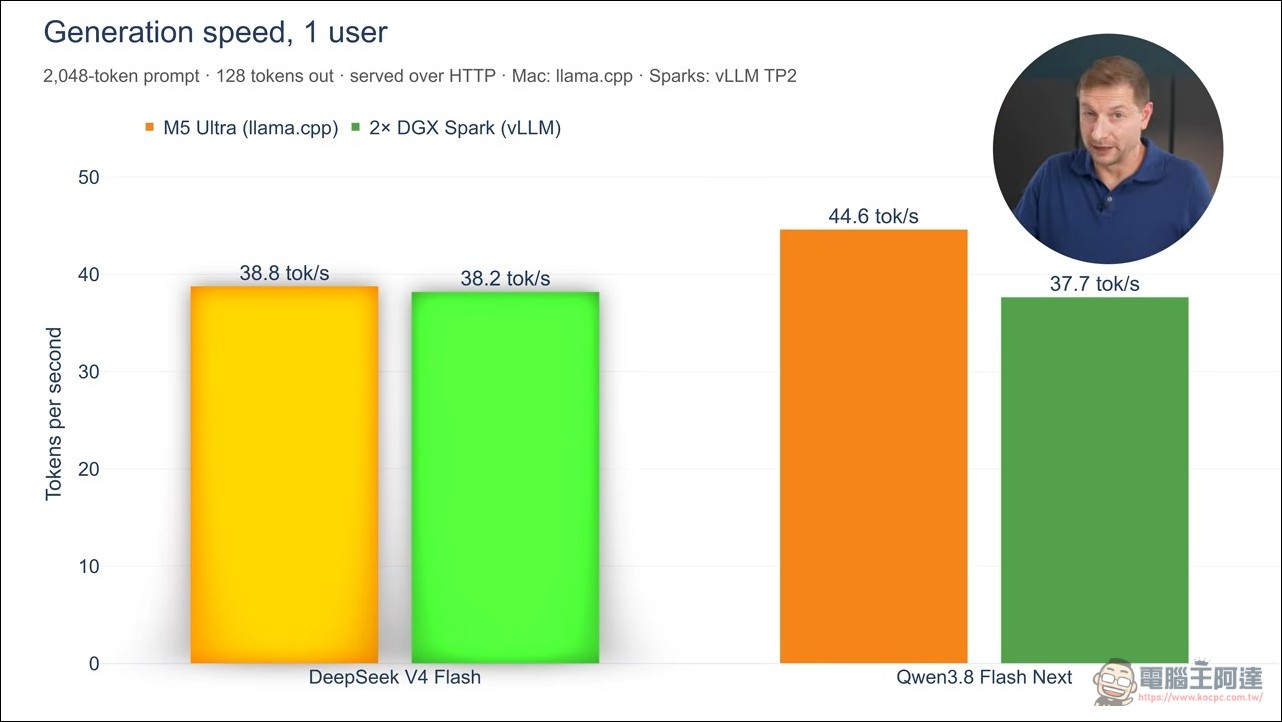
先看「寫」,也就是 token 生成。DeepSeek 兩邊都是每秒約 38 個 token,平手;Qwen 則是 Mac 每秒 45 個對 Spark 的 38 個,Mac 拿下一城。原因指向記憶體頻寬:M5 Ultra 官方規格 1.2TB/s,每台 Spark 只有 273GB/s,兩台加起來仍不到 Mac 的一半,那條標稱 200Gbps 的線他實測約 111Gbps,同步開銷再吃掉一些。
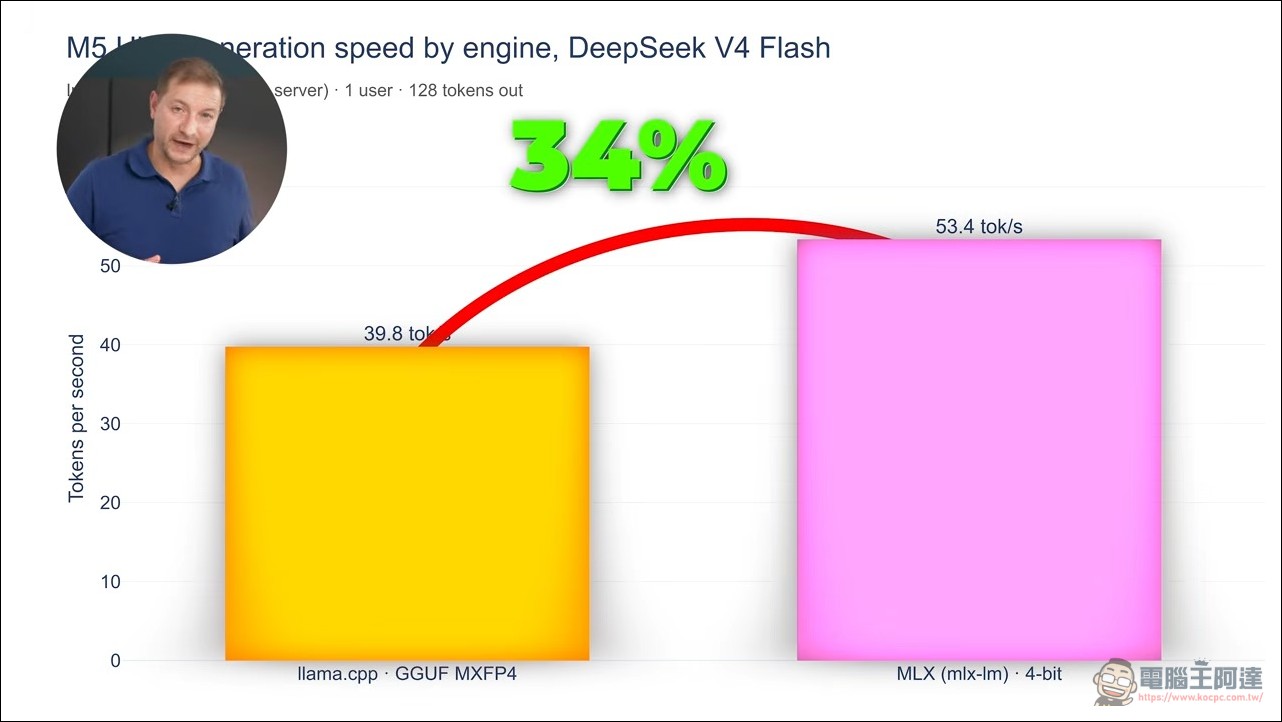
軟體的影響也很大。同一個 DeepSeek 在 Mac 上用 Llama.cpp 寫出每秒約 40 個 token,換成 MLX 直接跳到 53 個,只換引擎就快 34%;兩邊都用 Llama.cpp 時差距在 2% 以內。
讀 prompt 是 Spark 的主場
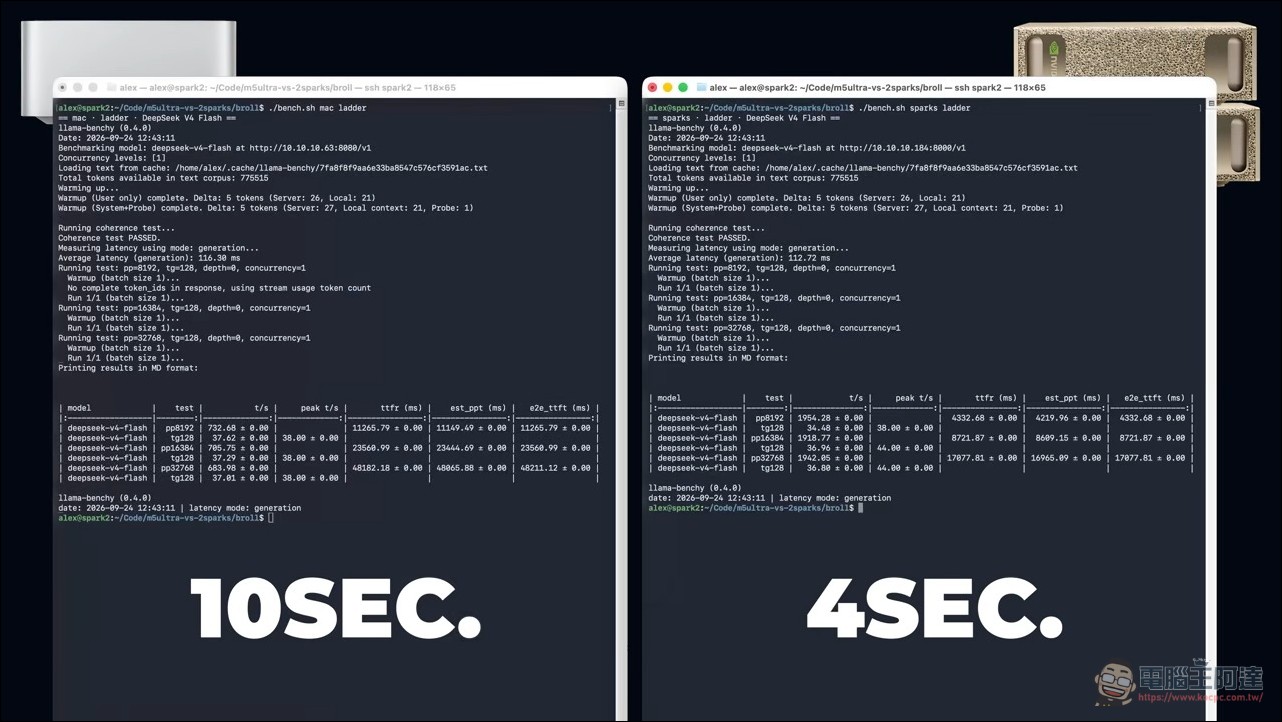
再看「讀」,也就是提示詞處理,畫面完全倒過來。2,000 token 時兩邊都快到沒感覺;8,000 token 時 DeepSeek 在 Spark 約 4 秒、Mac 約 10 秒;16,000 token 時 Mac 的等待翻倍到 21 秒。
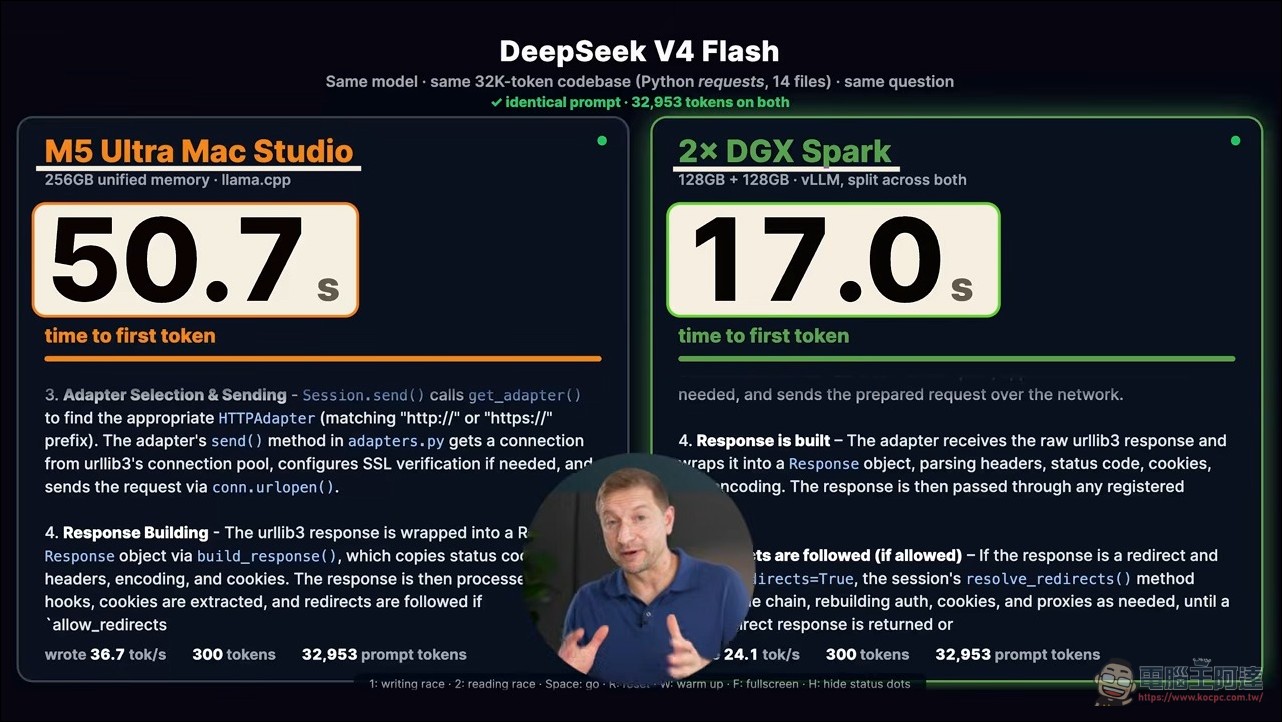
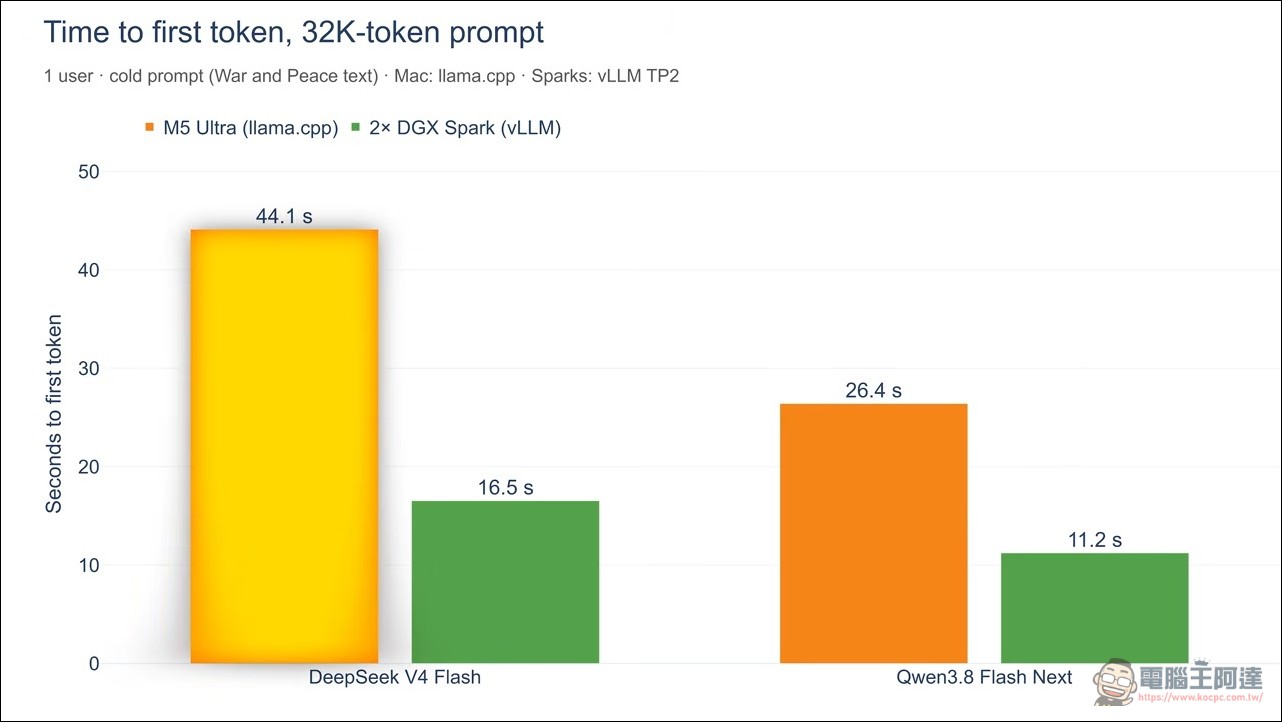
差距拉開是在真實程式碼庫測試的 TTFT(首 Token 吐字時間) :32,000 token、14 個 Python 檔案丟進去,雙 Spark 17 秒讀完開始吐字,Mac 到 50 秒還在讀提示詞,差距約 3 倍。換算成 Qwen 的較短提示也是同樣比例:Mac 26 秒對 Spark 的 11.2 秒,2.4 倍。Spark 一路推到 128,000 token 只花 72 秒;Mac 在這一關他乾脆不測,照 32K 的速度推估要等 3 分鐘以上。 這符合硬體架構的預期:提示詞處理吃的是 GPU 並行算力,兩台 Spark 的算力加總勝過單顆 M5 Ultra;token 生成吃記憶體頻寬,單機統一記憶體的 Mac 反而佔優。
快取救了 Mac
不過真實世界的對話不是每次都從零開始。伺服器會保留已經讀過的內容(前綴快取),16,000 token 的情境下:第一次提問 Mac 21 秒、Spark 8.3 秒;追問只要 Mac 3 秒、Spark 1.4 秒。那口「讀長文」的氣每個工作階段只付一次。程式碼工具就是這樣運作的:Agent 把程式碼庫送一次,伺服器留著,後續問題只加上新增的部分。
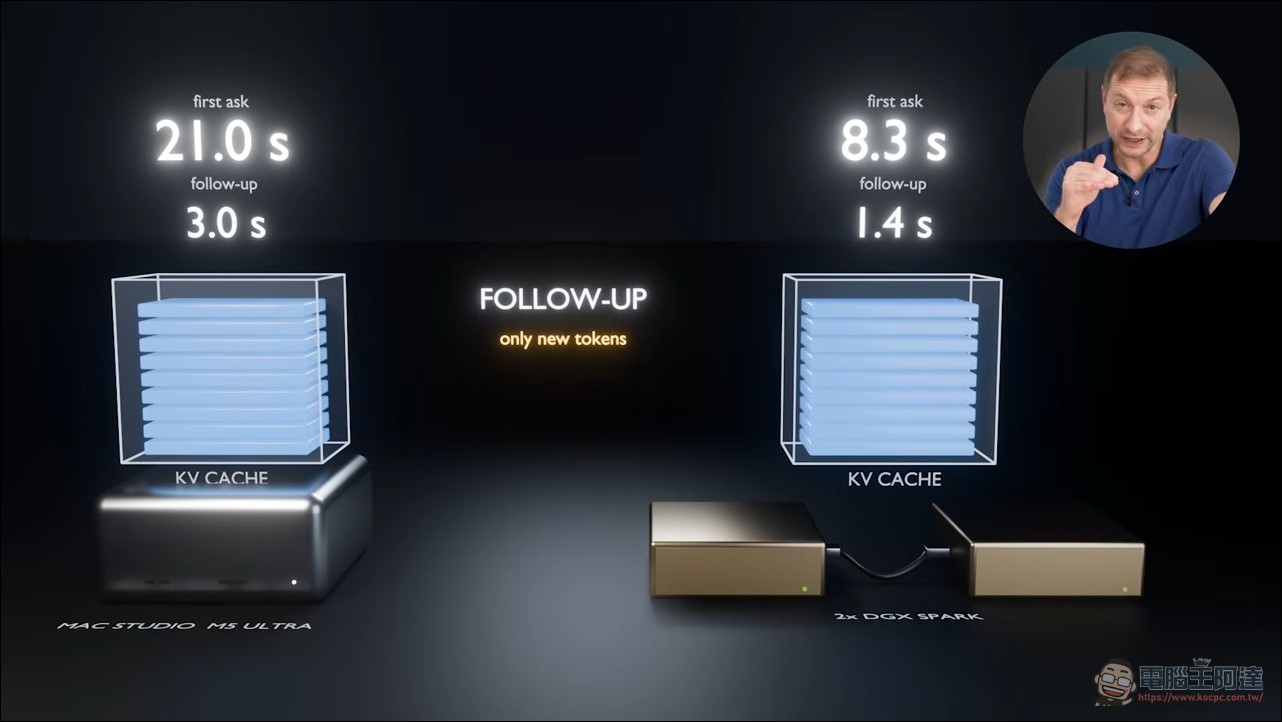
痛點在於情境一直在變:換 repo、丟大檔案、對話長過快取上限,就得重讀。另一個他觀察到的細節是換模型也會整批重算,等於重新付一次學費。 這也解釋了圈內對「分離式 prefill/decode」的興趣:讓算力大的 Spark 專門讀提示詞、頻寬大的 Mac 專門生成,各取所長。他說這類專案已經有人在做,但目前還是早期實驗。
多人使用才是分水嶺
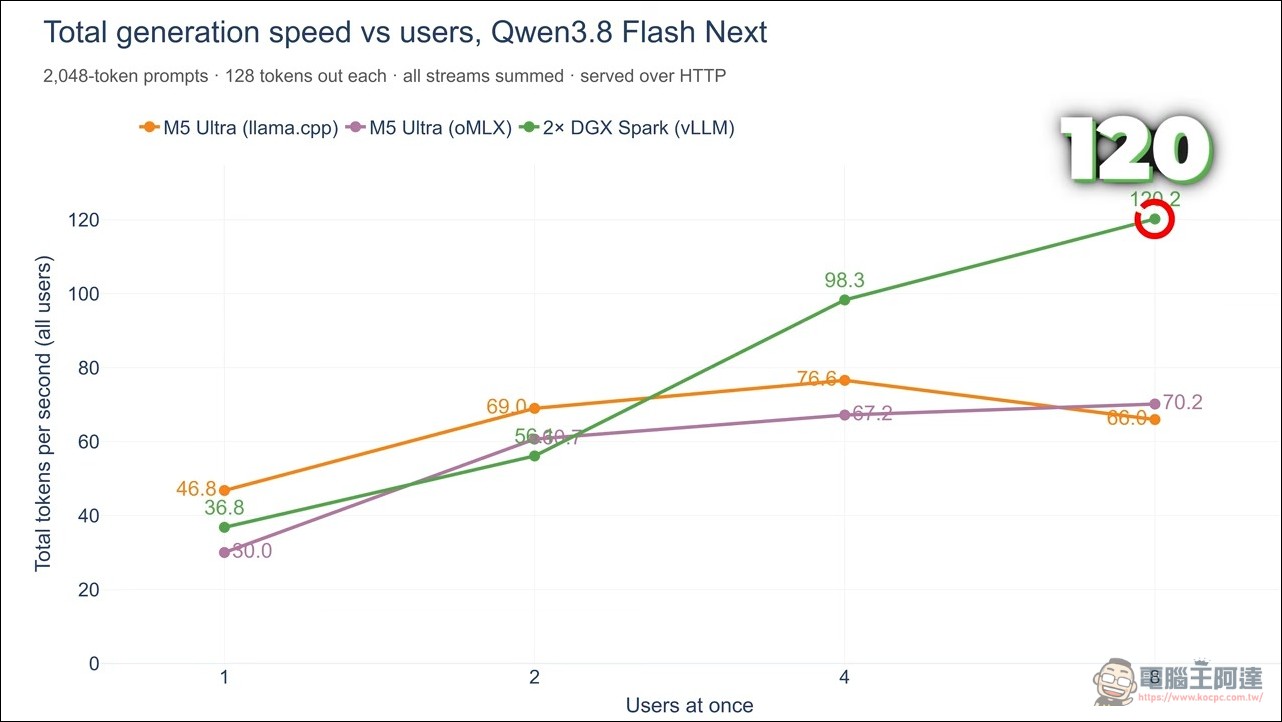
多人同時使用時,兩台機器的性格差異拉到最大。DeepSeek 在 Mac 上 4 人同時使用時總吞吐量每秒 66 個 token,8 人掉到 46;雙 Spark 則一路爬到 70。給每人 8,000 token 的對話歷史、8 人同時上線:Mac 總吞吐只剩每秒 11 個 token、Spark 有 25 個;更痛的是等待,Mac 上每個人要等超過一分鐘才看到第一個字,之後每秒約 5 個 token,Spark 大約等 24 秒、之後每秒 7 個。簡單說:Mac 是一到兩人的機器,雙 Spark 適合四人左右的小團隊,八個人就是硬撐。
熱、電、與麻煩程度
滿載時 M5 Ultra 吃 434 瓦、Spark 集群 410 瓦,幾乎一樣會跳電表;機身表面 Mac 最熱處 49 到 50 度、Spark 約 48 度,Mac Studio 背後出風口 56 度,Spark 機內他量到 58 至 63 度,兩邊都吵、都燙。他特別補充,這組滿載數字不代表待機狀態,閒置時兩者功耗差距其實很大(差了11倍)。
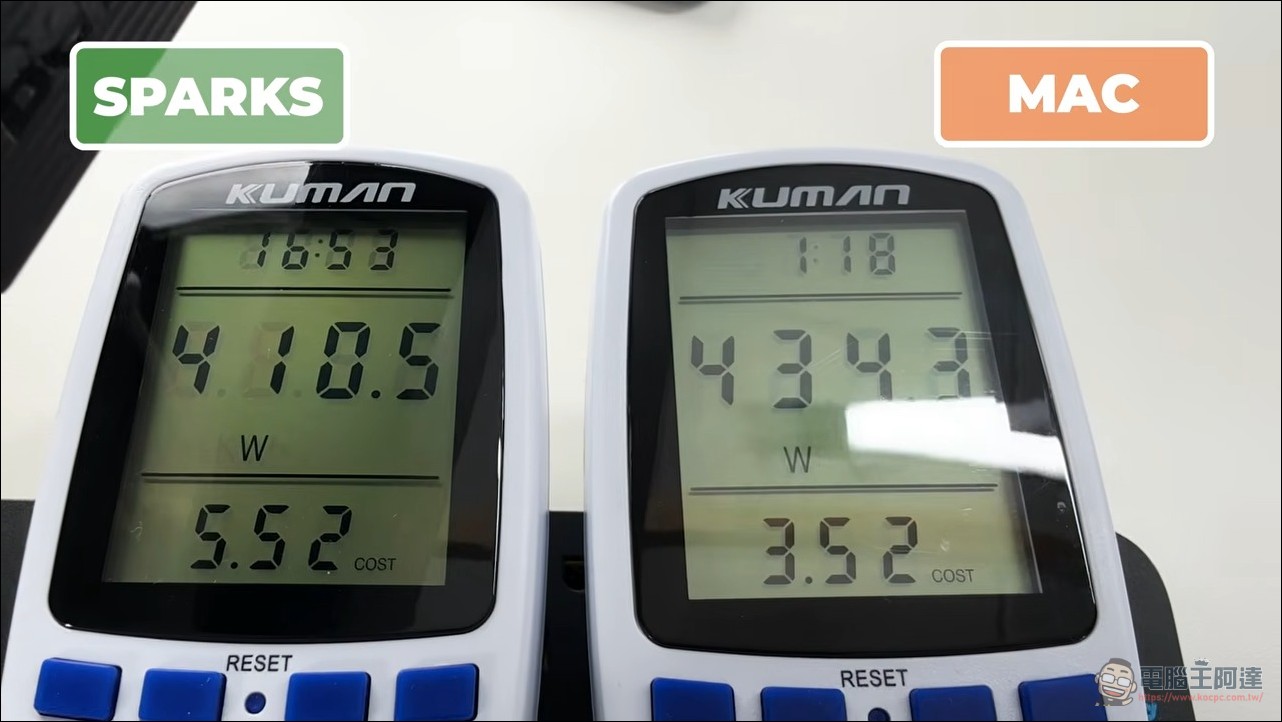
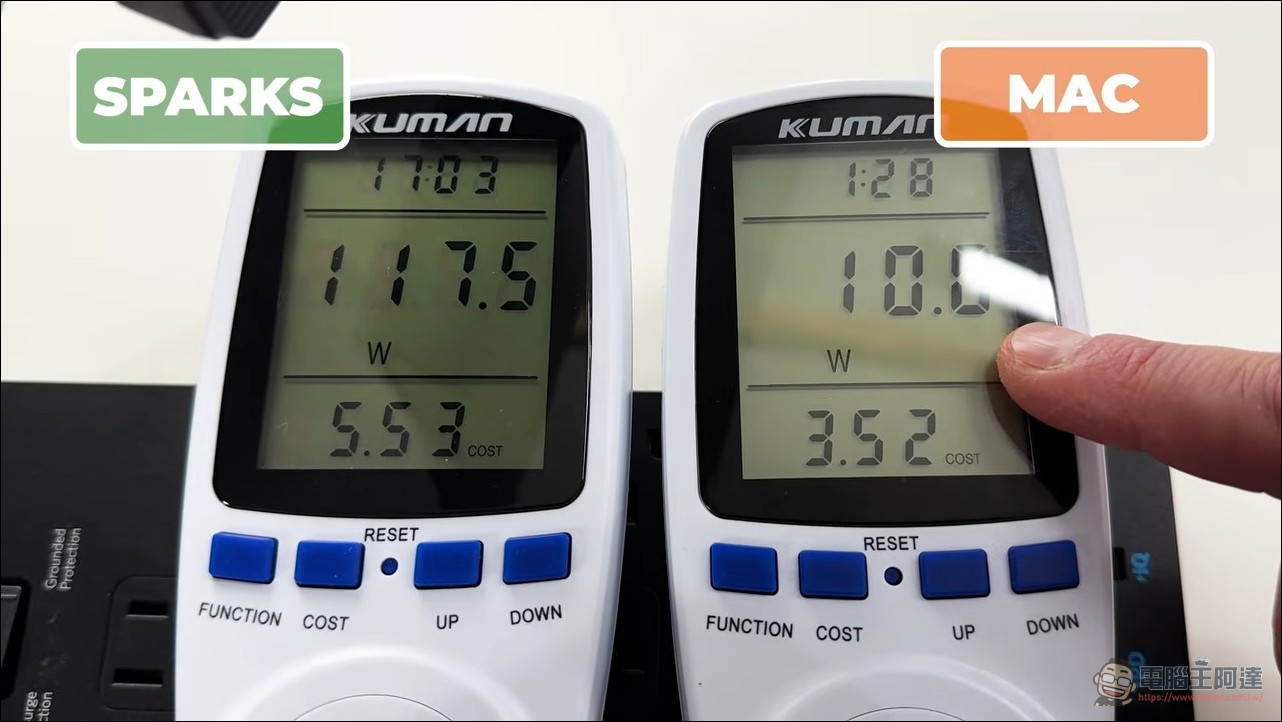
設定成本的差距才是日常分野:Mac 幾乎零設定,還能兼差剪片跑渲染;Spark 集群要對齊兩台的作業系統、核心、驅動程式與韌體,再灌 vLLM 多節點設定與一堆 NCCL、RoCE 環境變數,最後檢查 RDMA 流量。簡單說 Mac Studio 除了 AI 以外日常所有工作與娛樂都能輕鬆愉快使用,Spark 則就是專門給 AI 使用,LINUX 環境也要你自己去折騰就看你自己的選擇。有興趣的朋友可以看原始影片的介紹,有cc字幕:
結語:256GB 兩盒,不等於 256GB 一盒
他的答案是:裝得下一樣的模型,但讀得快很多。至於買哪個,先量自己的工作:提示詞有多大?答案要寫多長?大輸入(程式碼庫、長文件)吃 Spark 的讀速,長輸出與單人重度使用吃 Mac 的頻寬與省事。別忘了帳單:兩台 Spark 加線材 30 萬元有找,他那台 8TB 的 M5 Ultra 要 45.5 萬元(其實SSD不要買那麼大的話約35萬左右,價差主要在比黃金貴的 SSD),價差足以買一台高階筆電。如果你的工作是一天到晚把整個程式碼庫丟給模型,Spark 集群的讀速會直接改變體驗;如果多半是自己跟模型長談,Mac 的省事安靜更實在。