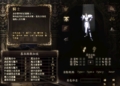

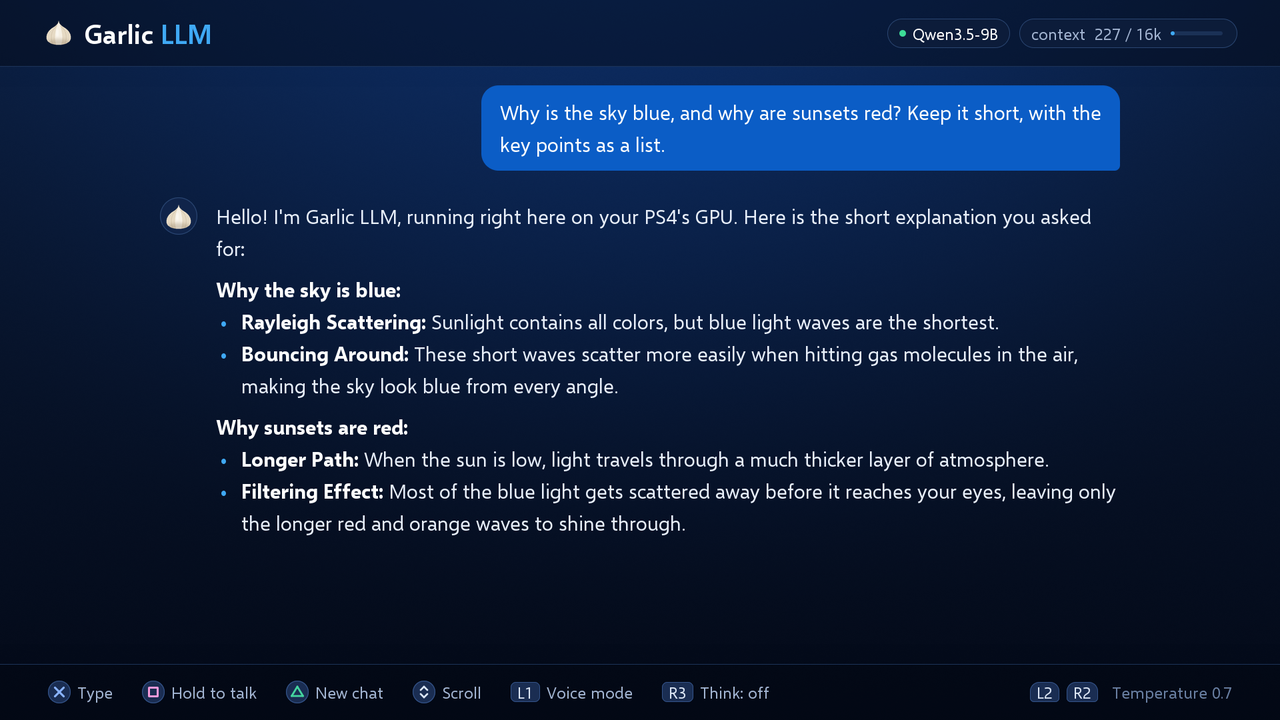
不只是 PlayStation 5,沒想到連已經推出超過 10 年的 PlayStation 4,也能變身成 AI 伺服器,最近就有開發者做到這件事情,並將其分享到 GitHub 上,名稱叫 Garlic LLM,由 Leonardo Alegría 打造,讓 PS4 可以在主機上直接執行阿里巴巴擁有 90 億參數的 Qwen 3.5-9B 模型。而且整個過程完全離線、不需要另外接電腦,文字生成速度最高可達每秒 43 Tokens。
圖片來源:Garlic LLM
13 年前的 PS4 也能跑 AI!開源 Garlic LLM 讓破解主機離線執行 90 億參數模型,每秒最高 43 Tokens
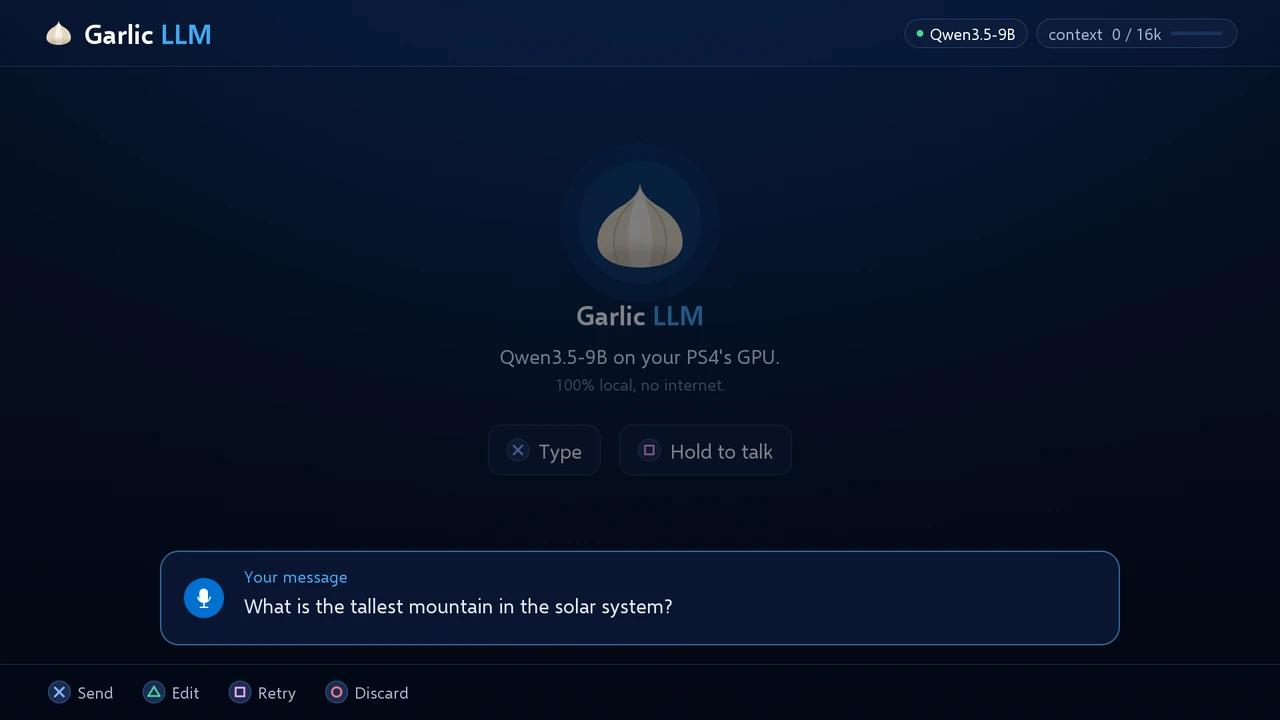
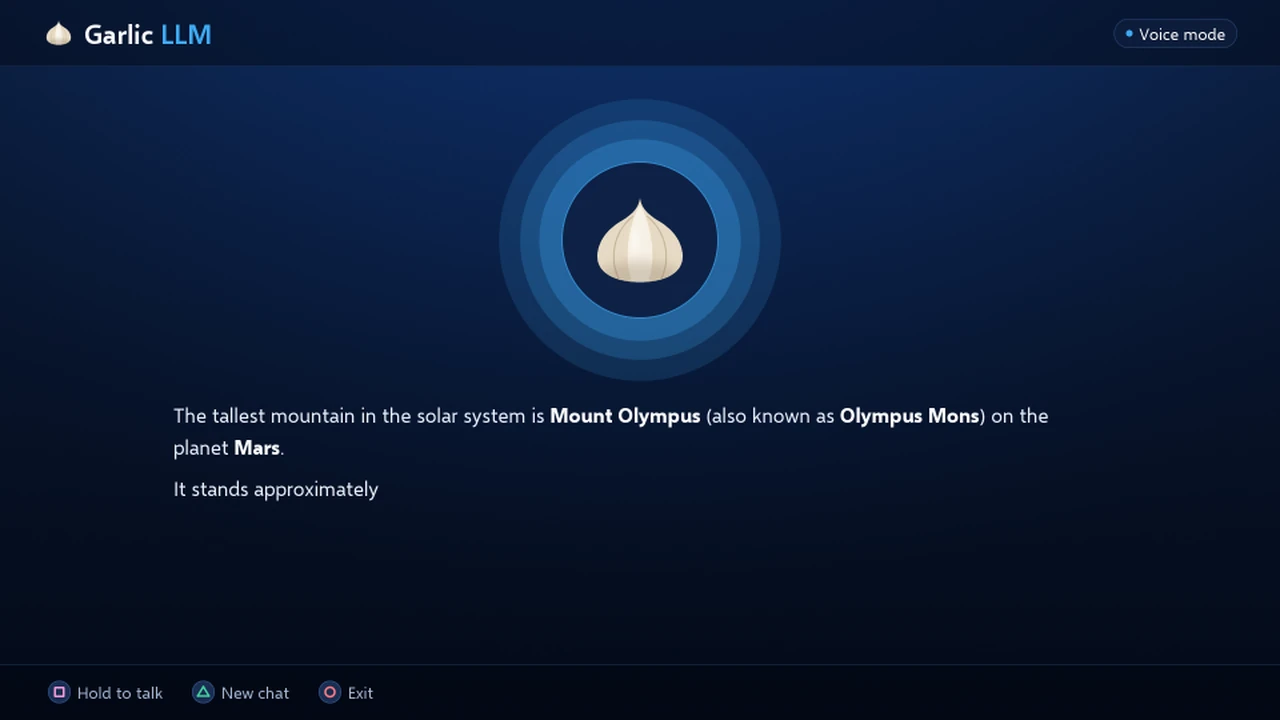
根據外媒 Tom’s Hardware 報導,在 GitHub 上出現一個 Garlic LLM 的專案,是專為 PS4 所設計的 AI 軟體,內建阿里巴巴今年推出的開放權重模型 Qwen3.5-9B,所有運算都是透過 PS4 的 GPU 處理。根據開發者在 GitHub 公布的數據,在初代與 Slim 版 PS4 上,一般文字聊天速度落在每秒 31~39 Tokens,生成程式碼時最高到每秒 43 Tokens;切換到語音對話模式則降到每秒約 22 Tokens。
不過要注意的是,這些速度數據都來自開發者本人,沒有說明測試用的提示詞與量測方法,目前也還不是獨立、標準化的效能測試,當參考就好。
圖片來源:Garlic LLM
PS4 只有搭載 8GB GDDR5 記憶體,採 CPU 與 GPU 共用的統一記憶體架構,系統本身也會用掉一部分,代表說能用的更少,那它是如何做到成功運行 Qwen3.5-9B?基本上有三招。
第一招是量化,Garlic LLM 大部分權重用 4-bit(Q4),每一層中最大的兩組矩陣再壓到 3-bit(Q3,加上縮放係數約 3.5 bits),混合下來模型約 4.5GiB,比全部用 4-bit 的約 4.9GiB 再省一點。負責記住對話內容的快取也壓成 4-bit,進一步降低記憶體需求,因此上下文長度變成只有 16K Tokens。
另外還有語音辨識模型 0.33GiB、兩個語音合成模型 0.29GiB 與 0.09GiB,總計約 5.23GiB。
圖片來源:Garlic LLM
第二招是直接跟 GPU 溝通,它沒有使用 PC 上常見的 llama.cpp,也不是 Vulkan 移植版,而是跳過 GPU 驅動程式。
開發者用 OpenCL C 寫了專用的計算核心,再透過 LLVM 編譯給 PS4 那顆 AMD GCN 架構 GPU 執行。每生成一個 Token,程式都會自己組出一份 PM4 指令緩衝區。CPU 端則是用純 C 處理分詞、介面、文字繪製與音訊。
最後一招是 MTP 推測解碼。Qwen3.5 本身帶有多 Token 預測(MTP)模組,可以先一次猜最多兩個 Token,再交給完整模型一起驗證,猜對就等於一次產出多個 Token。這個設定也和阿里巴巴建議在 vLLM 使用 2 個推測 Token 的做法一樣。
下方是 Garlic LLM 的主要特點表格:
| 功能 | 特色 |
|---|---|
| AI 文字聊天 | 使用 Qwen3.5-9B 回答問題,支援 16K Tokens 上下文 |
| 語音對話 | 透過 Chatterbox 語音模型,支援西班牙文、英文、葡萄牙文、俄文、義大利文、法文、德文 7 種語言語音回覆 |
| 語音轉文字 | 按住手把按鍵就能口述輸入,使用 NVIDIA 的 Parakeet TDT 0.6B v3,支援 25 種歐洲語言 |
| Python 模式 | 由 AI 撰寫 MicroPython 程式,並直接在 PS4 上執行 |
| Think 模式 | 開啟額外推理過程處理較複雜的問題,預設關閉,每次思考約需半分鐘 |
對於有興趣玩玩的人,要注意的是,它沒辦法直接在 PS4 上安裝,PS4 必須先裝好 GoldHEN,這是一套給已破解 PS4 使用的自製軟體啟用工具。
開發者特別強調,App 本身不含任何破解漏洞程式,GoldHEN 要由使用者自行安裝、風險自負,專案也與 Sony 沒有任何關係。
安裝方面,整合安裝檔約 5.7GB,已經包含所有 AI 模型,可以從 Hugging Face 下載,開啟除錯設定後透過 PS4 的 Package Installer 安裝。主機需要約 6GB 的可用空間,如果先把安裝檔複製到主機內建硬碟再安裝,則需要約 12GB。如果要用語音功能,還需要準備一支主機認得的麥克風。
相容性方面,開發者最初是在韌體 11.52 的初代與 Slim 版 PS4 上進行測試,不過目前已有其他玩家回報成功運行,包括 PS4 Pro 在韌體 9.00、11.00 和 12.02 上也能使用,最高速度可達每秒 45 Tokens。
想在 PS5 上玩的人,另一個 PS5LM 更推薦,直接用 llama.cpp 執行,速度可以突破每秒 100 Tokens。如果是運行約三倍大的 Qwen 270 億參數模型,則是每秒約 20 Tokens。