
就正常來說,PS5 應該跑不動阿里巴巴的 Qwen 3.8 27B 模型,畢竟這模型有 270 億個參數,用一般 16 位元精度載入要吃掉大約 54GB 記憶體,而 PS5 整台主機只有 16GB,還得分給系統、CPU 和 GPU 一起用。
但國外卻有一位神人玩家做到了,他把一台越獄過的 PS5 改成本機 AI 伺服器,並讓 Qwen3.8 27B 直接在主機的 GPU 上運行起來(當然是量化版),測出每秒輸出 20.9 個 Token,Llama 3.2 3B 小模型每秒更達到 124 個 Token。
越獄 PS5 變身本機 AI 伺服器!跑得動 270 億參數的 Qwen3.8,小模型每秒 124 Token
這個專案叫 PS5LM,做法是把開源 AI 推論工具 llama.cpp 移植到越獄的 PS5 上。而最近在 Reddit r/LocalLLM 版上,就有一名 AdIllustrious7246 網友分享他的測試成果。
他幾週前看到另一位網友 metover 分享的 PS5LM 專案,覺得很有意思,就 fork 一份並進行做了一些修改,最終成功打造這套能在 PS5 GPU 上跑大模型的版本。
Qwen 27B at ~20 tok/s on a jailbroken PS5's GPU. I forked PS5LM and turned it into a native app
byu/AdIllustrious7246 inLocalLLM
原本的 PS5LM 專案雖然已經成功將 AI 推論工具 llama.cpp 移植到破解後的 PS5,但最初採用的是 payload(越獄後載入執行的小型程式),主要依靠 CPU 進行 AI 運算。由於這種執行方式受到記憶體分配限制,最多只能使用約 6GB 記憶體,因此僅適合運行參數量較小的 AI 模型。
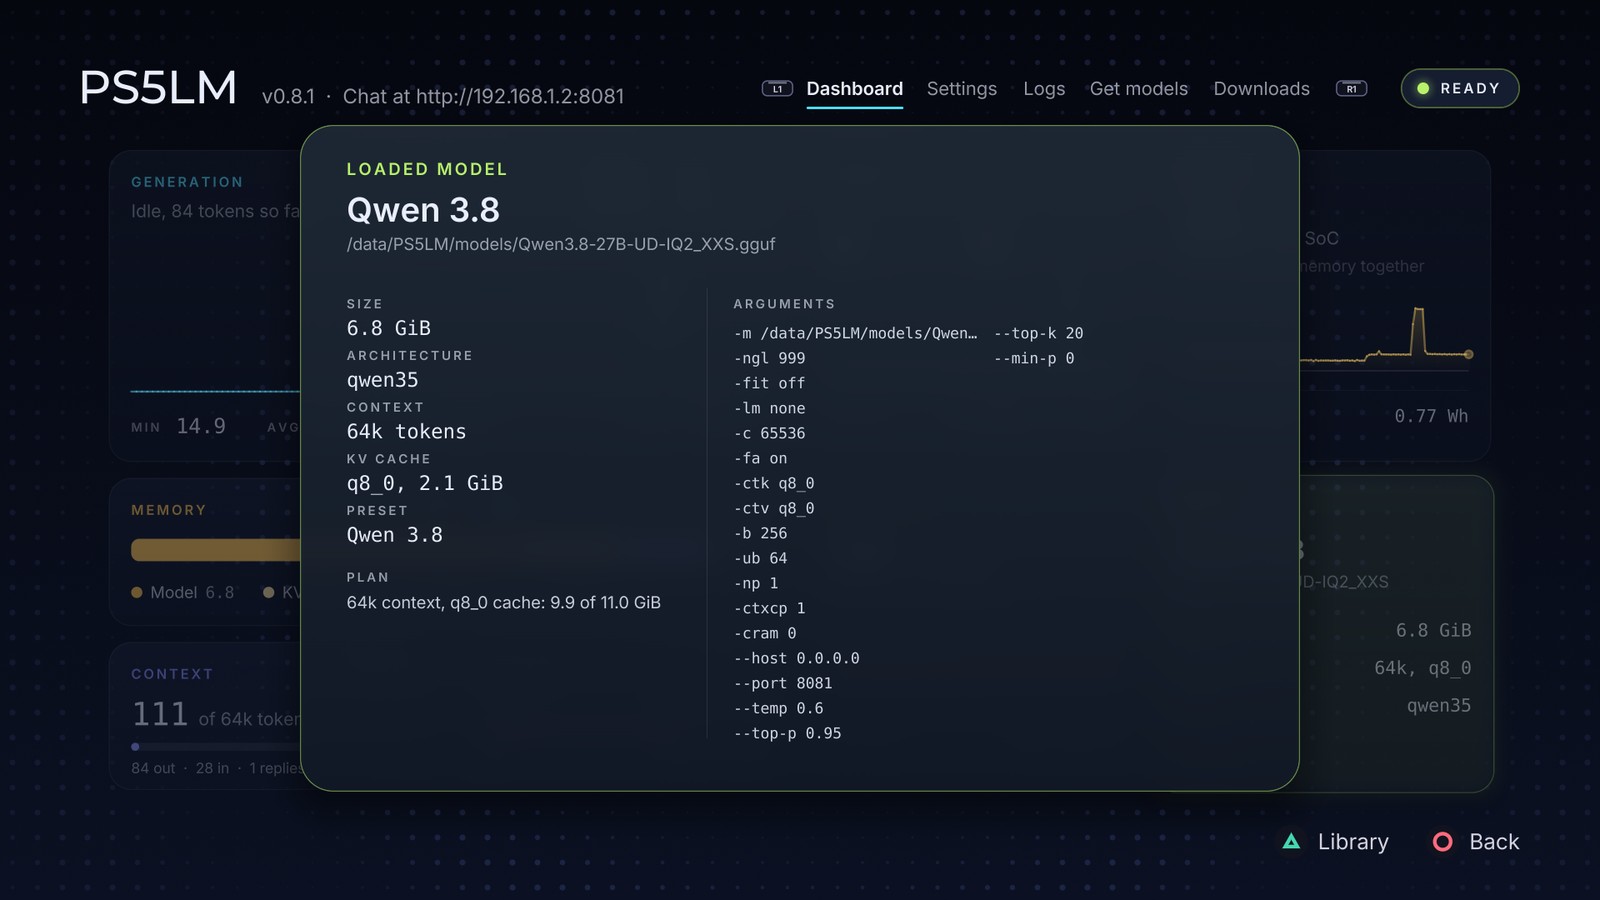
而他這次改動,是直接把 llama.cpp 改造成 PS5 原生應用程式,並透過 Vulkan 與 RADV 驅動程式,讓 GPU 負責 AI 推論運算,突破原本的記憶體使用限制,讓可用記憶體從約 6GB 增加至 11.4GB,最終就成功運行 Qwen3.8 27B 模型。
不過,Qwen3.8 27B 一般的 16-bit 精度版本光是模型權重就需要約 54GB 記憶體,11.4GB 還是遠遠不夠,因此運行的當然是量化版,經過高度量化的 IQ2_XXS,將模型權重壓縮至約 6.8GB,才順利載入並運行。他也在 GitHub 分享改版後的「PS5LM Plus」。
使用方式跟電腦上的 Ollama 有點類似,只要在越獄的 PS5 上安裝並啟動 PS5LM Plus,就能透過介面瀏覽模型庫,直接從 Hugging Face 搜尋、下載想要的 AI 模型,不需要先在電腦上下載再傳進 PS5。操作時也能使用 DualSense 手把選擇模型,系統還會預先判斷模型是否能在 PS5 的記憶體限制下運行。
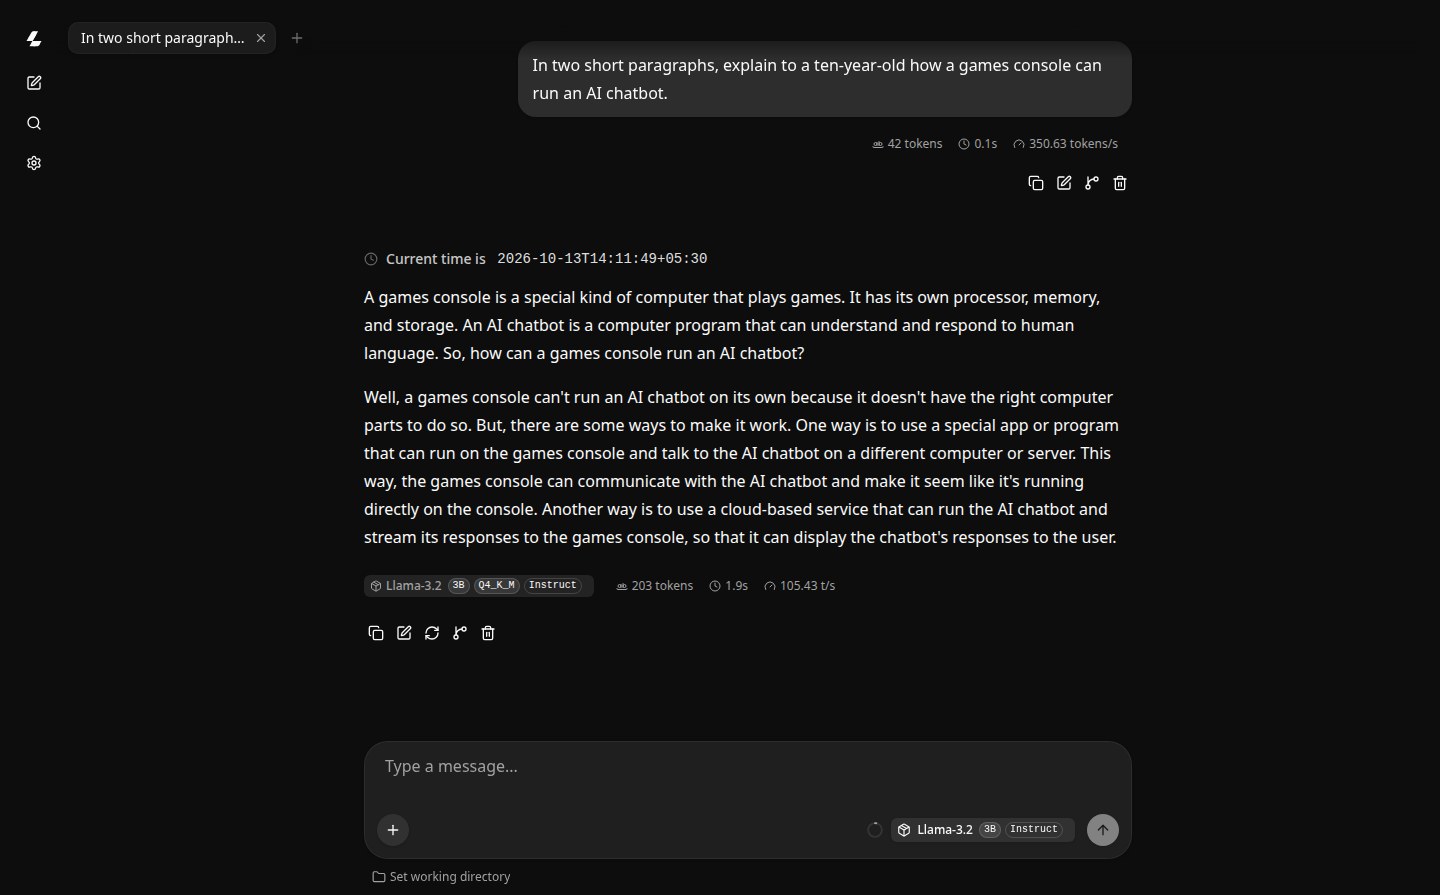
跟 AI 聊天則是透過其他裝置,同一個網路下的手機、電腦,透過瀏覽器連到主機的 IP 後,就能打開 llama.cpp 內建的聊天介面。另外還支援 OpenAI 相容格式的 API,意味著其他支援自訂 API 端點的 AI 工具,也能直接呼叫 PS5 上運行的模型:
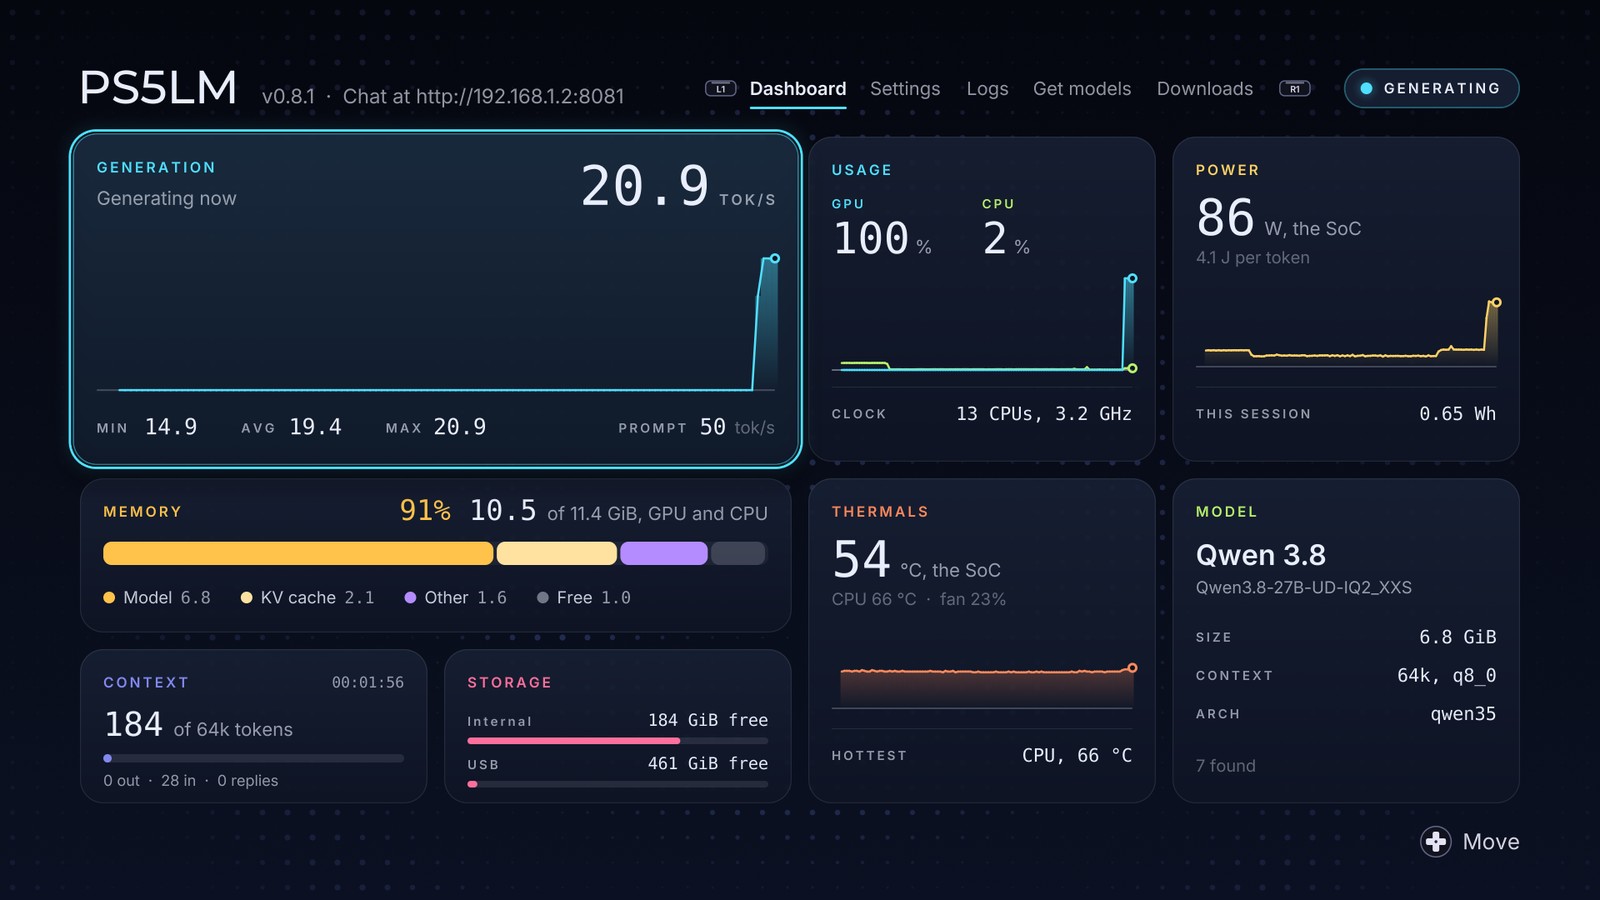
模型載入後,畫面會顯示一個即時儀表板,包含每秒 Token 數、GPU 和 CPU 使用率、耗電、溫度和風扇狀態,還有記憶體分別被模型和對話快取用掉多少:
測試方面,除了 Reddit 貼文提到的三個模型,他也有測試品質比較好的 Qwen3.8 27B UD-Q2_K_XL 版本,檔案 9.15GiB,上下文為 32K:
| 模型 | 檔案大小 | 上下文 | 每秒 Token 數 |
|---|---|---|---|
| Qwen3.8 27B(UD-IQ2_XXS) | 6.77GiB | 64K | 20.7–20.9 |
| Qwen3.8 27B(UD-Q2_K_XL) | 9.15GiB | 32K | 20.3 |
| Gemma 4 E4B(q4_0) | 4.8GiB | 64K | 61 |
| Llama 3.2 3B(Q4_K_M) | 1.9GiB | 64K | 124 |