2026 年 11 月 11 日凌晨,MiniMax 在 X 上宣布圖像生成模型 MiniMax H3-Image 開放權重。官方貼文主打三個數字:4096 x 4096、約 1,600 萬畫素的輸出,10 秒的生成時間,以及最多 16 張參考圖;使用管道包括自家 API、MiniMax Code 與海螺 AI,首週 16MP 以上規格的生成請求五折。
H3-Image 是 MiniMax-H3 家族的衍生作品,把文字生圖與圖像編輯收在同一個 checkpoint 裡,權重已在 Hugging Face 上架,transformer 與 VAE 合計約 68.65 GB。MiniMax 在後訓練階段強化了資料、強化學習、步數壓縮、提示詞擴展與部署最佳化,並自稱速度可達市面上主流水準的 5 倍。
4K image generation in 10 seconds! ⚡ Meet MiniMax H3-Image. 16 million pixel resolution. Stunning realism. Precise prompt following & editing. Up to 16 reference images. All in 10 seconds. And it’s open-weight. 🚀 Available now via our API, MiniMax Code, and Hailuo AI — with 50% off 16MP+ generations during launch week! Can’t wait to see what you create. 🔥 Hugging Face: https://t.co/bpbJAIvXg0 API: https://t.co/avbsq6GAcM MiniMax Code: https://t.co/GmxLmDurCL
— MiniMax (official) (@MiniMax_AI) November 10, 2026
架構:33.1B 的 DiT,蒸餾到六步
MiniMax 的模型卡寫得很細。H3-Image 的擴散 transformer 是 33.1B 參數的稠密單流架構,50 層、hidden size 5,376、56 個注意力頭、FFN 寬度 14,336,採用 3D 多模態 RoPE,與 H3-Omni-Transformer 同款,只是把音訊分支拿掉。
文字編碼器直接沿用 MiniMax-H3 的完整 Qwen3-VL,沒有改動,DiT 讀取它第 50 層的 hidden states;圖像 VAE 是 CNN 編碼器搭配 24 層 2D ViT 解碼器,16 倍空間下採樣、24 個 latent channel,DiT 再以 2×2 patch 切分 latent,換算下來每個 transformer token 對應 32×32 像素。
速度的來源是蒸餾。這個 checkpoint 被壓到 6 個取樣步(6 NFEs),完全不使用 classifier-free guidance。這不是使用者可以調的預設值:官方 API 只要收到 num_inference_steps 不等於 6、或 guidance_scale 不等於 1,一律回 HTTP 400,負面提示詞也直接拒收。[4]
尺寸與參考圖
輸出在任何長寬比下都做到約 1,600 萬畫素,而且不經過額外的放大模型:1:1 是 4096 x 4096,4:3 是 4736 x 3552,3:2 是 5024 x 3360,16:9 是 5472 x 3072,21:9 是 6272 x 2688。模型卡描述的實用區間約在 4MP 到 20MP 之間,API 端把輸出總面積上限設在 2,000 萬畫素。
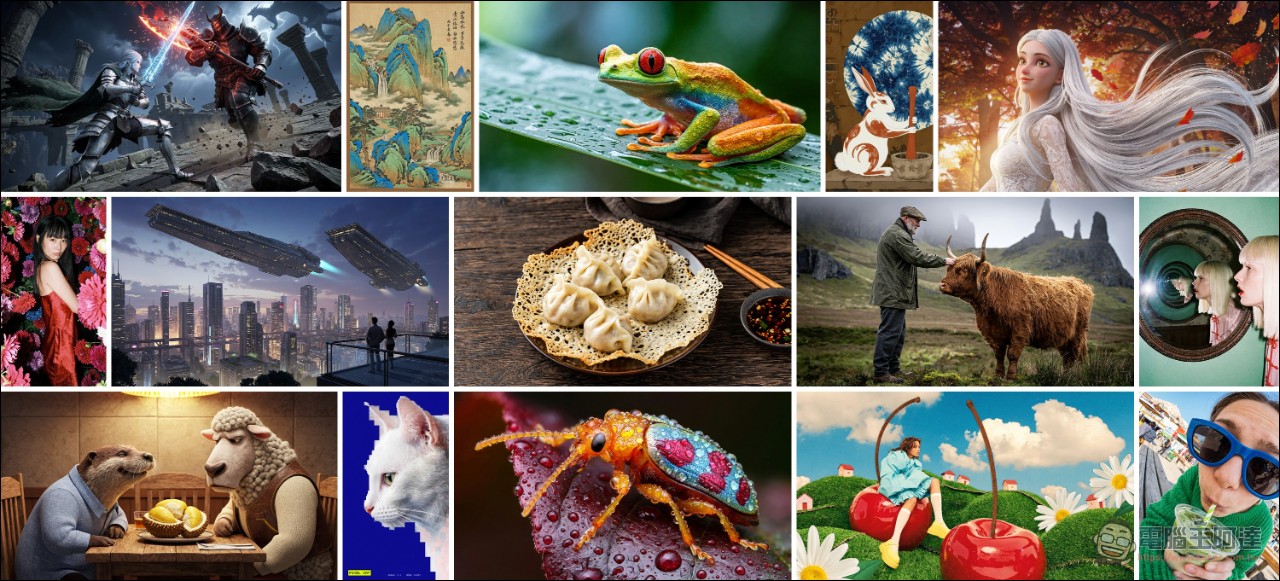
編輯模式最多吃 16 張參考圖,在提示詞裡以 <Picture 1> 到 <Picture 16> 依上傳順序定位。提示詞長度上限 32,000 字元,但關閉提示詞增強時只有前面約 4,096 個 token 會生效。API 另有一個名為 MiniMax-H3-Image-Highspeed 的高速版本,參數與限制完全相同,只是計價較高。
部署生態:四套框架,第一天就到位
以一款剛上線的 checkpoint 來說,H3-Image 的框架支援算是少見地完整,而且是第一天就到位。SGLang 是官方示範的參考路徑,附 cookbook 與單卡啟動指令;vLLM-Omni 提供各硬體的部署配方,點名的加速器包括 NVIDIA H200、RTX PRO 6000 Blackwell 與 AMD Instinct MI350X;diffusers 與 ComfyUI 也都支援。要壓低延遲可以把單一請求拆到多張 GPU,SGLang 用 --ulysses-degree、vLLM-Omni 用 --usp。
不過模型卡與 API 文件都寫參考圖上限 16 張,但 vLLM-Omni 第一天的配方只示範到 9 張。另外模型倉庫裡還有一個選配的提示詞擴展模型 MiniMax-H3-Image-PE,採 NVFP4 精度、17.9 GB,可以本地部署,用來把短提示詞擴寫成模型偏好的詳細英文描述。
發表節奏:先上架,再宣布
這次的發布順序跟多數模型相反。Hugging Face 上的模型倉庫在 11 月 3 日建立,但一直是空的;權重在 11 月 10 日 14:50 UTC 才上傳。同一天,MiniMax 的 API 文件多了一張標題為 MiniMax H3 Image 的更新卡,內容只有一句「領先的開放權重圖像模型,從想法到新世界」,沒有規格;而公司自己的部落格與新聞索引到現在都沒有關於這款圖像模型的文章。
價格方面,標準方案按 token 計費,輸入文字每百萬 token 2.30 美元(約 NT$74.75),輸入圖像每百萬 token 1.50 美元(約 NT$48.75),輸出圖像每百萬 token 3.80 美元(約 NT$123.50)。換算成單張:1K 生圖約 0.022 美元(約 NT$0.71),2K 約 0.023 美元(約 NT$0.76),4K 列表價 0.069 美元(約 NT$2.24),折扣後 0.034 美元(約 NT$1.12)。編輯方面,4K 加一張參考圖列表價 0.073 美元(約 NT$2.38),折扣後 0.037 美元(約 NT$1.19);4K 加三張參考圖列表價 0.079 美元(約 NT$2.57),折扣後 0.040 美元(約 NT$1.29)。
畫素多 16 倍、價格只多 3 倍多,是這次發表在成本結構上最有辨識度的地方。以 4K 列表價比較,這個開放權重 checkpoint 大約是 FLUX 3 Image 4K 的八分之一、Nano Banana 2.1 4K 的五分之一。
「開放權重」不等於全球開源
權重可以下載、架構有文件,這已經比多數前沿圖像模型開放。但授權條款才是決定能不能用的那一關。H3-Image 採用 MiniMax-H3-Image Community License Agreement,排除地區涵蓋歐盟、英國、韓國與美國;年化營收超過 100 萬美元(約 NT$3,250 萬)需要事先取得書面授權;把模型做成託管服務同樣需要授權,而且沒有營收門檻;商業介面必須顯著標示模型名稱;輸出不得用來訓練或改進其他模型。Hugging Face 頁面把這一切簡化成一行 license: other。
結語
MiniMax H3-Image 值得注意的地方有兩層。技術面上,把一個 33.1B 的稠密 DiT 蒸餾到六步無引導取樣,並讓 1,600 萬畫素的輸出不需要放大模型,是讓 4K 生成變成「一次請求」而不是「批次工作」的關鍵。商業面上,它把 4K 圖像的單張成本壓到 0.069 美元(約 NT$2.24)這個量級。另外 68.65 GB 的權重之外還要從 MiniMax-H3 拉 66.7 GB 的文字編碼器,本機第一次生成要下載約 135 GB;有能力部屬的人的人使用時要稍微注意一下。