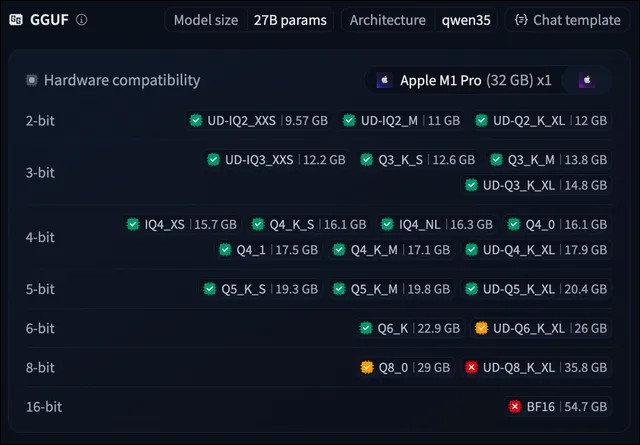
有在玩本地模型的人應該都有一種迷思:「模型量化程度越低越聰明」,大家普遍的認知是原版(BF16)智力肯定比量化過的版本好,但近日量化社群名人 Piotr Migdał 在 Quesma 部落格發表的大型實測:把 Qwen3.6-27B 的 24 種 GGUF 量化版本全部測了一遍,檔案從 9.6GB(UD-IQ2_XXS)到 54.7GB(BF16 原版),用自家 MacBook Pro M5 Max 跑 37 小時生成 390 萬 token,再加上雲端 GPU 再燒掉 1,430 美元(約新台幣 4.6 萬元)得出的結論可能會出乎你的意料之外。
先搞懂四大量化門派
測試開始前,文章先解說了當前常見的幾種量化格式。日常最常見的「K 系」是 llama.cpp 的預設款,檔名後綴 _S/_M/_L/_XL 代表保留高精度張量的多寡(保守程度),Q4_K_M 實際精度約當 4.6 位元,內部不少張量是 6 甚至 8 位元,「不能理解成全部張量都是 4 位元」。「IQ 系」用重要性矩陣把精度花在刀刃上,同體積通常比 K 系聰明;「老古董」Q4_0、Q4_1 只會四捨五入;最受推崇的是 Unsloth 團隊的「UD」(Unsloth Dynamic)動態量化,自動找出對壓縮最敏感的張量多給幾位元,精度最貼近原版。浮點陣營的 FP8 幾乎等於原版,NVFP4 則是 NVIDIA 自家的 4 位元浮點方案。如果不知道選哪種量化格式的話,內文建議的順序很簡單:有 UD 選 UD,沒有 UD 看 IQ,再來是 Q4_K_M,要注意的是每種量化格式的檔案大小差距也很大。
KL 散度:比位元數可靠 100 倍的指標
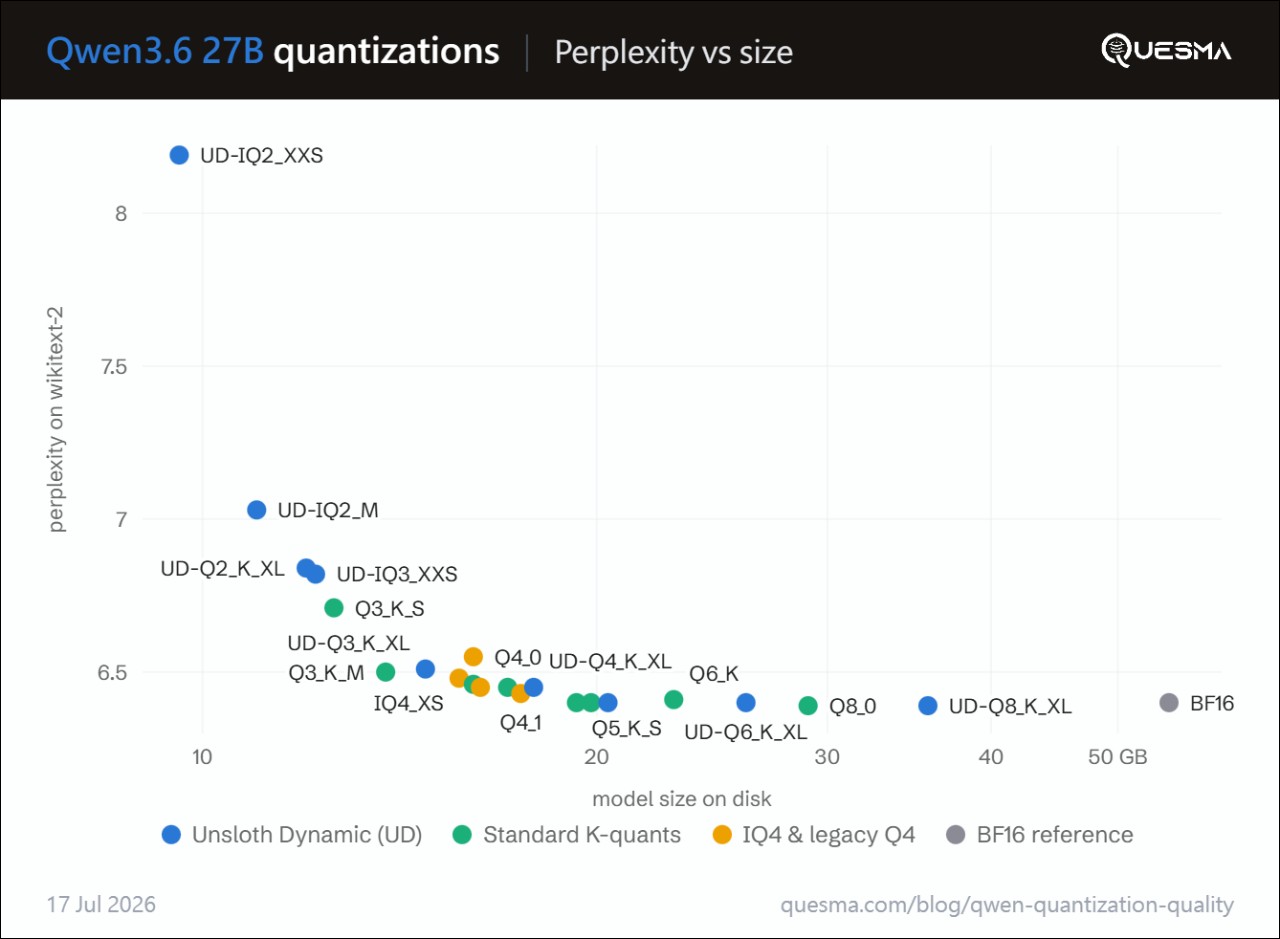
接著就是談到一些你可能聽過但不瞭解意義的數值代表的是什麼,如困惑度(perplexity,越低越好),BF16 原版是 6.40,Q4_K_M 是 6.45,「基本上可以算是同一個模型」;所有 Q3_KM 以上的量化都擠在 6.39 到 6.5 之間。再往下才開始鬆動:Q3_K_S:6.7、Q2:7.0、IQ2_XXS:8.19。
但作者給了更實用的選擇指標:KL 散度(量化版與原版輸出分布的偏離程度)。界線乾淨得出奇:低於 0.05 就貼著滿血版可以閉眼用,高於 0.08 就真的有差距。巧的是,正好落在 0.05 的又是 Q3_K_M,Q3_K_S 一口氣跳到 0.08。
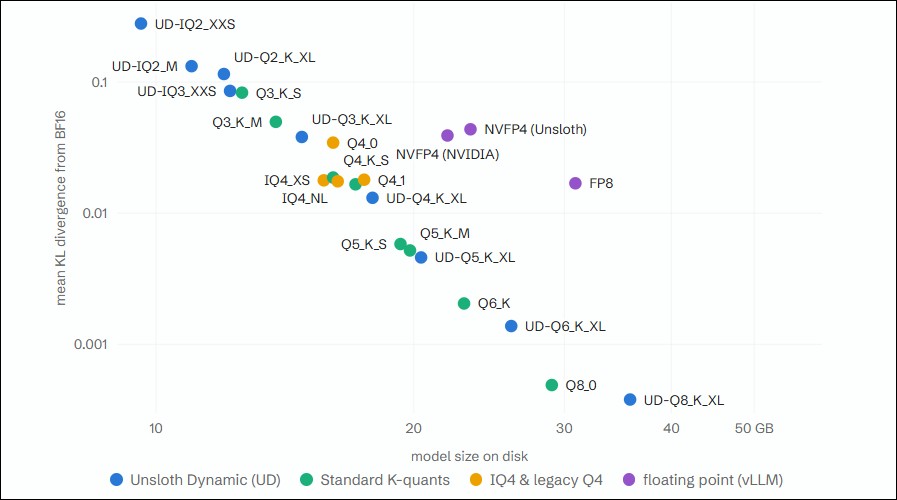
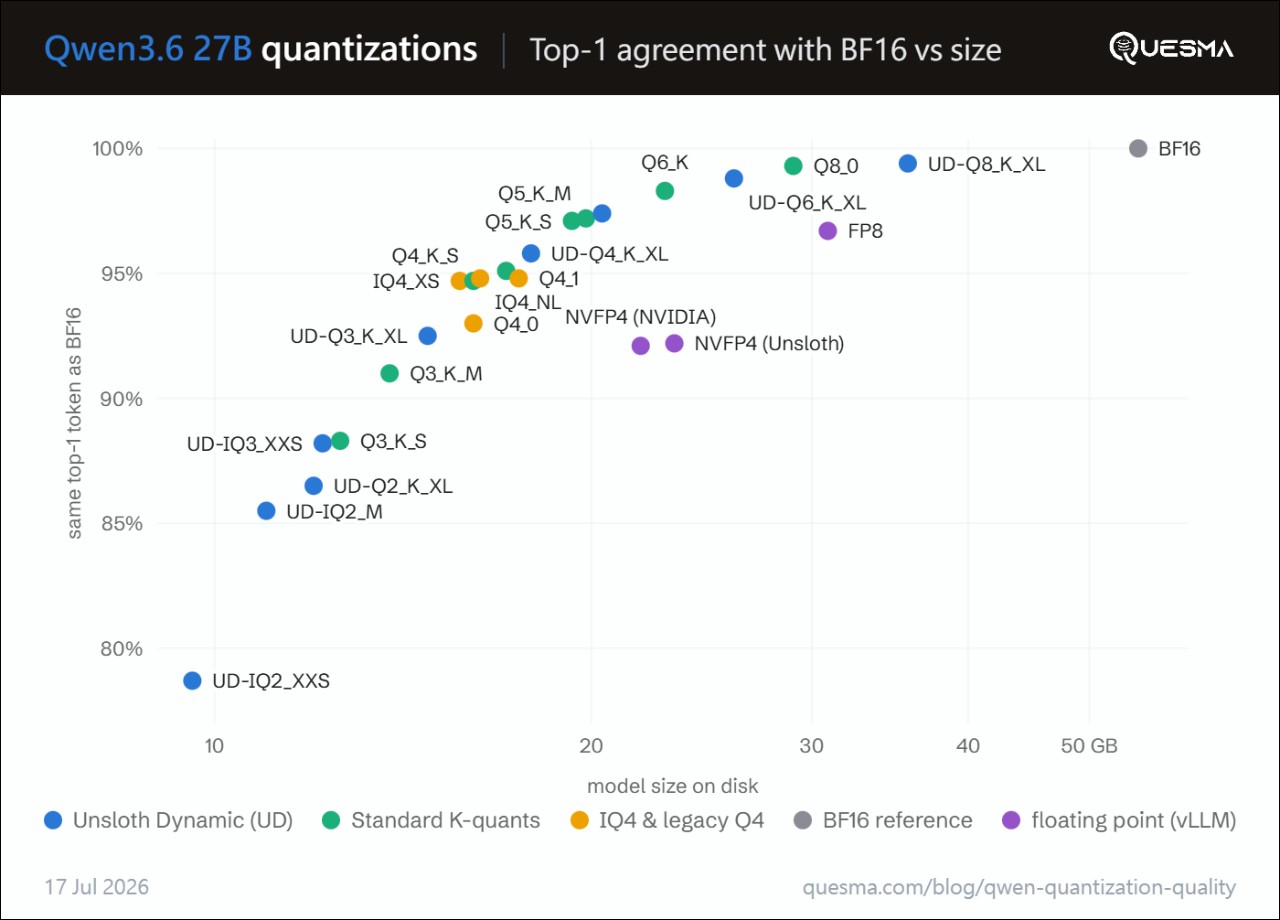
另外兩個指標也值得記:溫度 0 時的 Top-1 一致率,Q8_0 高達 99.3%、Q4_K_M 95.1%(跟原版差約 5%)、Q2 掉到 78.7%。而溫度設 1、同一個模型問兩遍,就連 BF16 跟「自己」也只有 48.5% 的機率選到同一個 token。意思是:輸出不一樣不等於變笨,那叫隨機性。最冤大頭的是 FP8:KL 散度 0.017 跟 Q4_K_M 幾乎一樣,檔案卻 31GB 對 17.1GB,體積近翻倍得到同樣的相似度。
基準測試:懸崖沒來,來的是噪聲
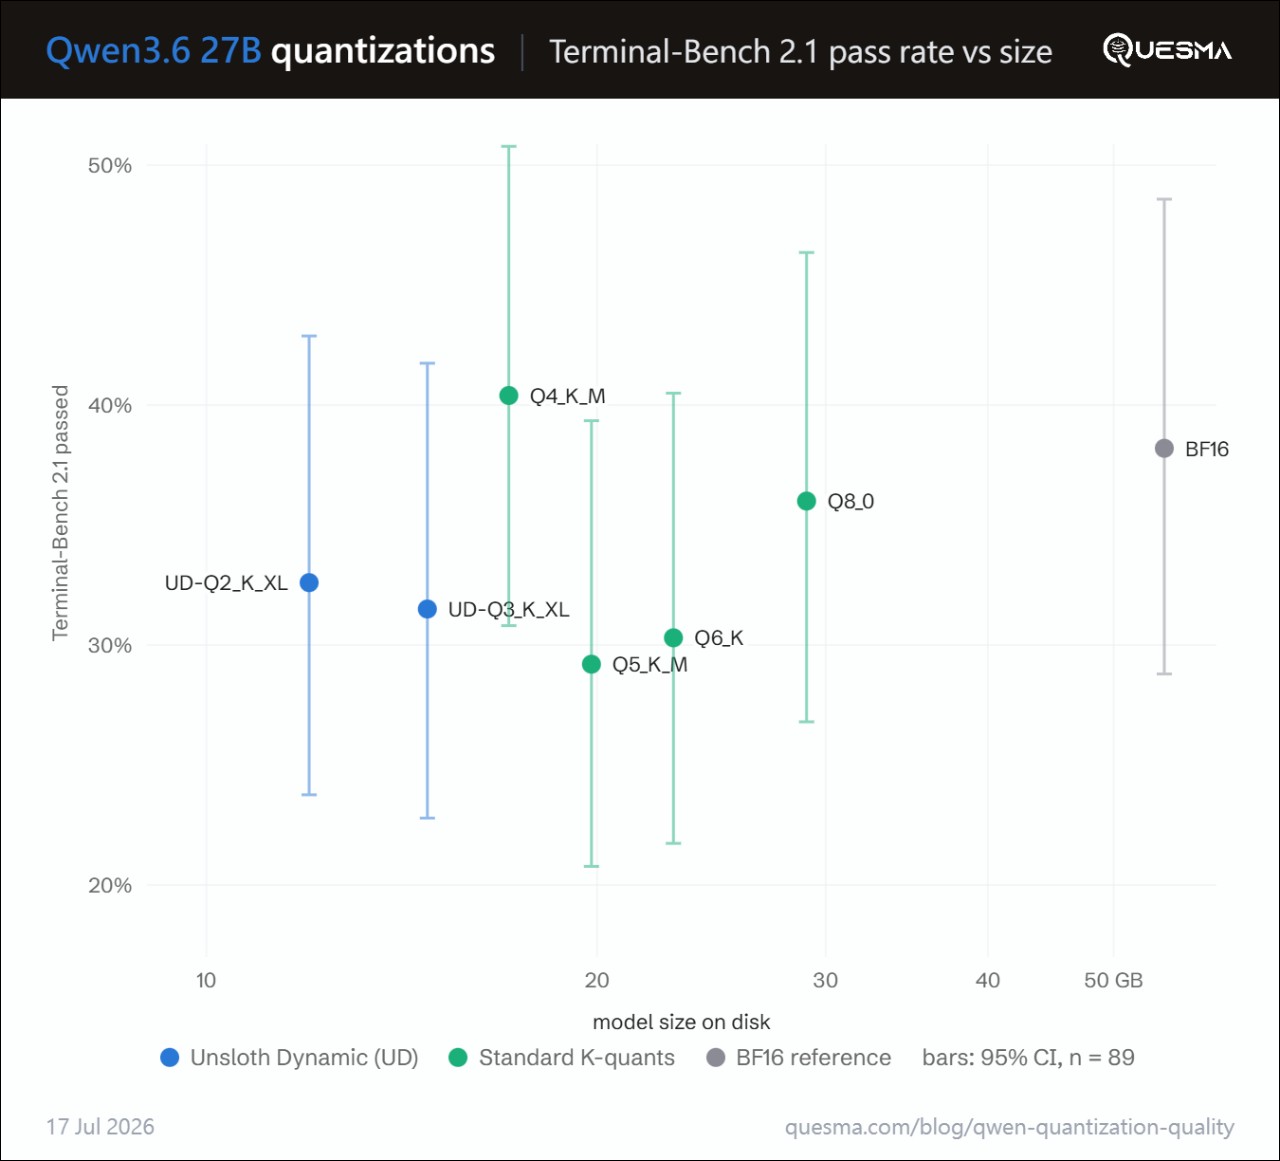
兩份權威測試集的結果更衝擊認知,Terminal-Bench 2.1(89 個真實終端任務,考 AI 程式師動手能力)上,Q4_K_M 通過率 40.4%,甚至比原版還高;Q5_K_M 只有 29.2%,甚至輸給 2 位元。但統計學不留情面:這些差異的 p 值全都不顯著,「本來以為會看到性能懸崖,結果看到的都是噪聲」。換句話說,在 Agent 任務上,從 Q2 到 BF16 都形不成瓶頸。
120 題競賽數學 AIME 才是分水嶺,實驗設定沿用《Quantization Hurts Reasoning?》論文的溫度 0.6(「溫度」可視為創造力)、32K token 上限。BF16 原版解出 70.8%(85 題),UD-Q4_K_XL 一模一樣的 70.8%;Q3_K_M 甚至 73.3% 還高三個百分點(不顯著)。但 2 位元真的翻車:IQ2_XXS 只有 32.5%(39 題,p 小於 0.001 統計顯著),其餘 Q2 也只在 52% 到 57% 之間。作者順手打了個比方:這顆 27B 的 BF16 成績已經接近 2024 年 9 月 OpenAI o1 的 74.4%。
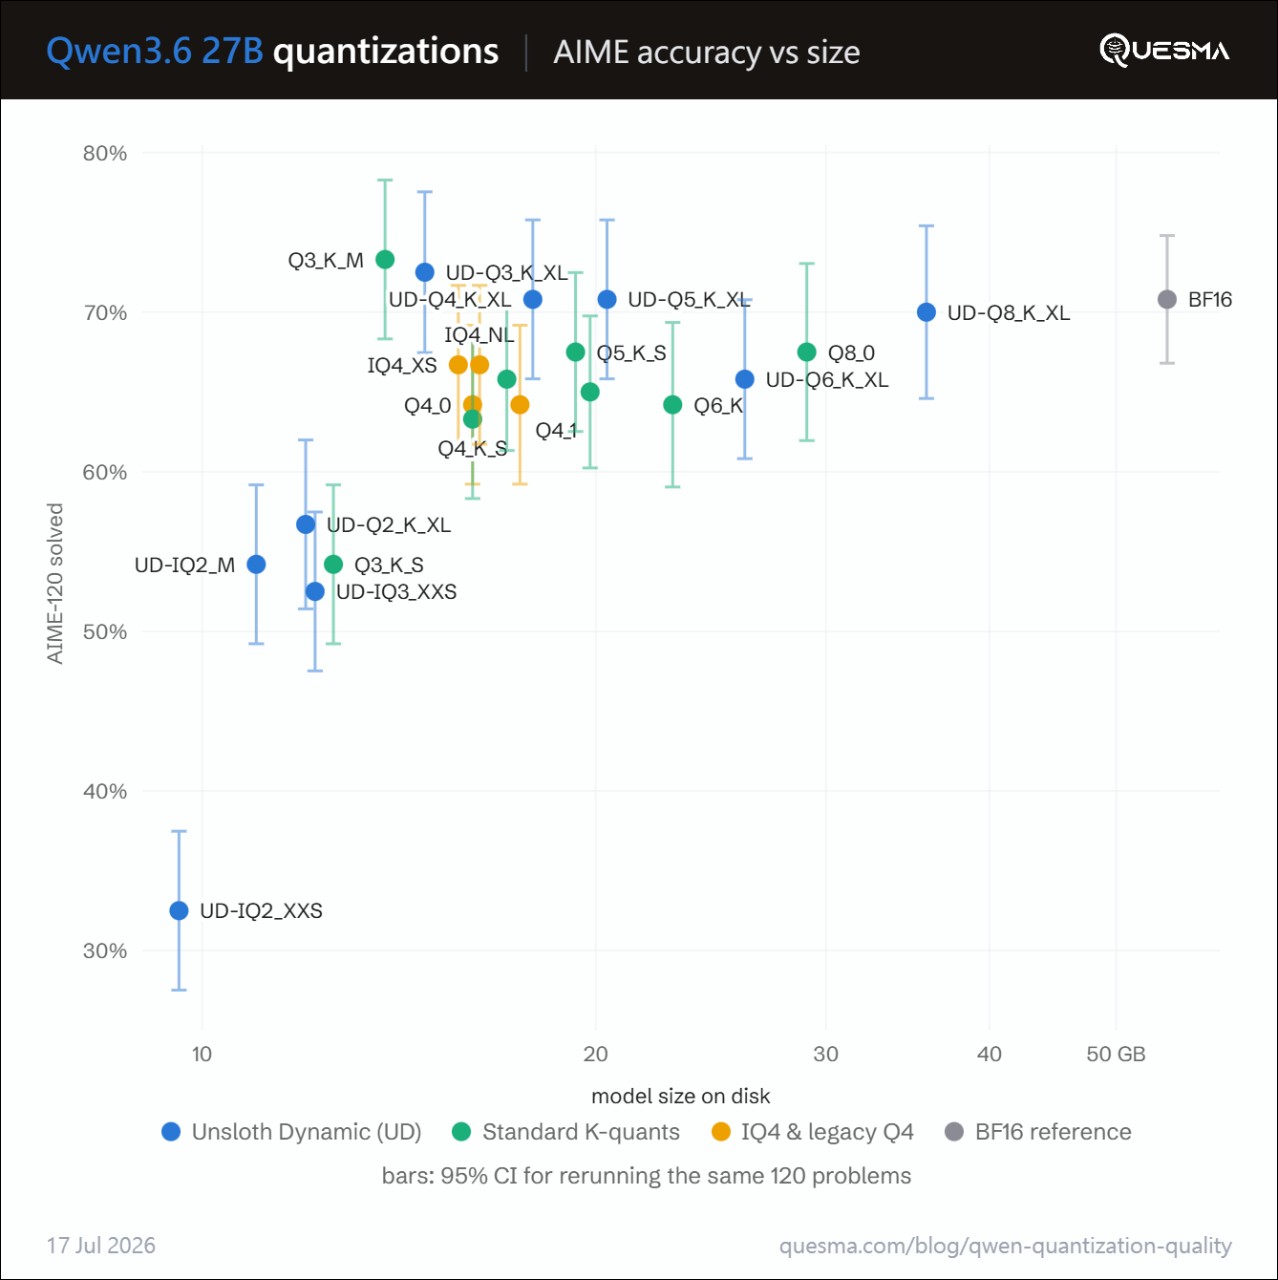
對那些「我用 Q8 明顯感覺比 Q4 聰明」的感覺流說法,測試的結果很直接:權威測試集上兩個模型成績一模一樣,「你的感覺可能是錯的」。
畫鵜鶘盲測:排名完全是亂的
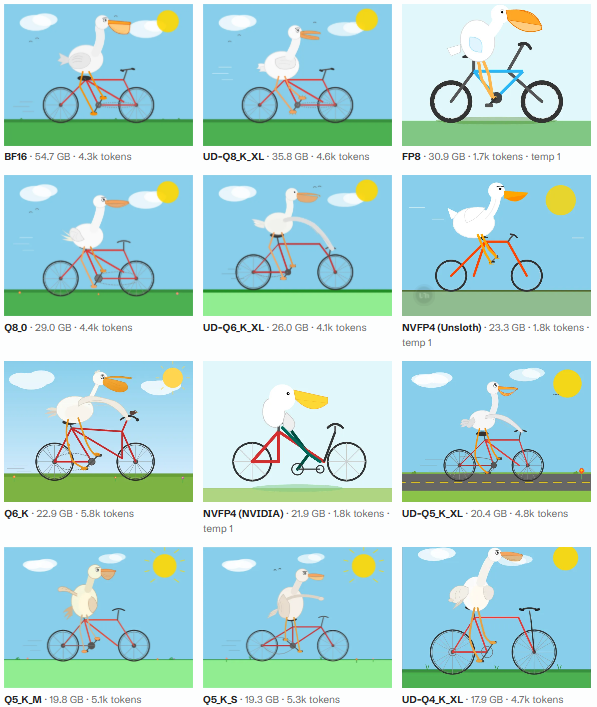
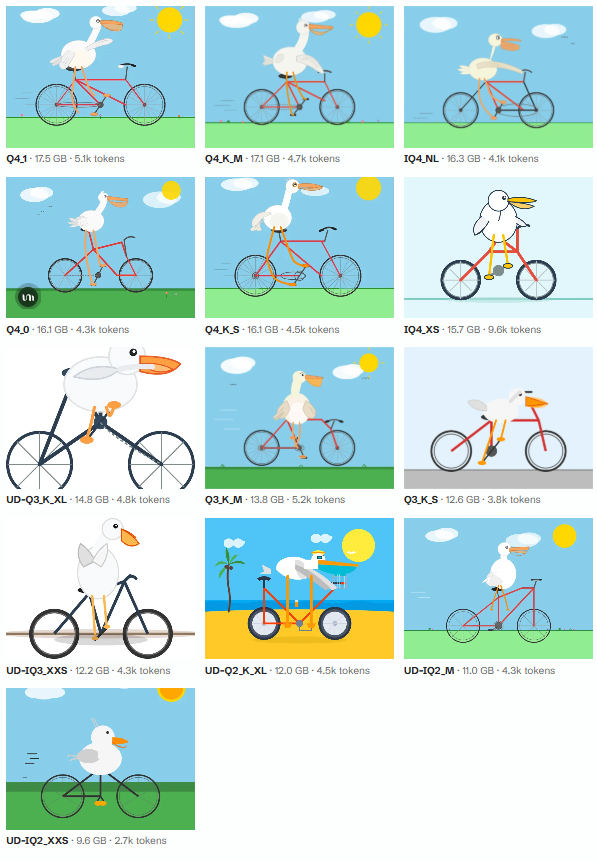
最有娛樂性的是 SVG 盲測:讓每個量化模型畫五張「鵜鶘騎單車」,交給 Gemini 當評委兩兩對決打分,這是社群公認的 SVG 經典基準。結果從滿血到 4 位元的排名完全打亂:Q6_K 拿 +2.54 分,比 BF16 的 +1.76 還高;UD-Q4_K_XL +0.48;唯一明顯掉隊的是 IQ2_XXS(負分)。就連 NVIDIA 宣稱接近原版的 NVFP4(官方版與 Unsloth 版)畫出來都不如 17GB 左右的 Q4_K_M 與 Q4_K_XL。
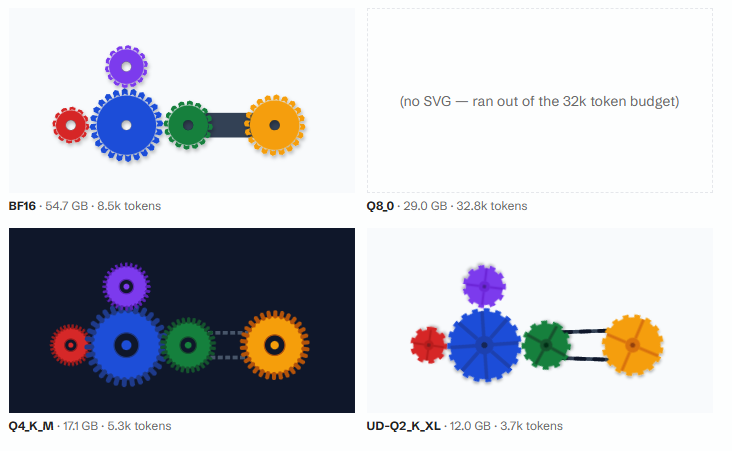
第二關「五齒輪皮帶傳動」更荒謬:滿血版燒光 token 預算沒畫完、Q8_0 直接空輸出(花的 token 是 4 位元的六倍多,過度思考問題),反而 Q4_K_M 畫完而且完成度最穩。
速度迷思:量化買的是記憶體,不是速度
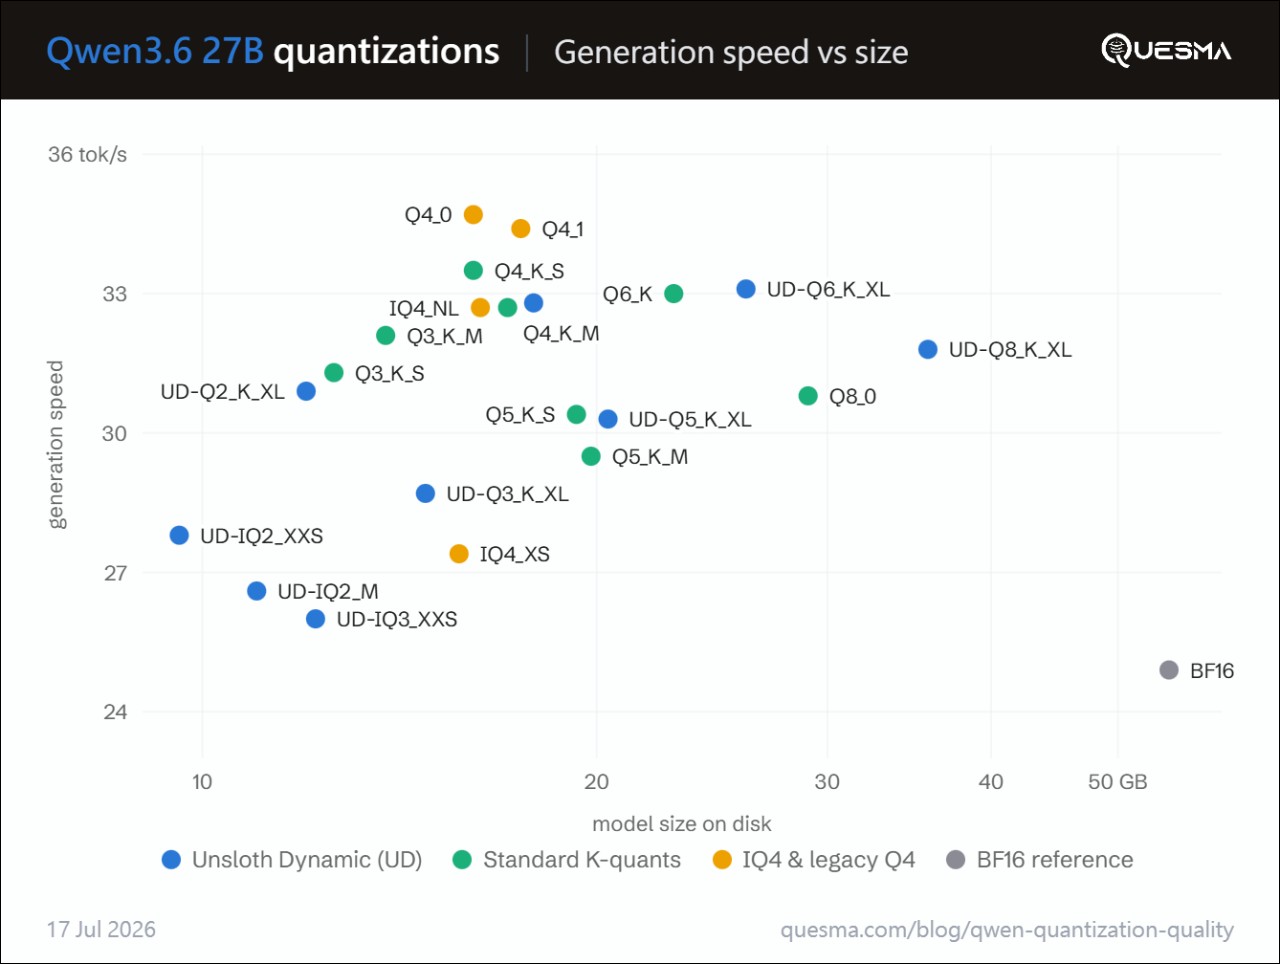
「量化越低跑越快?」實測打臉。M5 Max 上最快的居然是最老的 Q4_0(34.7 token/秒),最慢的 BF16 也有 24.9,24 個版本全擠在 25 到 35 之間:體積差 3.4 倍,速度只差 1.4 倍。原因很物理:磁碟上存的是 2、4 位元,計算時每做一次矩陣乘法都要解包成 16 位元浮點,省下的體積對運算量來說不算什麼。同一個量化在不同硬體上:M5 Max 30 token/秒、NVIDIA L40S 94、H100 112。想提速,掏錢換顯卡;想省記憶體,才看量化。
抄作業清單
- 4 位元以上跟滿血版沒有可感知差別,Q3_K_M 也可以這樣看
- 不想動腦就選 Q4_K_M 或 UD-Q4_K_XL(約 17GB,比原版小 3 倍)
- 記憶體小選 Q3_K_M;Q3_K_S 就別碰了,損失明顯
- 下載前先看 KL 散度,0.05 以下閉眼買
- 2 位元真的會變笨,別硬上(Bonsai 這類非傳統架構的 2 位元方案除外)
- 低量化不等於更快,速度瓶頸在記憶體頻寬與算力
[分析] 你以為的變笨,九成是幻覺
這份測試最顛覆的地方在於把「感覺」和「測量」拆開。困惑度、KL 散度、Top-1、盲測、基準五套證據互相咬合,指向同一個結論:4 位元以上的量化在 27B 這個等級已經是無損壓縮的體感,紅線落在 3 位元中段(Q3_K_S)與 2 位元之間。對跑本地模型的玩家來說,這直接改寫選檔邏輯:與其迷信 Q8、FP8 的「高精度安心感」,不如看一眼 KL 散度,把省下的記憶體拿去裝更大的模型或更長的上下文。
也要留一手:這結論建立在 Qwen3.6-27B 一種架構上,作者自己提醒不同模型反應可能不同;AIME 只有 120 題、Terminal-Bench 只有 89 個任務,誤差棒本來就寬。但至少「量化會把模型變傻」的說法,在這份數據裡是不成立的,甚至有的情況還正好相反。(編按:可是根據我個人測試經驗,不同量化等級模型能力的確會有差,如果搭配後訓練的確會比原本更好,不過 Q4_K_M 的確是比較不會錯的選擇 )