
過去一段時間,Meta 在頂尖 AI 模型的競爭中始終落後於 OpenAI、Anthropic、Google 等對手。從今年 4 月推出 Muse Spark 一路追趕到現在,Meta 終於在稍早端出旗下最強的 Muse Wonder 系列:「Muse Wonder」與更強的「Muse Wonder Full」兩個版本。
Muse Wonder 系列主打的不是聊天,而是能實際幫你把事情做完的 AI 代理,包括新模型會跨對話記住你在意的事,遇到卡關也會換方法繼續做,程式開發能力同樣大幅提升。
跑分方面,多項成績也都超越 Anthropic 的 Claude Fable 5.1 和 OpenAI 的 GPT-6 Astra。
Meta 發表最強 AI 模型 Muse Wonder!主打 AI 代理、長期記憶與程式開發,多項跑分贏過 Claude、GPT-6
Meta 稍早在 Meta AI Research 官方部落格宣布推出 Muse Wonder 系列,包含 Muse Wonder 與 Muse Wonder Full 兩款模型,官方定位是「個人與專業 AI 代理」用的前沿模型,也是 Meta 目前能力最強的模型。
規格部分,根據官方模型卡,Muse Wonder 系列可以輸入文字、圖片、影片與音訊,輸出則是文字,推論時的上下文視窗為 100 萬 Token。
Muse Wonder 是標準版,開放給開發者透過 Meta Model API 付費串接;Muse Wonder Full 則是能力更強的完整版,目前只開放給 Muse Code 訂閱者使用,沒有提供 API。
從跑分來看,兩者的差距不小,Meta 官方比較表裡大部分拿第一的項目,都是 Full 版拿下的。
下方表格是 Meta 公布的比較表,對手包括 OpenAI 的 GPT-6 Astra、Anthropic 的 Claude Fable 5.1 與 Claude Opus 5.5,所有模型都以最高推理強度(max)測試。完整成績如下,粗體為該項最高分:
| 測試項目 | Muse Wonder Full | Muse Wonder | Claude Fable 5.1 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 個人與專業代理 | |||||
| Personal Superintelligence Index(個人與知識工作綜合指數) | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA(法律代理) | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2(金融分析研究) | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro(開放式健康問題) | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA(端到端商業流程) | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf(專業工作) | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench(專業工具使用) | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| OSWorld V2.1(電腦操作,partial/binary) | 78.4/39.4 | 72.6/34.3 | 80.7/43.1 | 75.8/34.3 | 81.8/- |
| MemoryBench(記憶上下文) | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| 程式開發 | |||||
| Terminal-Bench 4.0-AA(終端機代理程式開發) | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1(長時程程式開發) | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon(超長時程軟體工程) | 57.5(xhigh) | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench(從零開始寫程式) | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| 綜合 | |||||
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
程式開發是這次最亮眼的部分。
在長時程的程式開發測試 DeepSWE 1.1 中,Muse Wonder Full 拿到 79.0%,Claude Opus 5.5 是 74.2%、GPT-6 Astra 是 74.1%,三個月前的 Muse Spark 1.1 只有 53.3%,等於 Meta 在這項測試一口氣進步超過 25%:
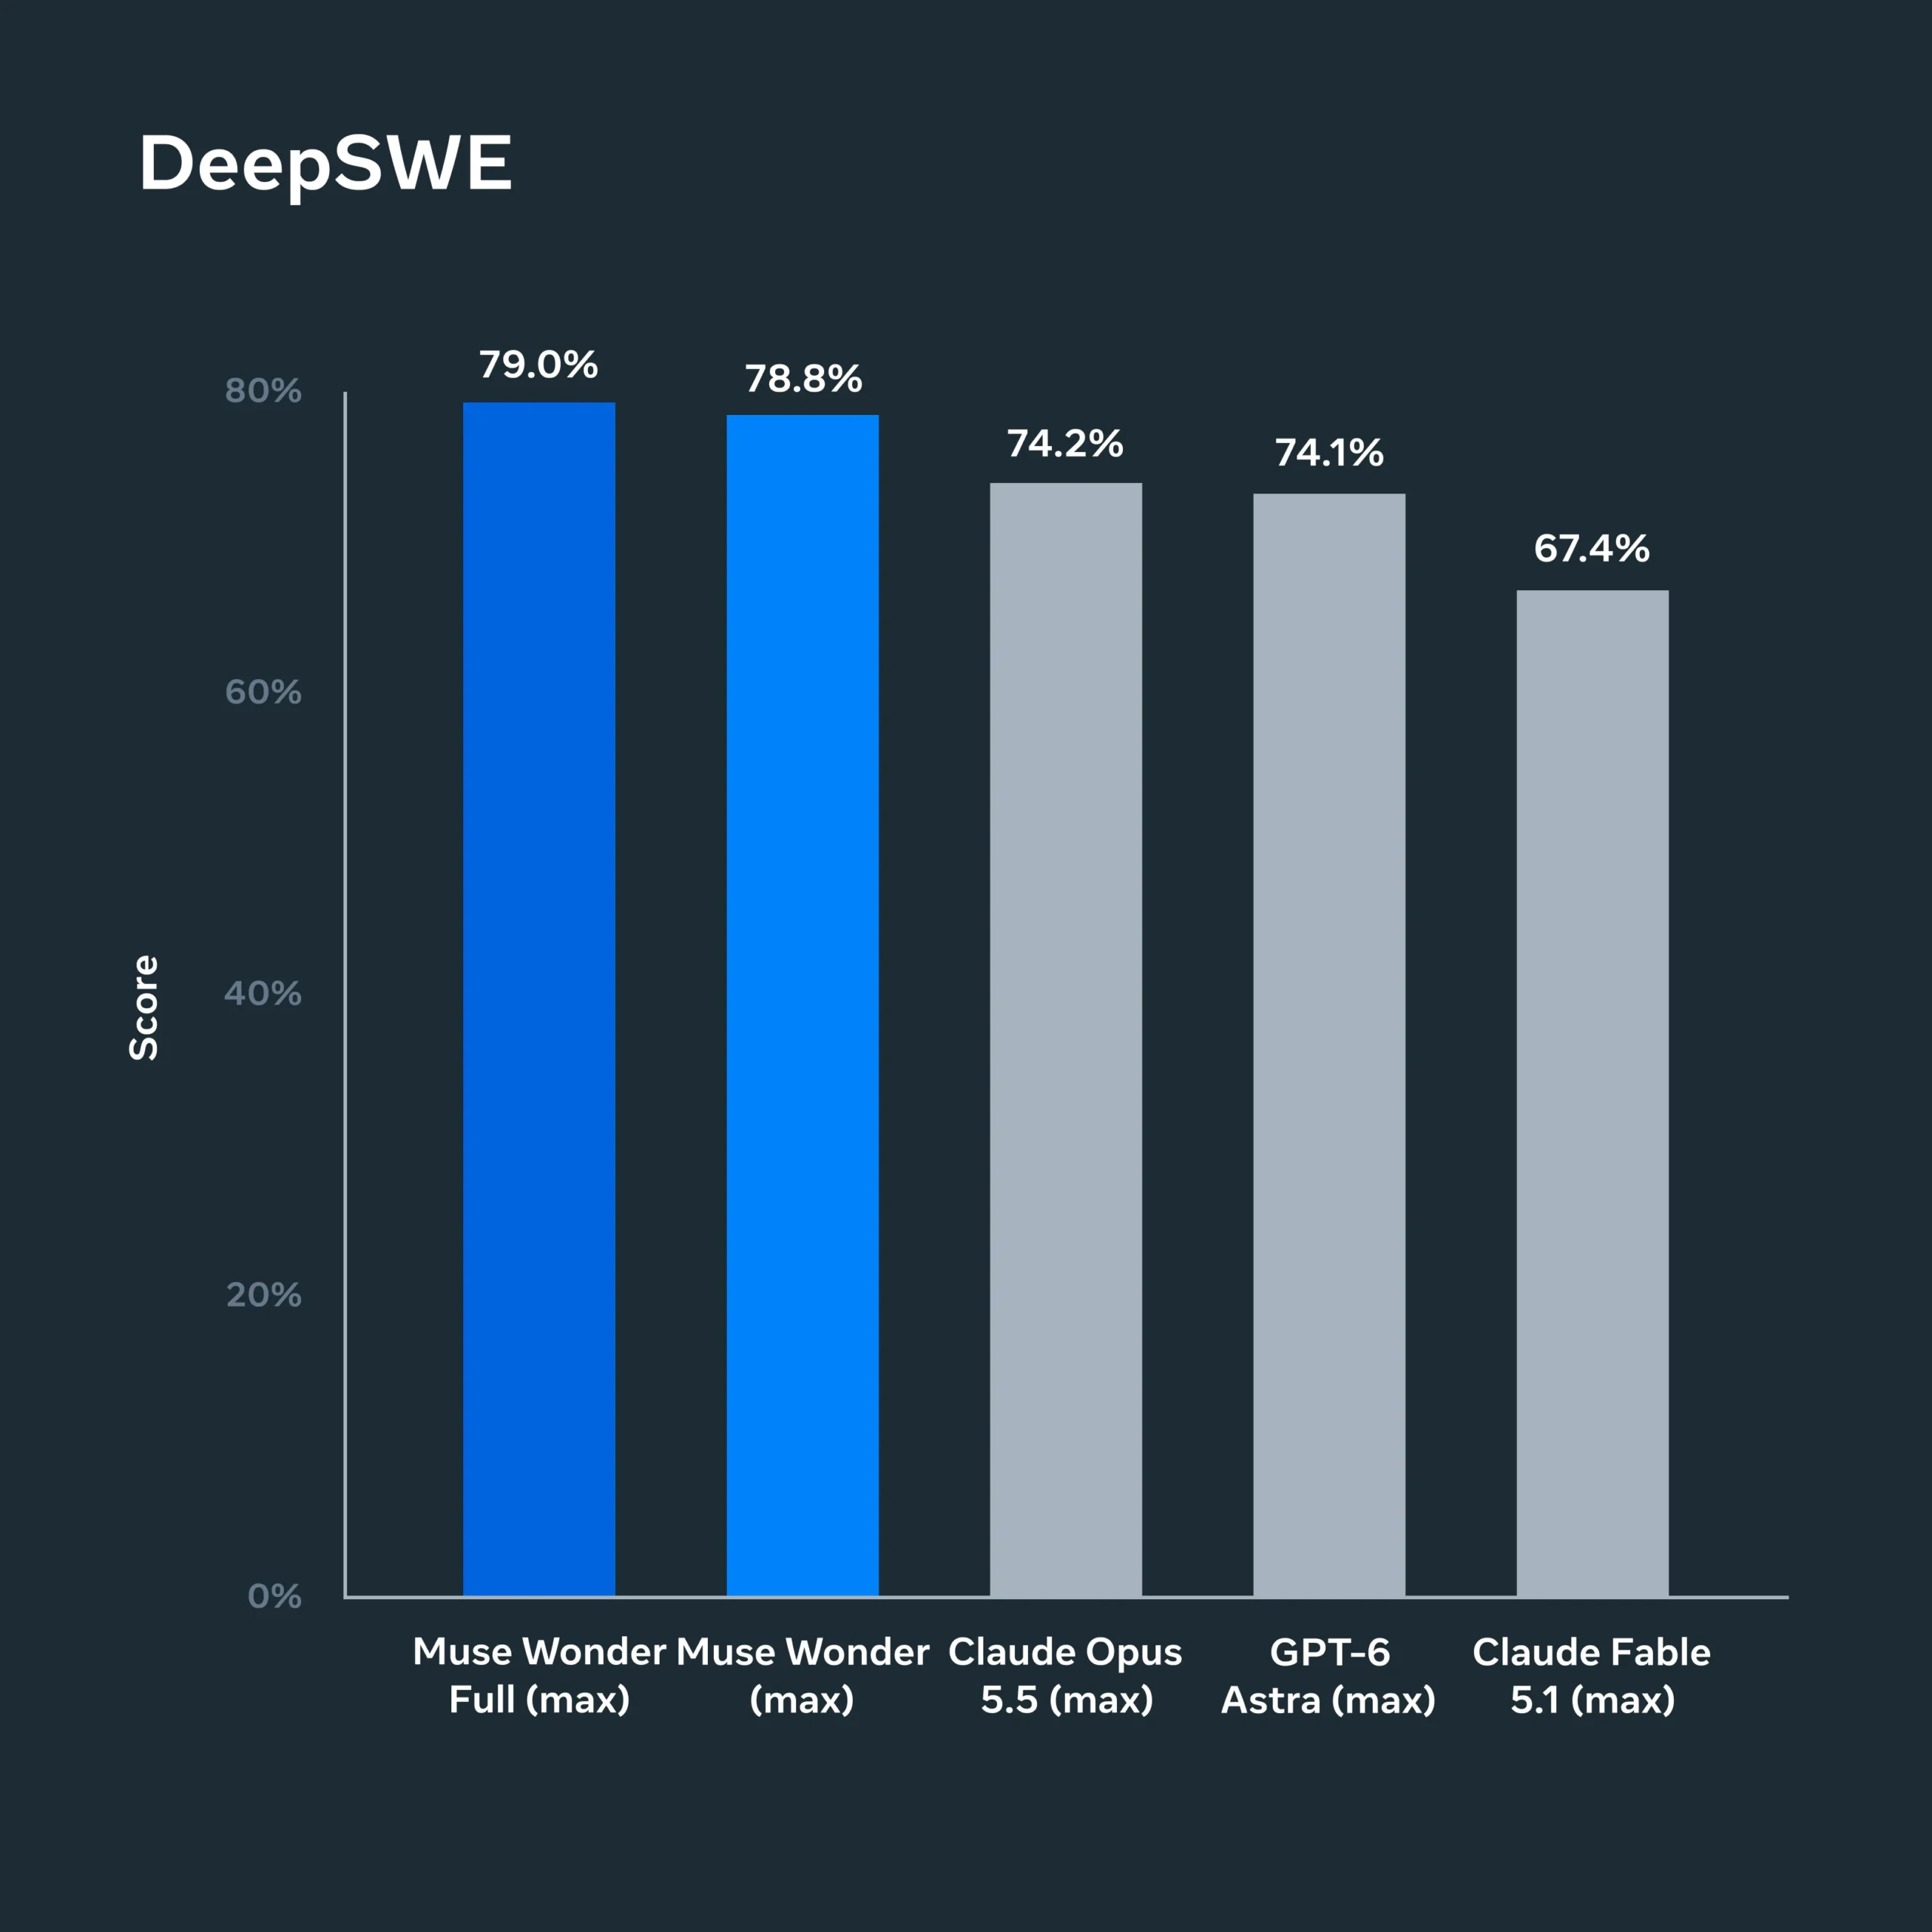
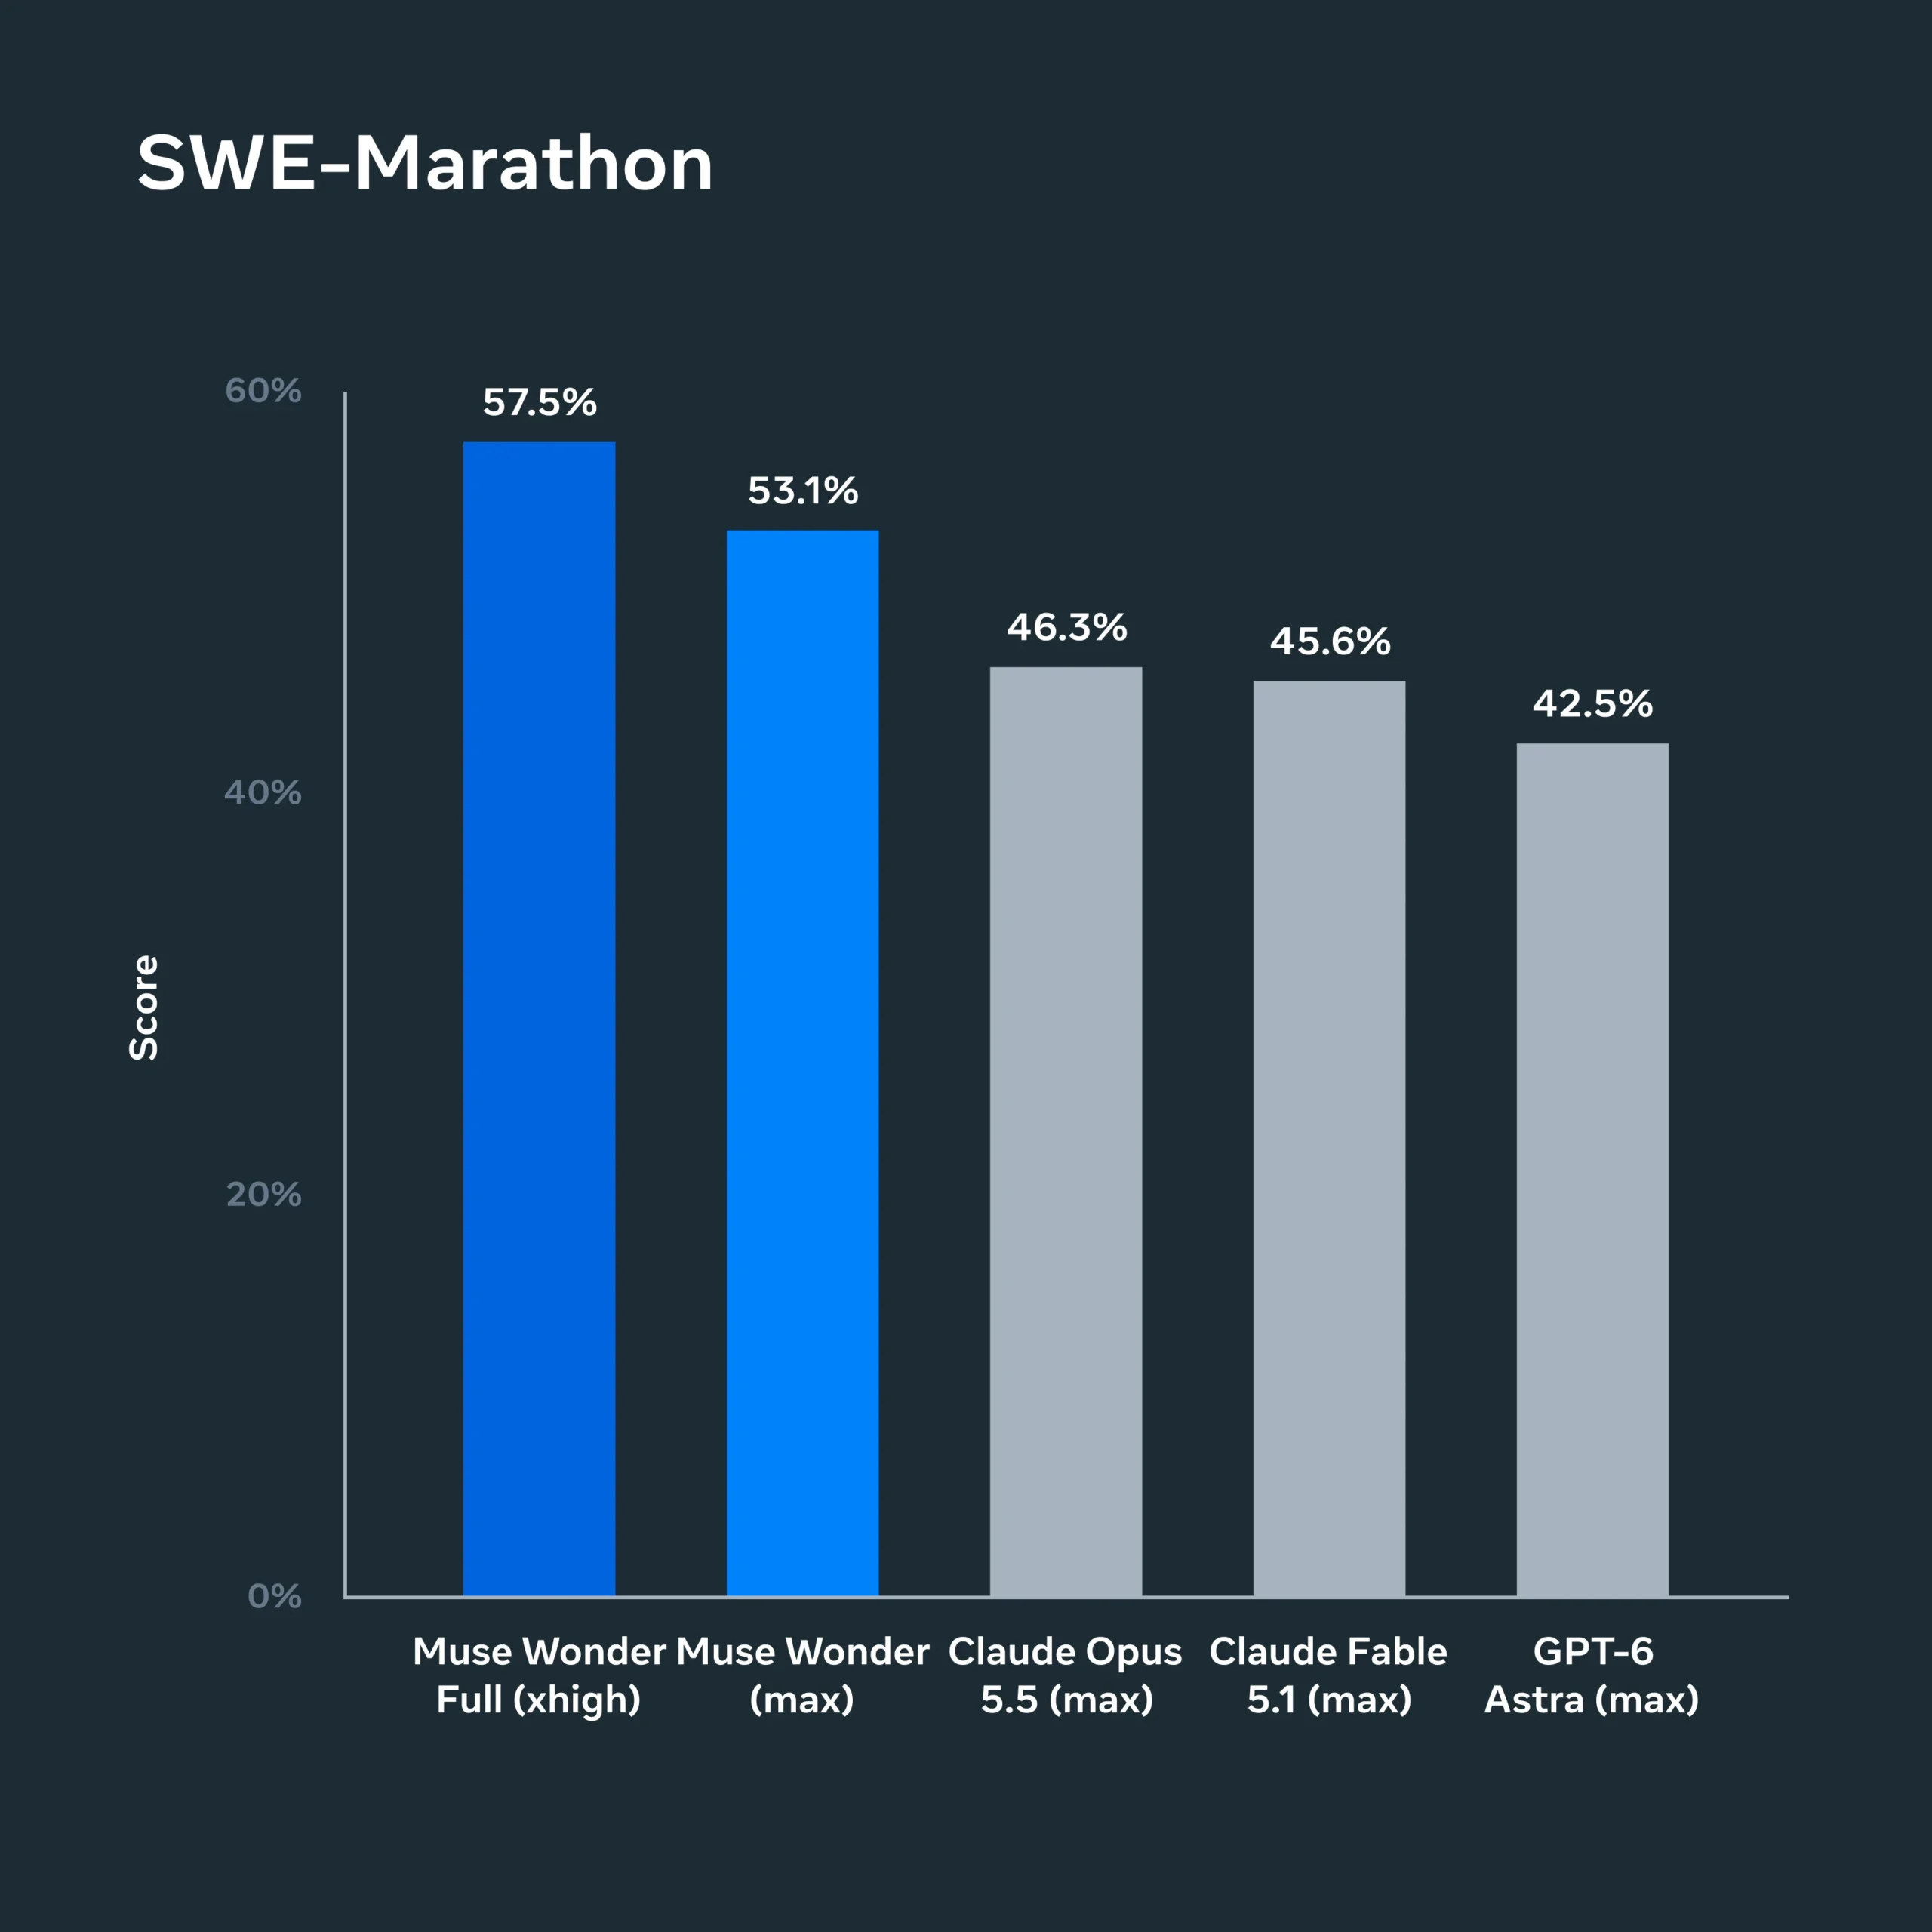
更考驗耐力的 SWE-Marathon,Muse Wonder Full 拿到 57.5%,Claude Opus 5.5 是 46.3%、Claude Fable 5.1 是 45.6%,GPT-6 Astra 只有 42.5%,領先幅度超過 10%。標準版 Muse Wonder 在這兩項也分別拿到 78.8% 與 53.1%,同樣贏過所有對手:
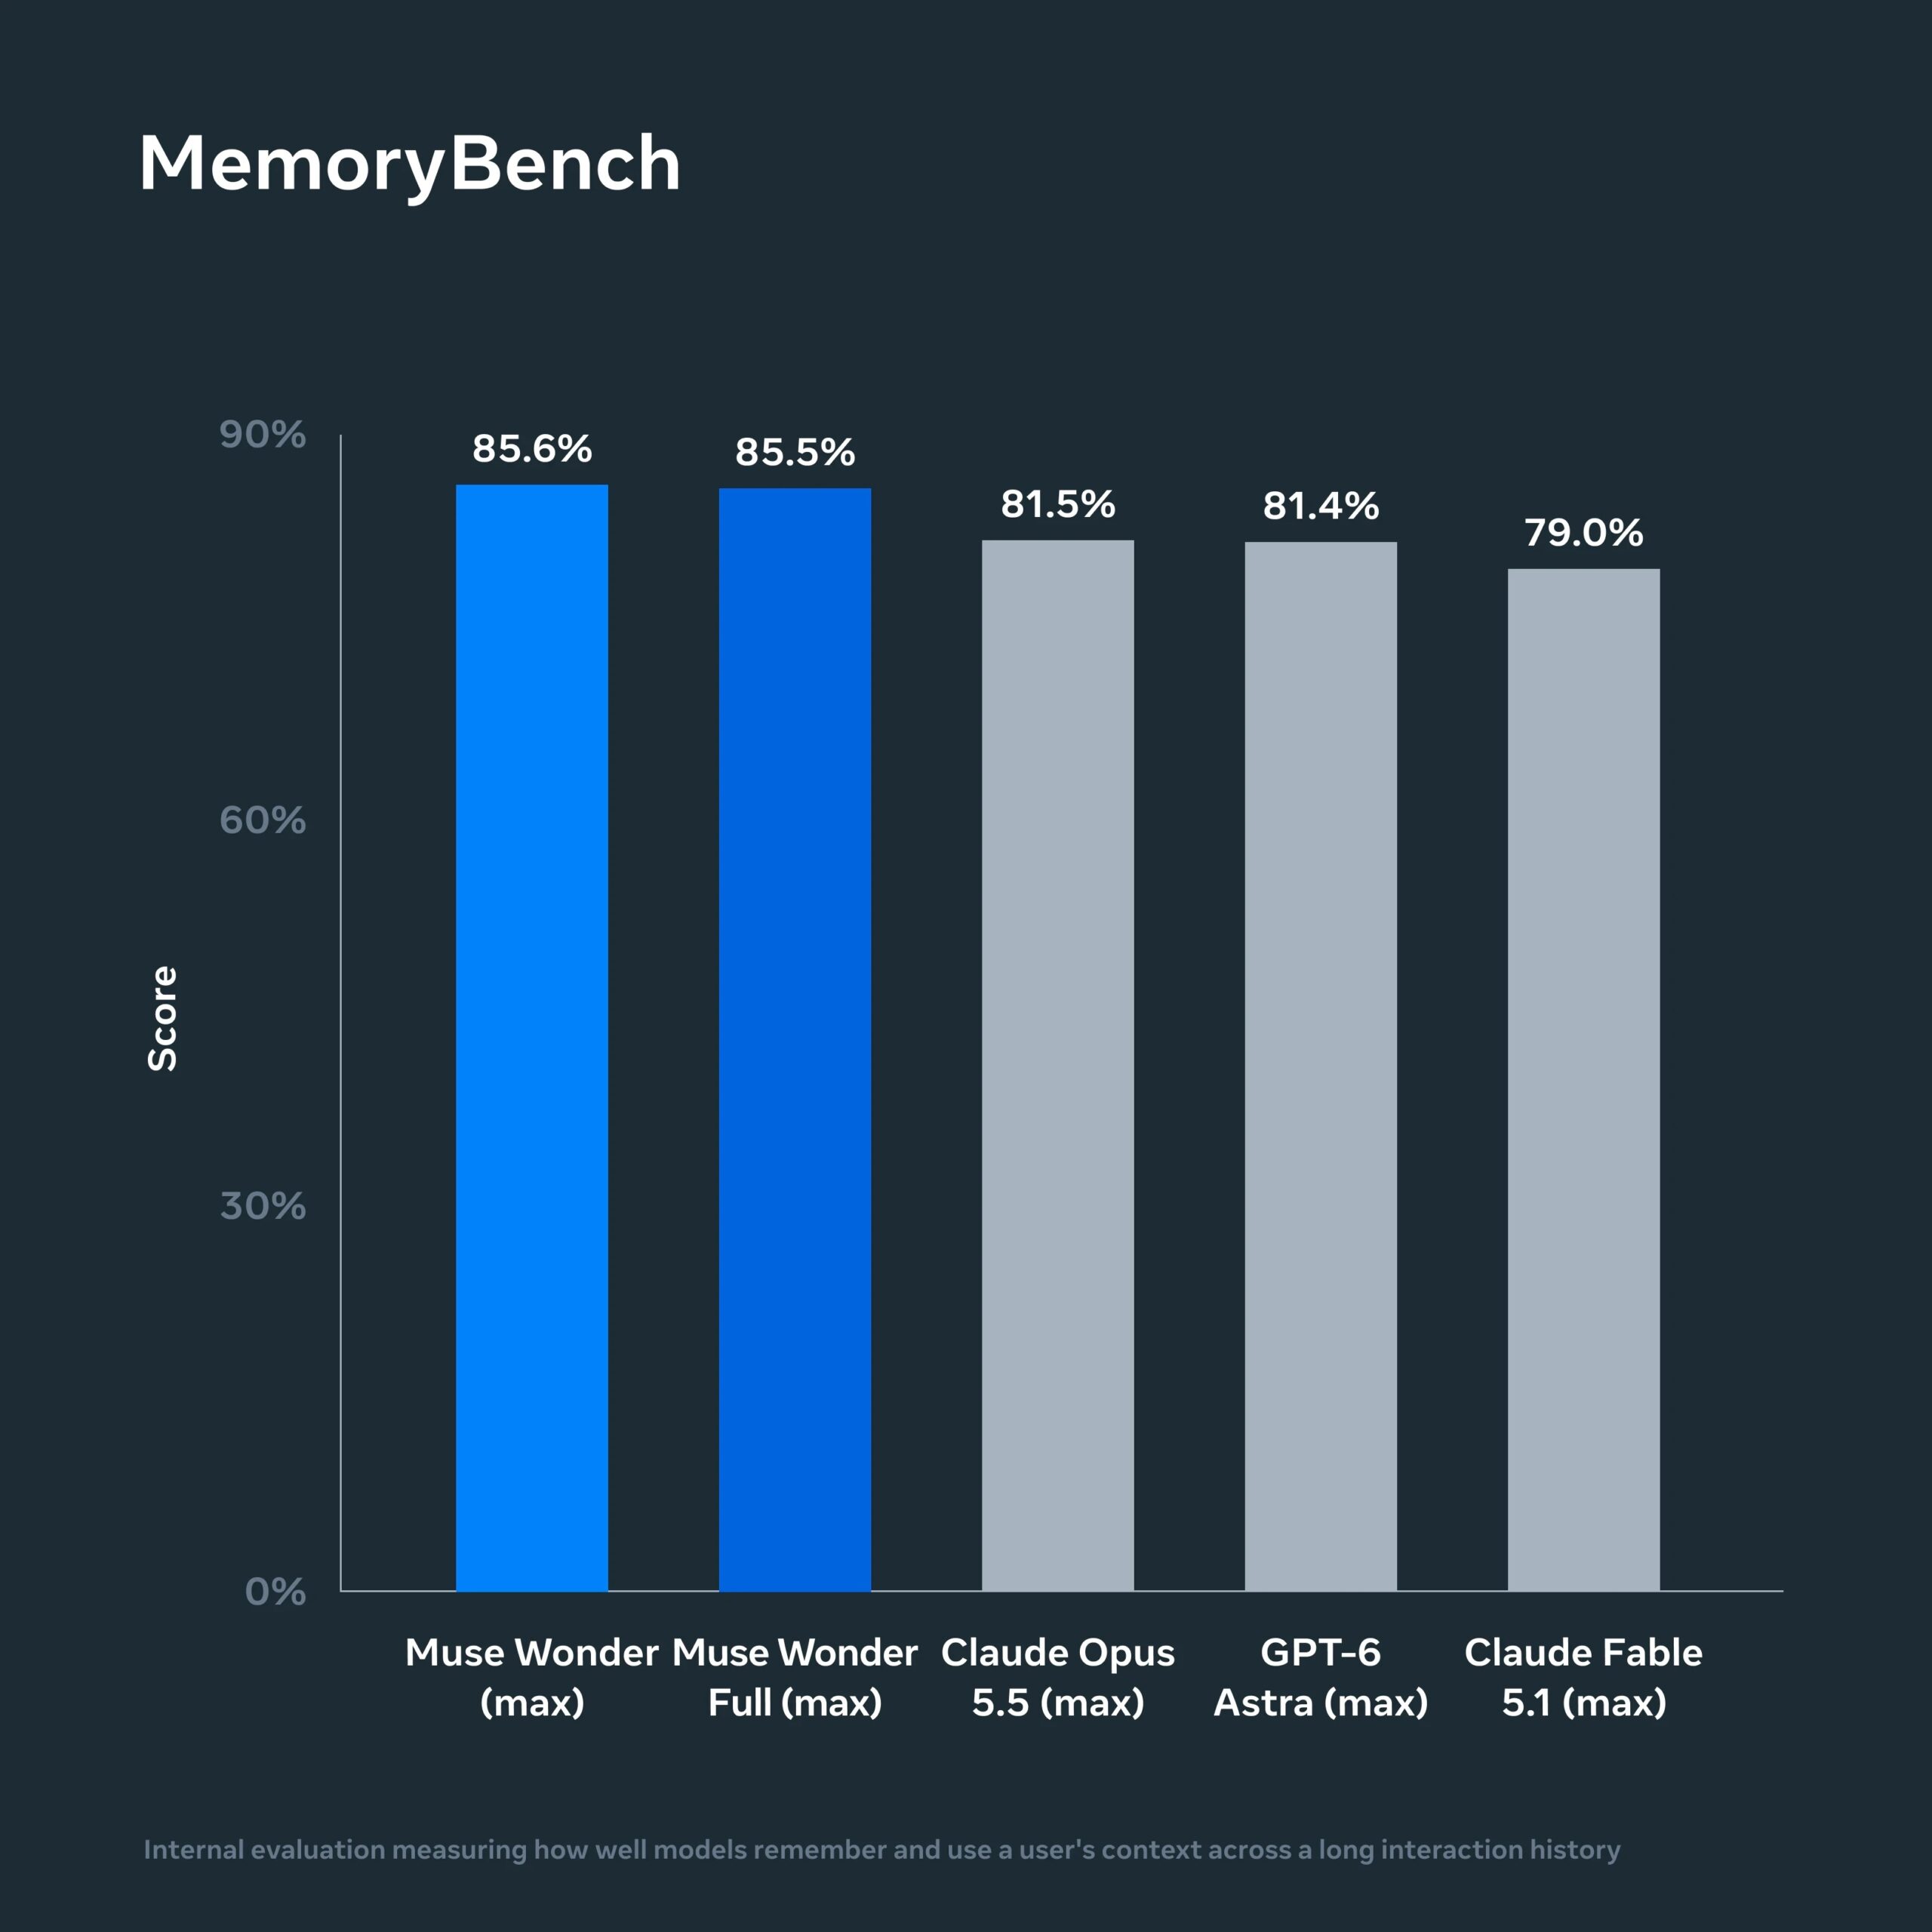
記憶能力也是 Meta 這次的主打,在 Meta 自家的 MemoryBench 測試中,標準版 Muse Wonder 拿到 85.6%,反而比 Full 版的 85.5% 多一點點,兩者都明顯領先 Claude Opus 5.5 的 81.5%、GPT-6 Astra 的 81.4% 與 Claude Fable 5.1 的 79.0%:
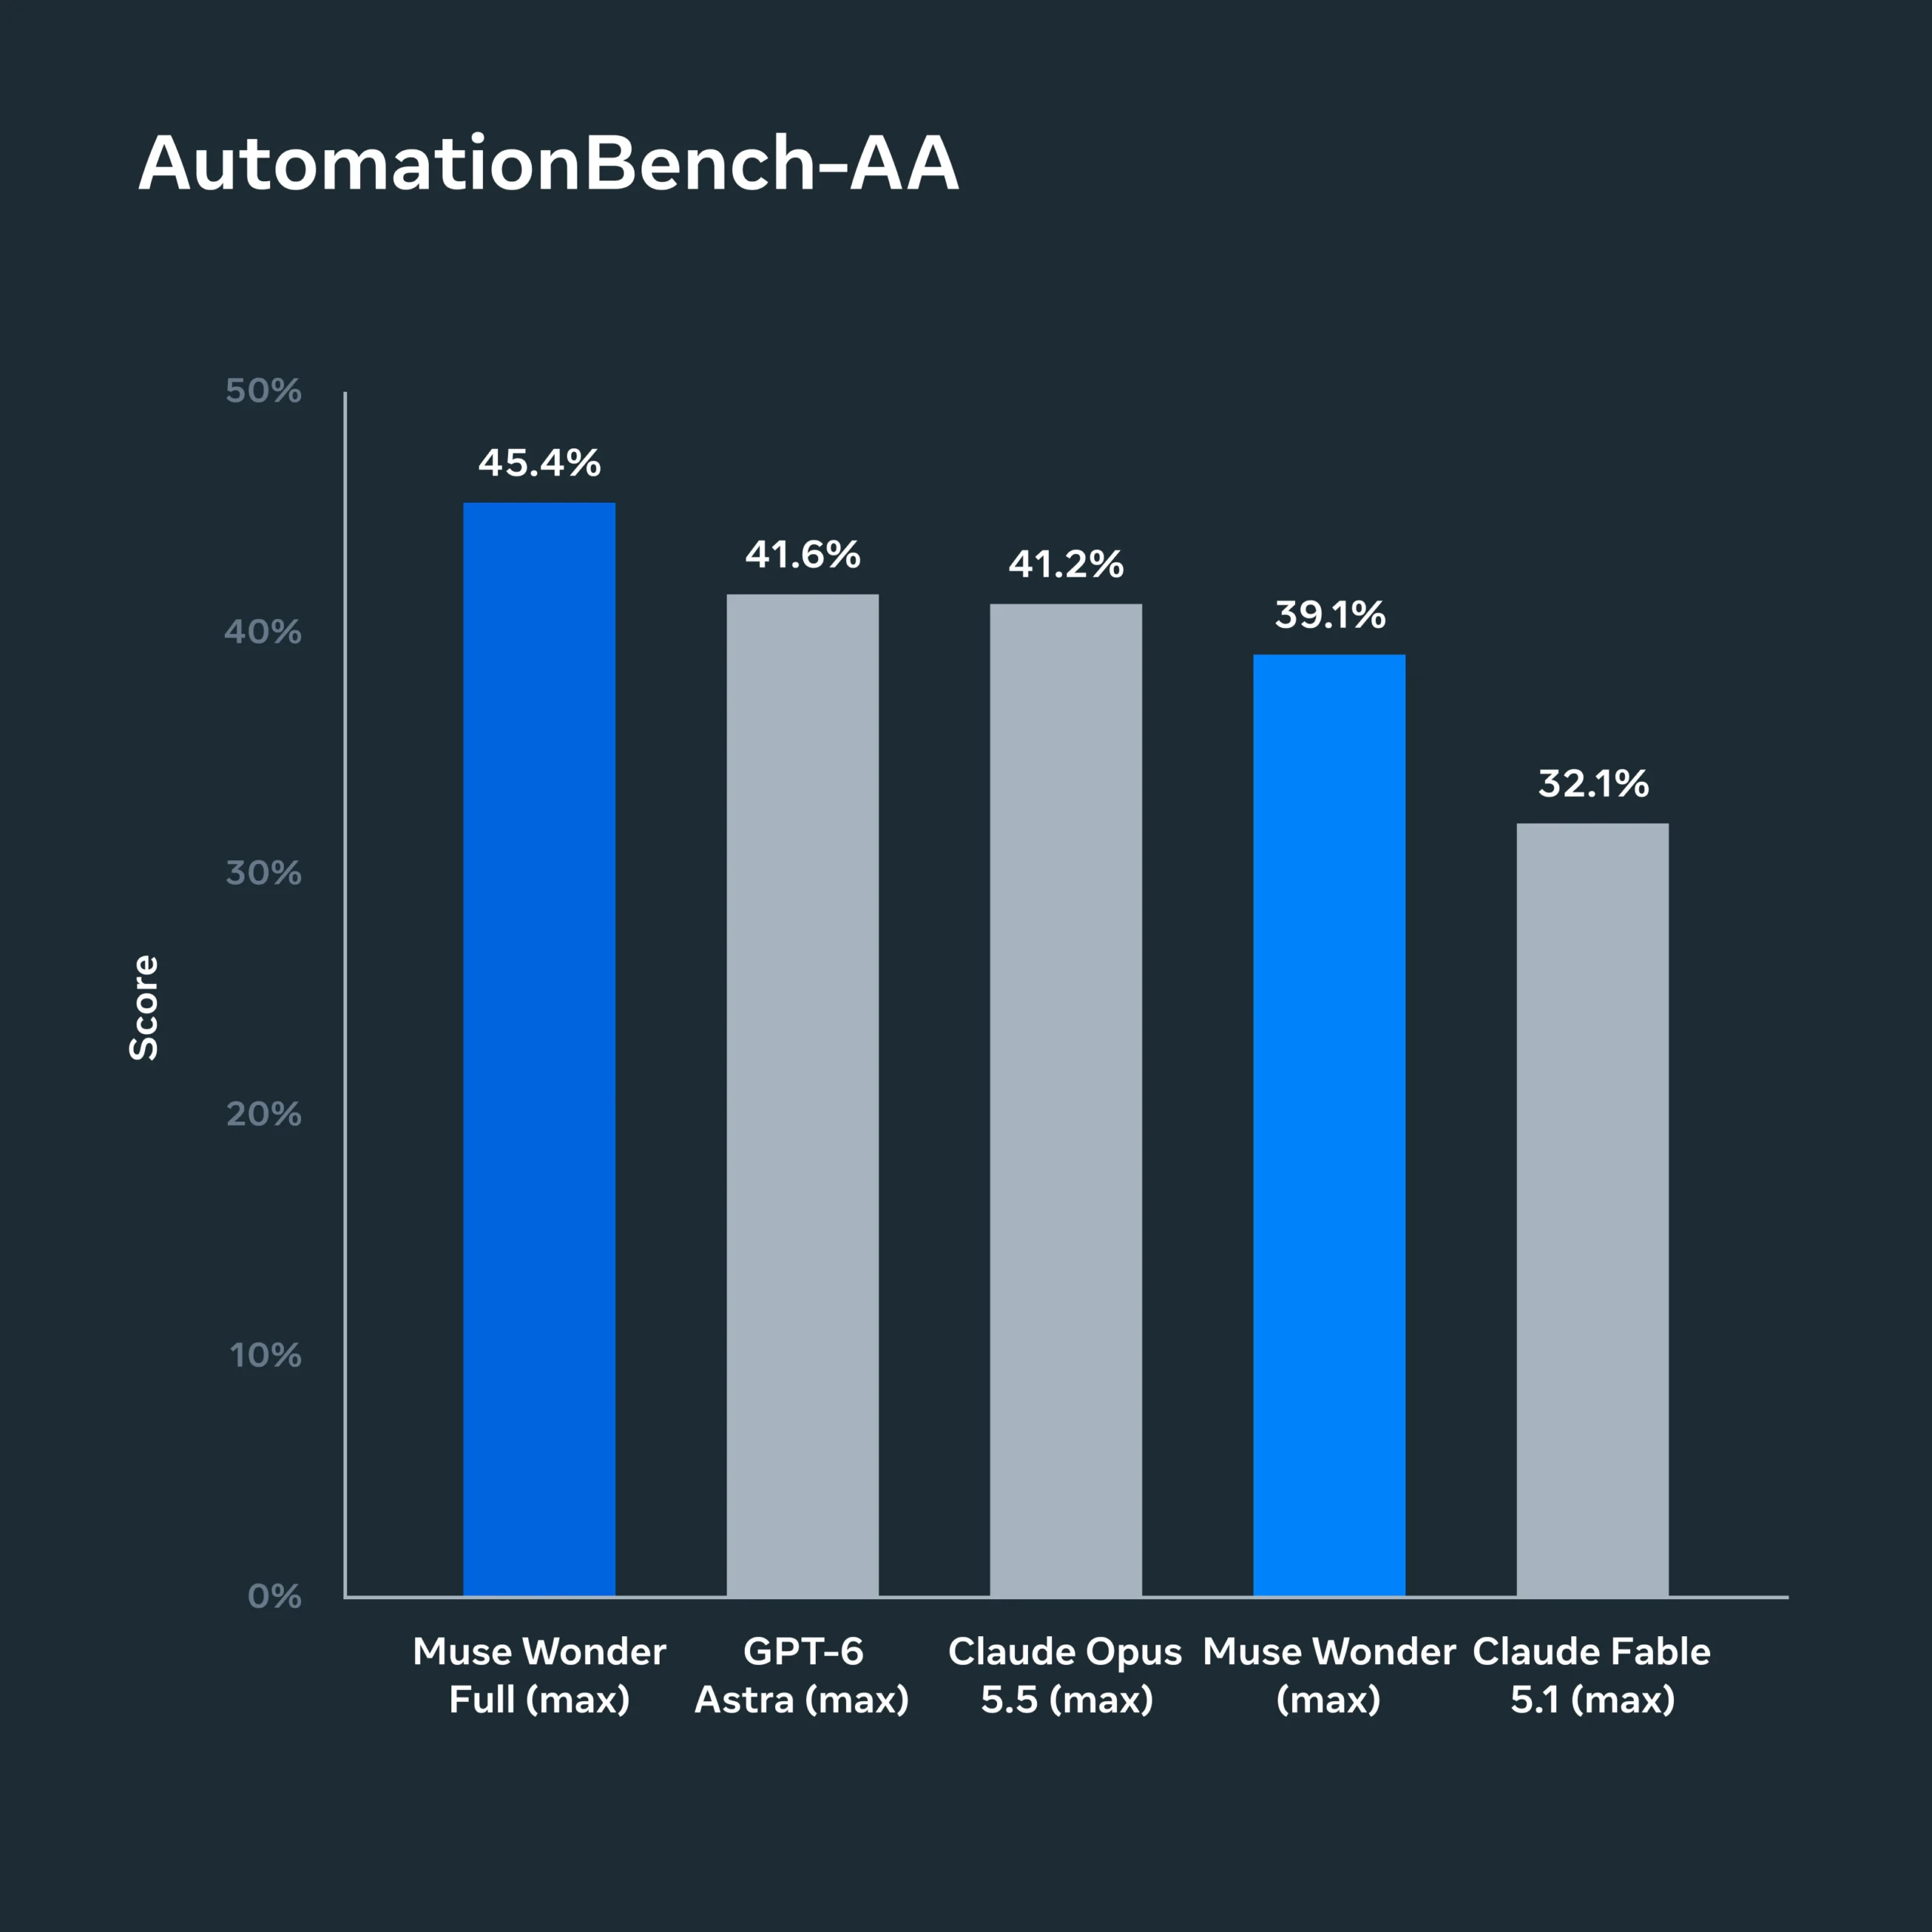
AI 代理相關測試,Full 版也拿下好幾個第一。
像是端到端商業流程自動化的 AutomationBench-AA,Muse Wonder Full 拿到 45.4%,GPT-6 Astra 是 41.6%、Claude Opus 5.5 是 41.2%:
當然,Meta Wonder 也不是每一項都贏,在這張表格中,Claude Opus 5.5 在好幾項還是保持領先。
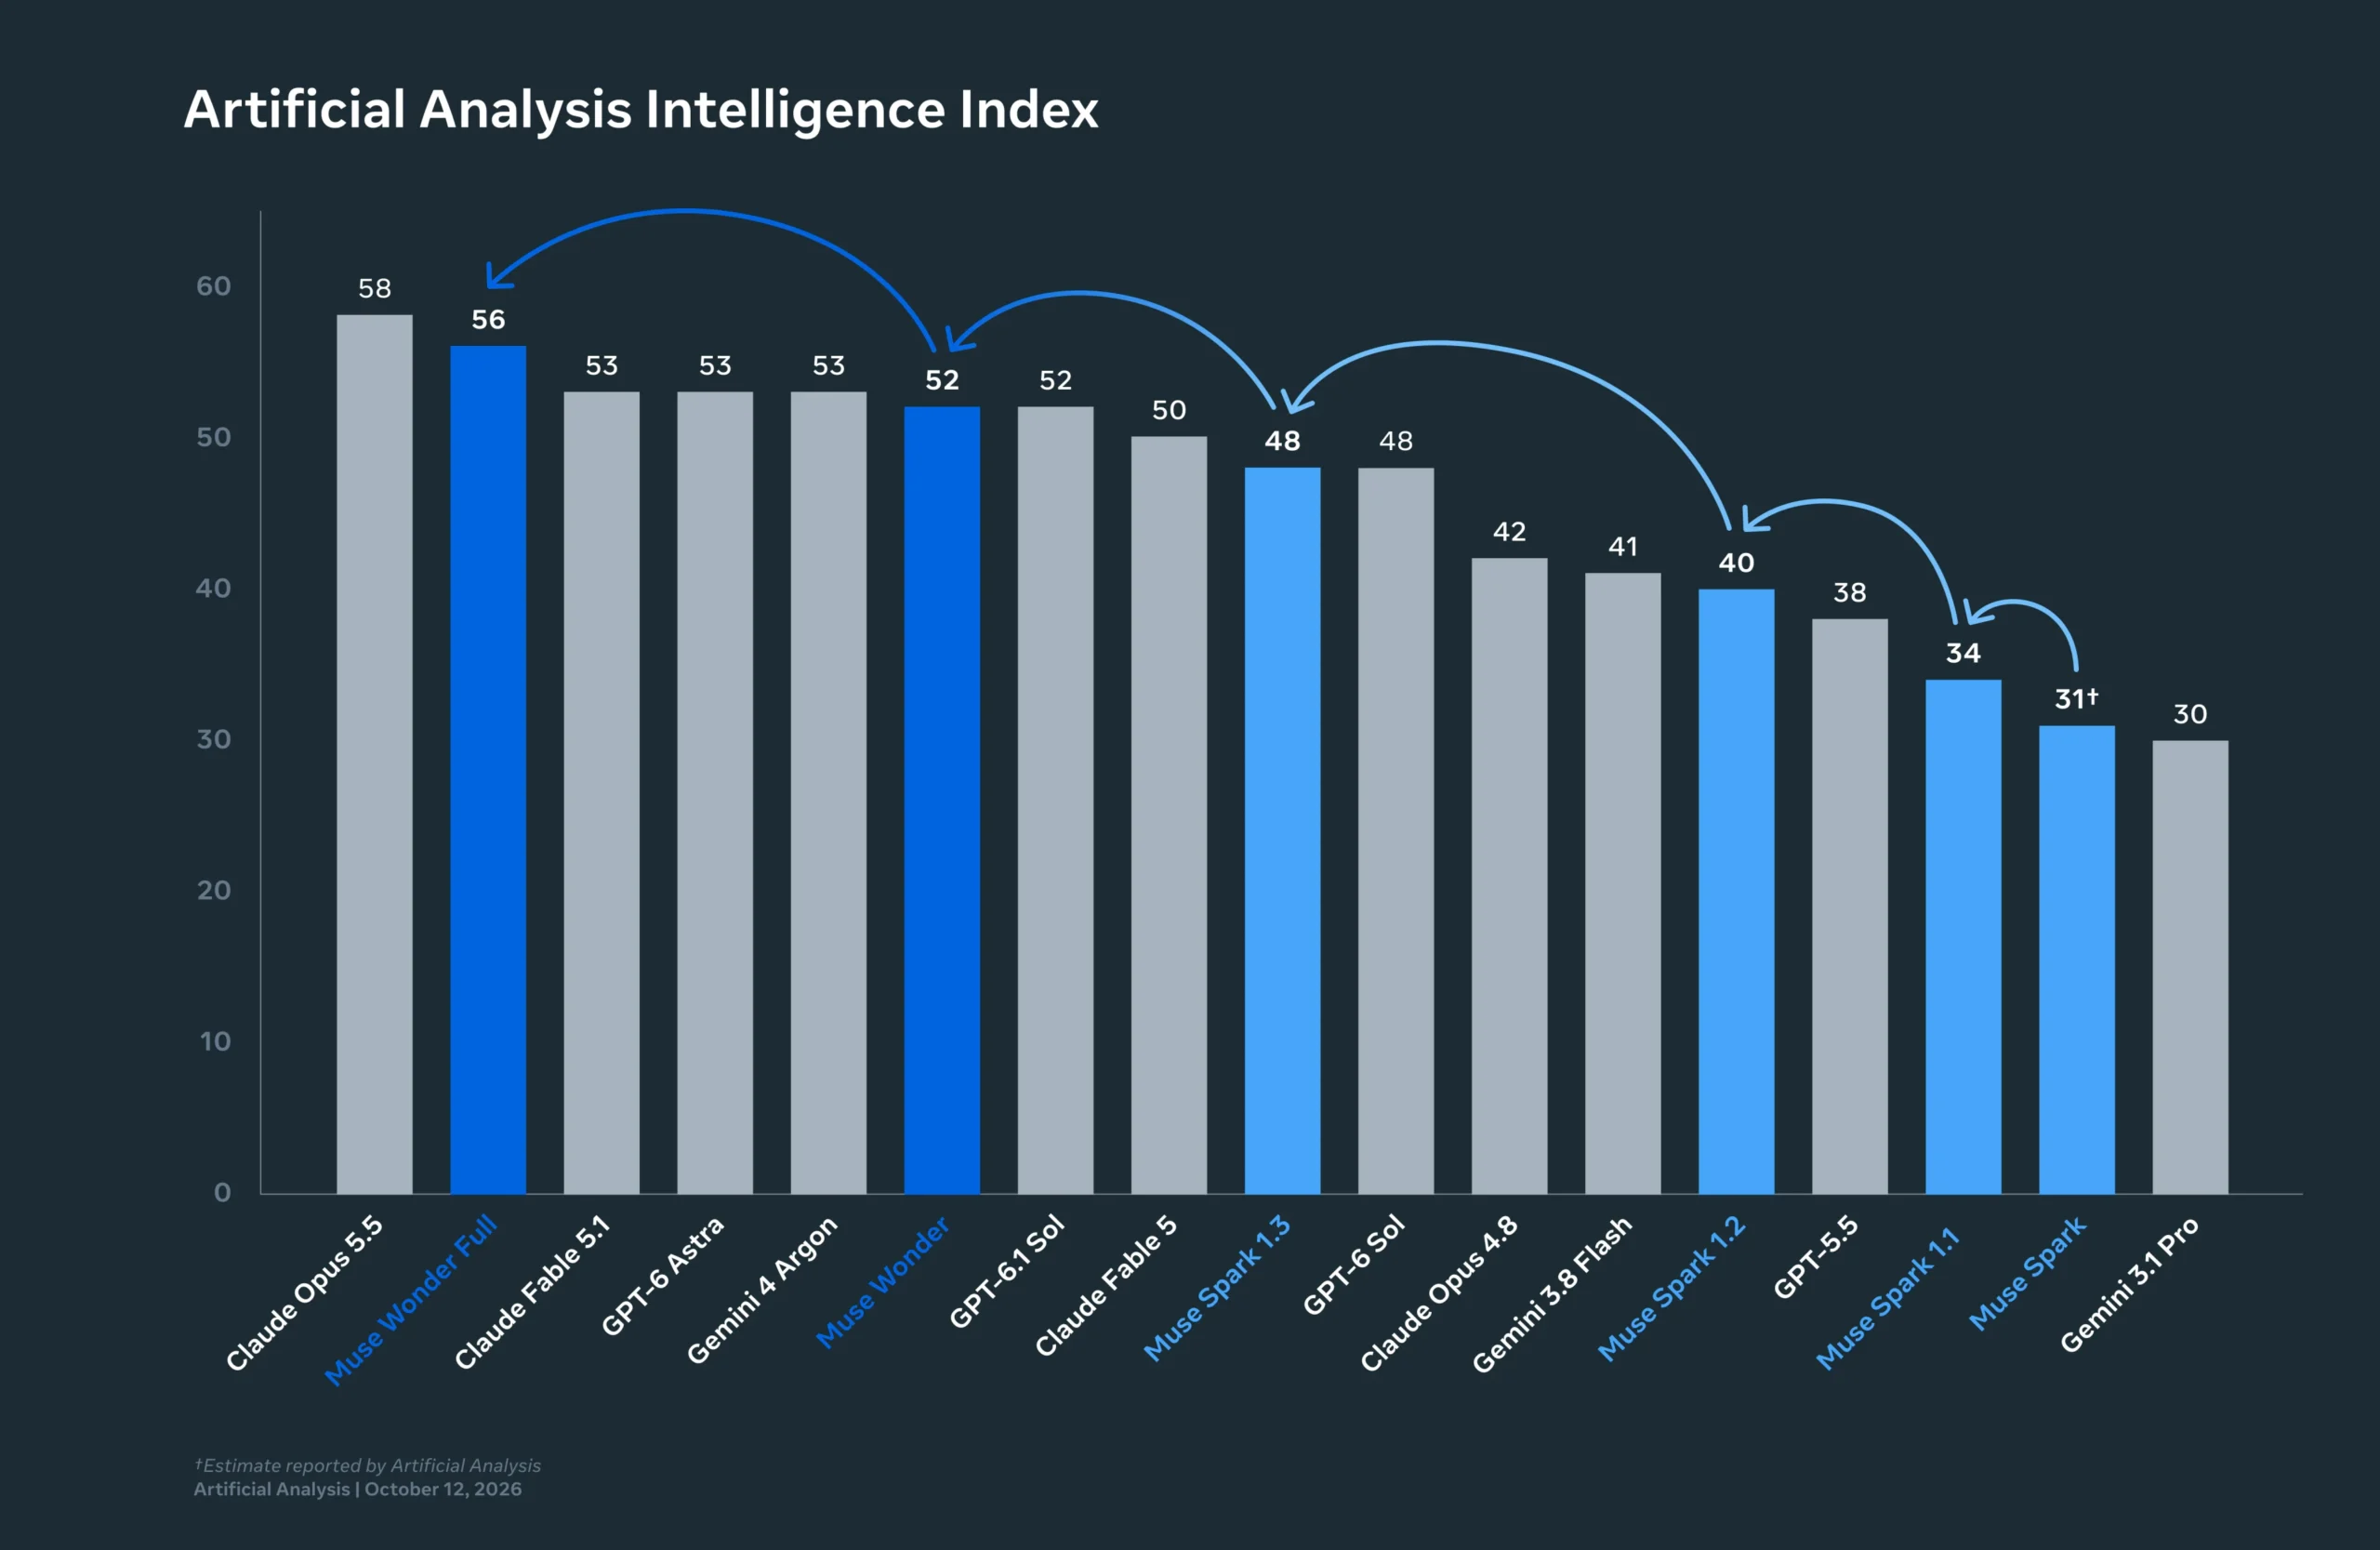
Meta 也提供第三方評測機構 Artificial Analysis 的綜合智慧指數排名。
9 月 Muse Spark 1.3 的 48 分,已經追平 GPT-6 Sol。而這次的 Muse Wonder 標準版拿到 52 分,不僅跟 GPT-6.1 Sol 同分,Full 版更以 56 分拿下第二,超過 Claude Fable 5.1、GPT-6 Astra 與 Google 的 Gemini 4 Argon(皆為 53 分),只輸給 Claude Opus 5.5 的 58 分:
Muse Wonder 系列現在已經能透過 Meta Model API 與 Muse Code 使用。Muse Wonder Full 則只提供給 Muse Code 訂閱者。
Meta 也表示,Muse Wonder 很快會導入個人 AI 代理服務 Muse,並且優先開放給訂閱者,之後也會用在 Muse 的 Artifact 生成等需要更高智慧的功能上。