
想讓 Mac 本機 AI 模型跑得更快,或是讓原本跑不起來的模型成功運行,多數人想到的應該都是換一台記憶體更大的 Mac。不過,現在有開發者真的實現了你可能都曾想過的想法:讓手邊的 iPhone 也一起幫忙跑 AI。
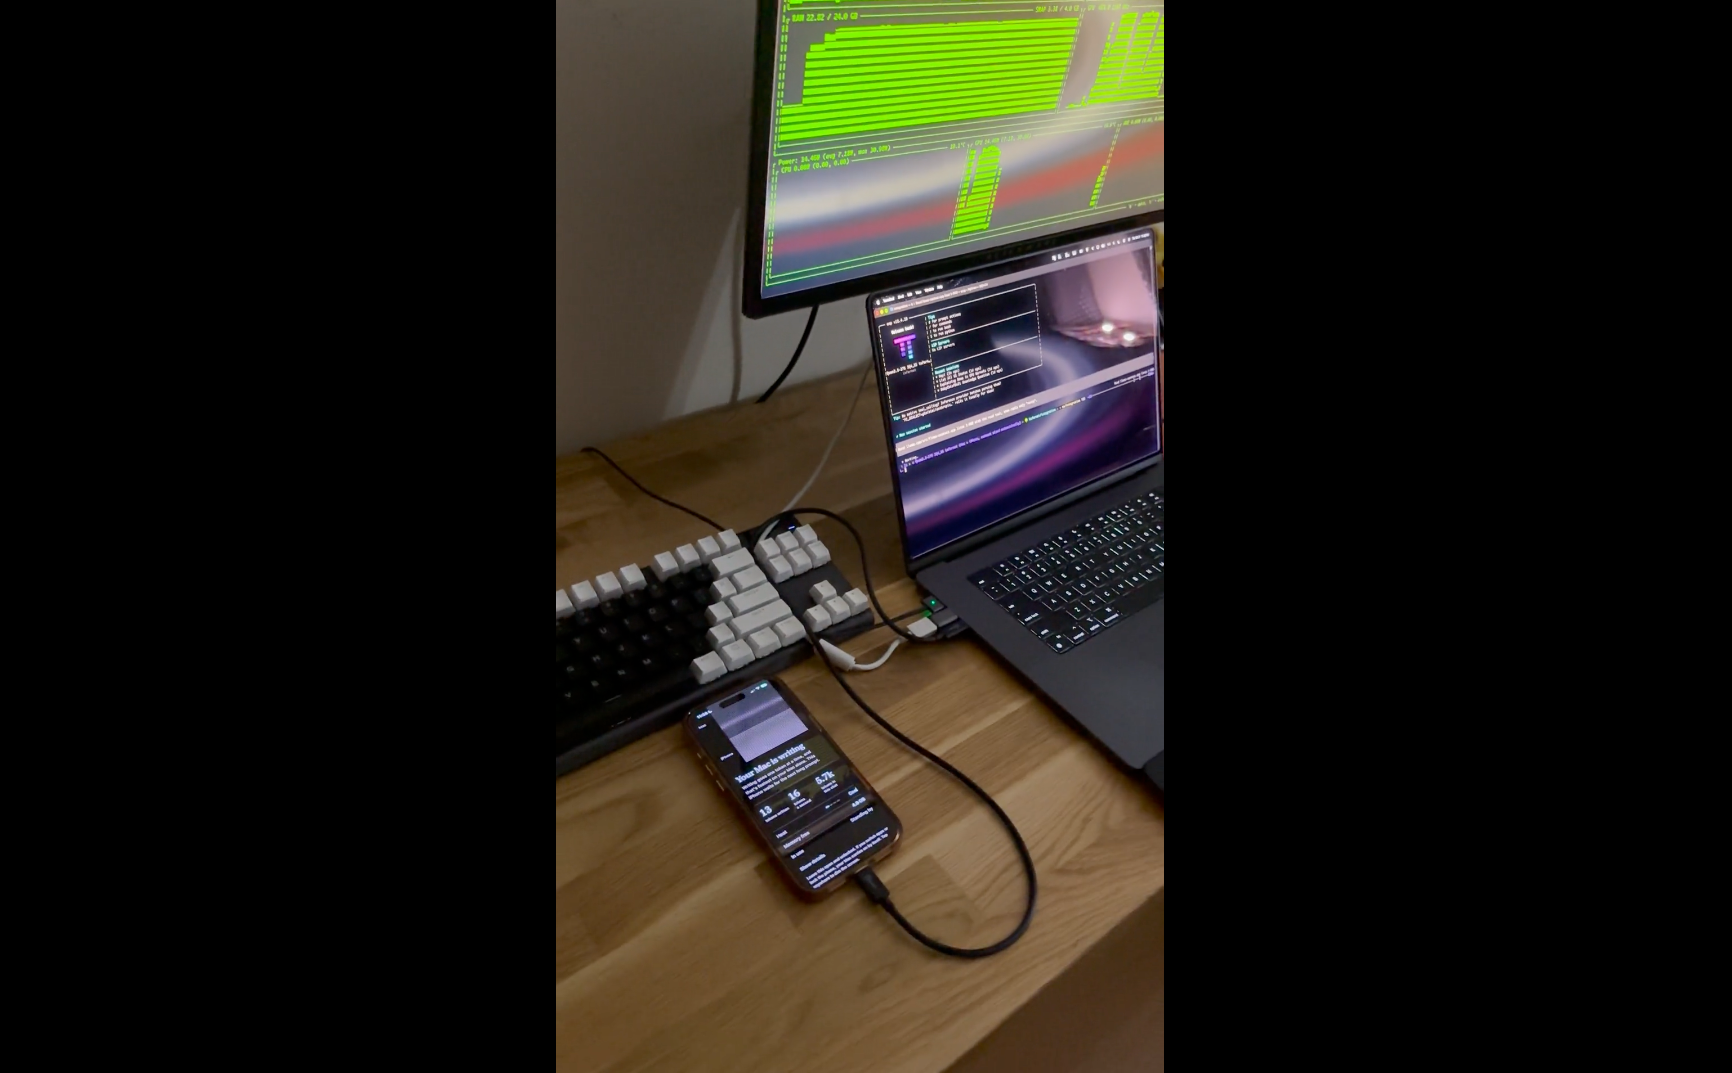
這個開源專案叫做 Backburner。開發者只用一條 USB-C 線,把 iPhone 17 Pro Max 接上 M4 Pro MacBook Pro,就成功讓兩台裝置分工處理 AI 模型。
根據他公布的測試結果,iPhone 加入運算後,AI 處理長篇 Prompt 的 Prefill 速度最高提升 44%。在另一種模式下,還能把部分 KV Cache 放到 iPhone,讓原本約 6.4 萬 Token 的上下文上限,理論上進一步拉高到約 20 萬 Token。
iPhone 也能幫 Mac 跑 AI?開源專案 Backburner 用 USB-C 串起兩台裝置,長文讀取最多快 44%
近日開發者 StayLameBro 在 GitHub 上釋出 Backburner 首個預覽版 v0.0.1,並在 Reddit 分享他的測試結果。
測試環境是一台 24GB 記憶體的 M4 Pro MacBook Pro,加上一支 iPhone 17 Pro Max,中間用 10Gb/s 的 USB-C 線連接。跑的模型是 Qwen 3.8-27B,在 16K、32K、48K 三種上下文長度下,加上 iPhone 後的讀取速度分別快了 44%、29%、30%。
I made my iPhone a second GPU for my 24 GB MacBook: Qwen 3.8 27B prefills 29–44% faster & my holds part of the CTX window.
byu/StayLameBro inLocalLLaMA
那 iPhone 到底是怎麼幫上忙的?*簡單來說,就是把 AI 模型的工作拆給兩台裝置一起做。
像這次測試的 Qwen 3.8-27B,模型內部總共有 64 層,每次處理內容時,都要從前面一路算到最後一層。Backburner 會把前 40 層交給 Mac 的 GPU,剩下第 41~64 層則交給 iPhone,等於兩台裝置各自負責模型的一部分:
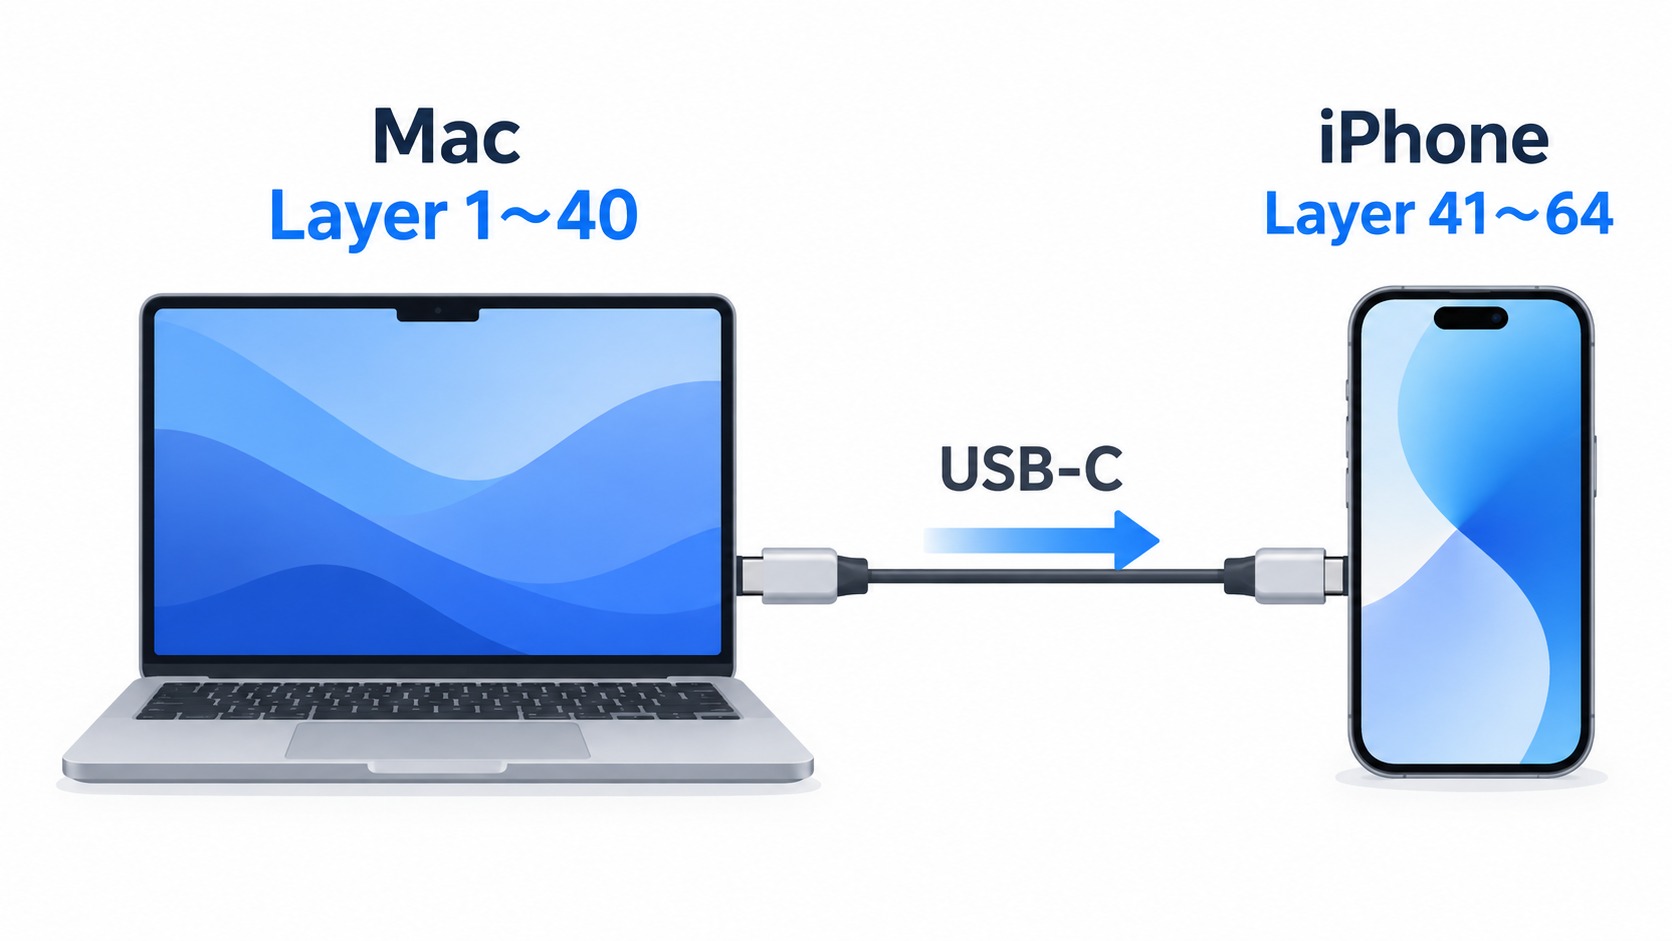
但如果只是 Mac 算完再換 iPhone,速度其實不會快多少,所以 Backburner 還用了類似「工廠流水線」的方式。它會把輸入內容切成一小批一小批,每批 256 Token。Mac 算完第一批的前 40 層後,就立刻透過 USB-C 把結果交給 iPhone,接著自己繼續處理第二批;這時候 iPhone 也同時在算第一批剩下的 24 層。
這樣一來,Mac 和 iPhone 就能同時工作,不用一台算完、另一台才能開始,整體處理速度自然就能提高。
此外,兩台裝置之間的傳輸速度也很重要,如果線材速度太慢,Mac 算完之後還得等資料傳到 iPhone,反而會拖慢整個流程。因此開發者才會使用 10Gb/s 的 USB-C 線,iPhone 隨盒附贈的 USB-C 線只有 USB 2 速度,不適合拿來跑這套系統。
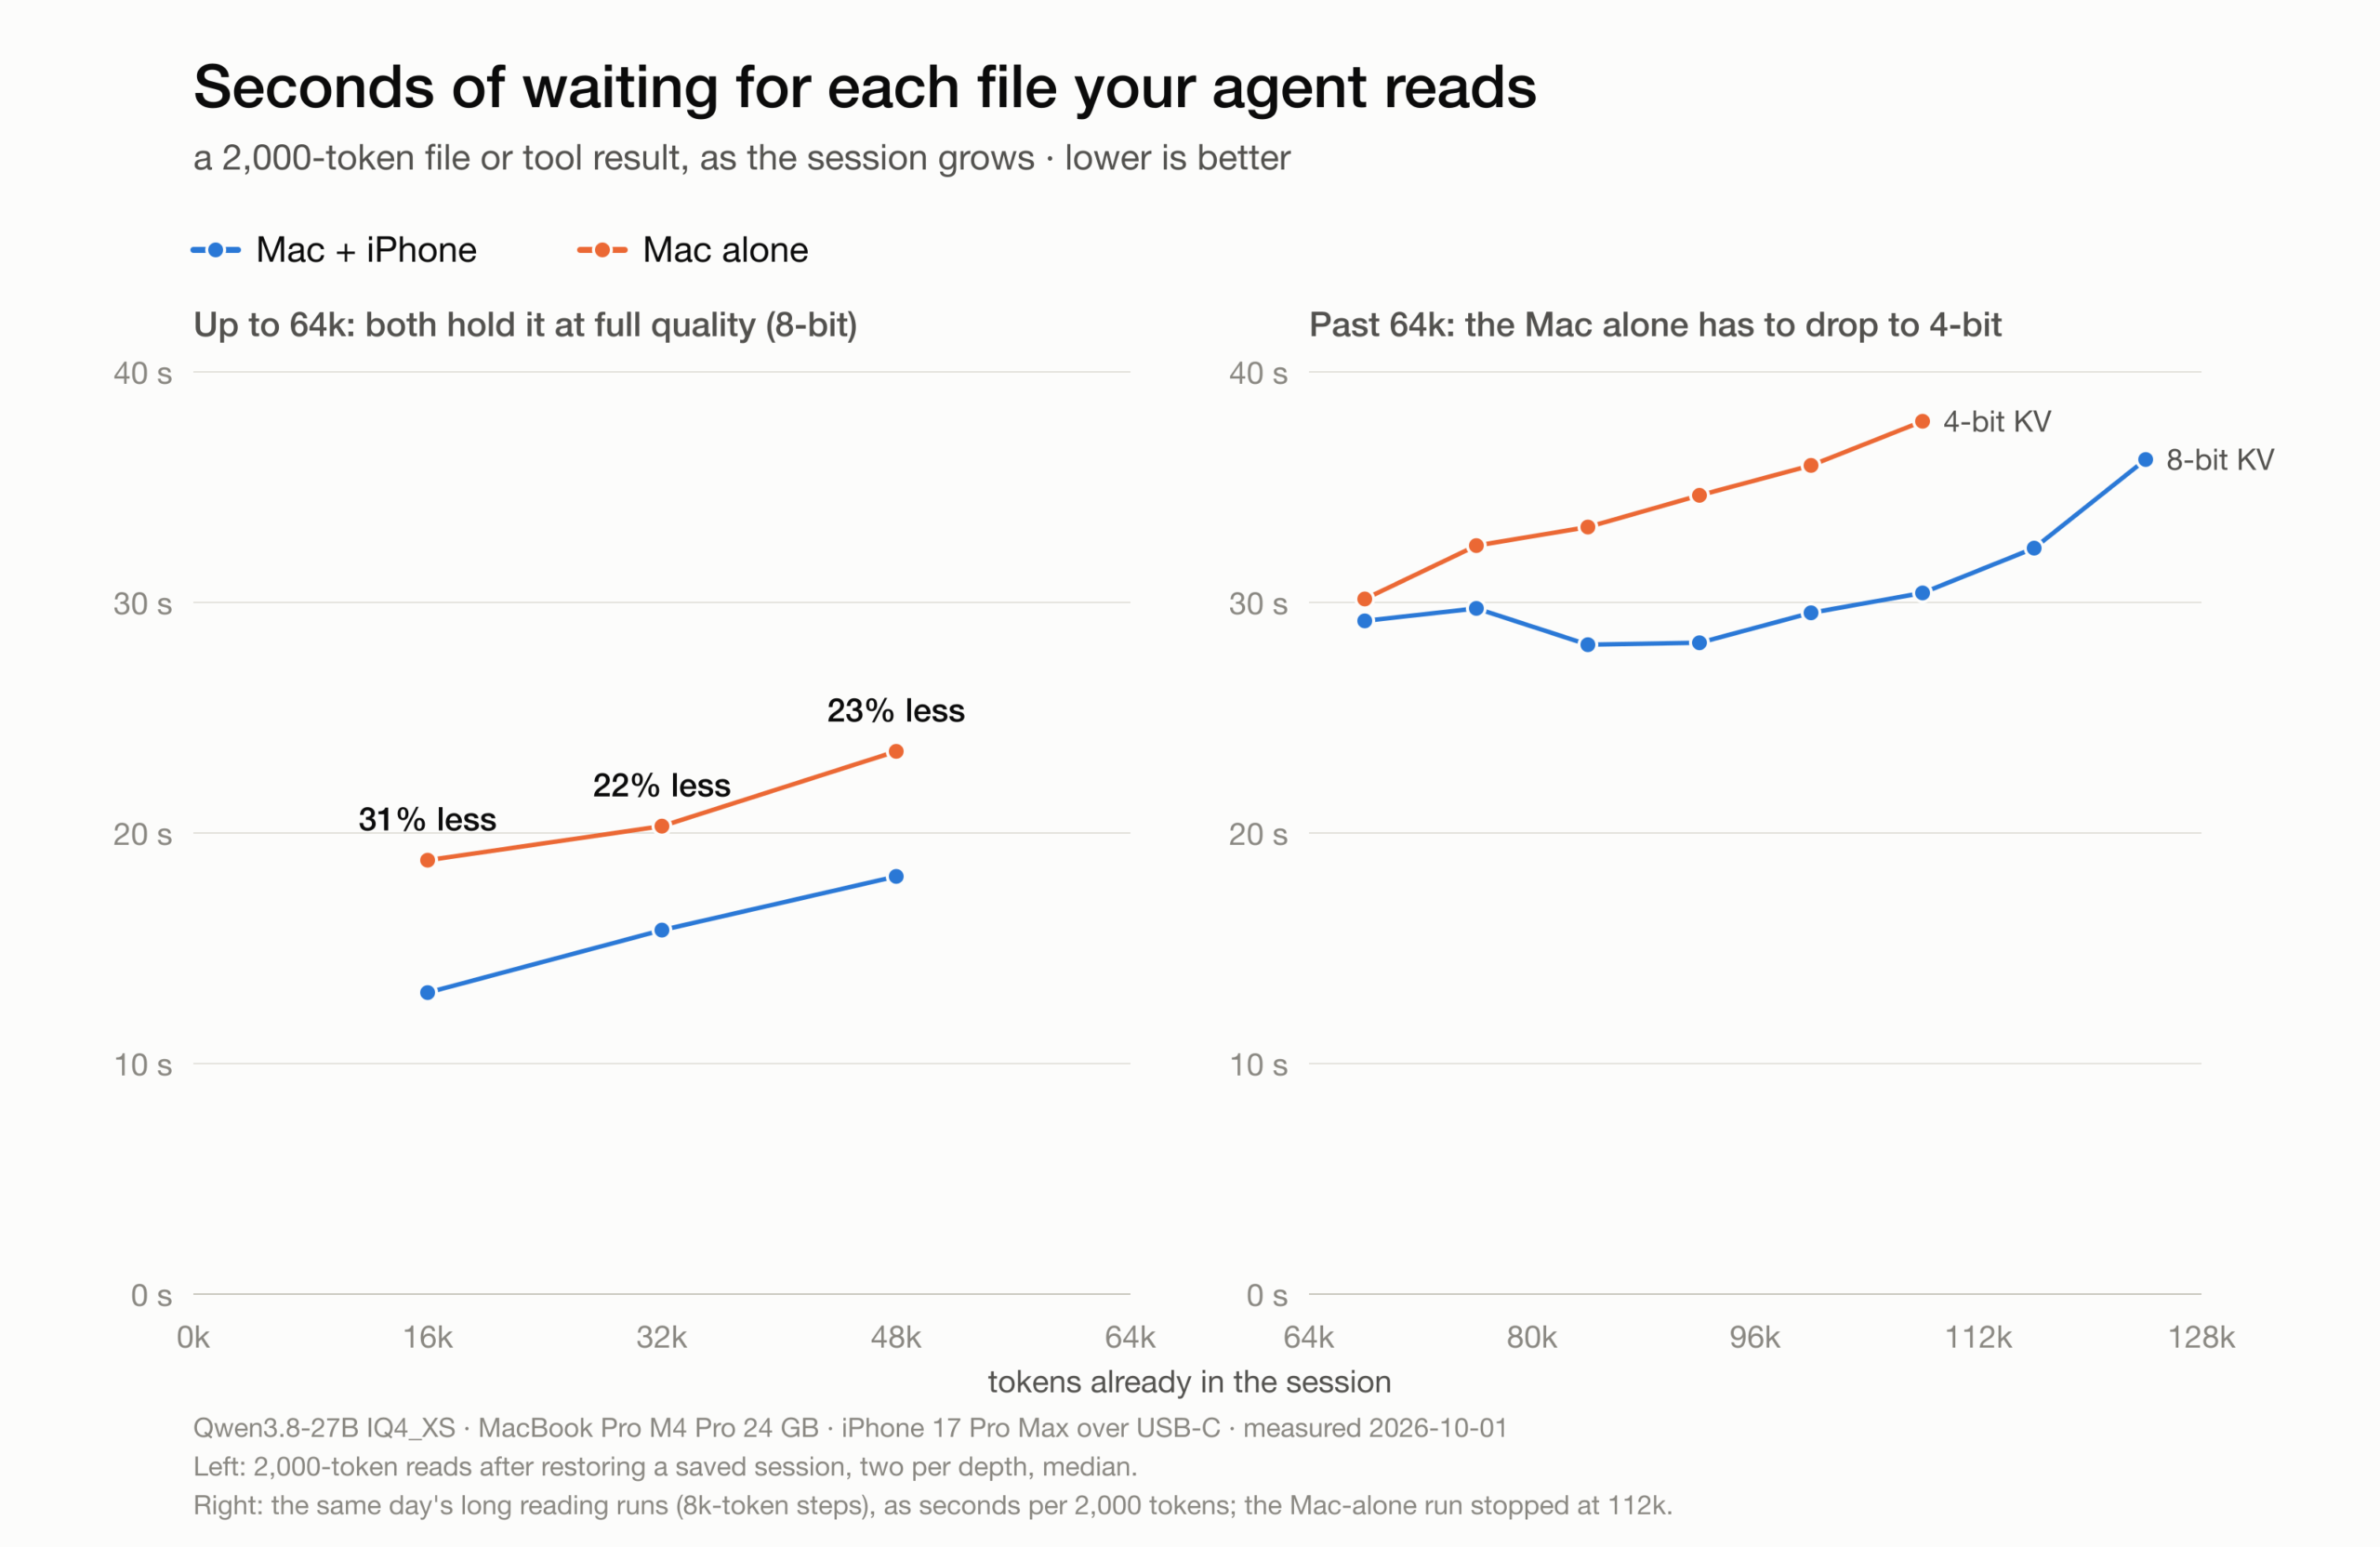
下方表格是測試結果,要注意的是,速度提升是指 AI「讀取內容」的速度,不是產生答案的速度:
| 上下文長度 | 只用 Mac | Mac+iPhone | 速度提升 | 等待時間 |
|---|---|---|---|---|
| 16K | 109 tok/s | 157 tok/s | +44% | 18.8 秒 → 13.1 秒(少等 31%) |
| 32K | 101 tok/s | 130 tok/s | +29% | 20.3 秒 → 15.8 秒(少等 22%) |
| 48K | 87 tok/s | 113 tok/s | +30% | 23.5 秒 → 18.1 秒(少等 23%) |
開發者也另外用 AI 代理工具做了一次更貼近日常使用的測試。他開了一個約 2.7 萬 Token 的新工作階段,使用原版 llama.cpp 時,第一次回應要等 245 秒。換成 Backburner 修改版、但仍只用 Mac,縮短到 228 秒。接上 iPhone 一起運算後,則進一步降到 168 秒,比原本少等了將近 80 秒。
後續繼續對話時,等待時間也從平均 19.2 秒 降到 14.5 秒,代表這套方法不只跑分有提升,實際使用時也能明顯縮短等待時間。
此外,當上下文超過 6.4 萬(64K)Token 之後,iPhone 會變成負責另一件事:「幫 Mac 分擔記憶體壓力」。
AI 讀過的內容,會留下叫做 KV Cache 的暫存資料,可以把它想成 AI 的「筆記」。內容越長,這份筆記就越大,也會吃掉越多記憶體。對 24GB Mac 來說,載入模型之後,剩下的記憶體大約只夠保存 64K 的 8-bit KV Cache,再長就容易塞不下。
這時 Backburner 不再把模型切成兩邊運算,而是改由 Mac 自己跑完整模型,再把較舊的一部分 KV Cache 搬到 iPhone 儲存和處理。簡單來說,就像幫 Mac 接上一個「會自己幫忙查資料的外接筆記本」,讓更多上下文不用全部擠在 Mac 的記憶體裡。
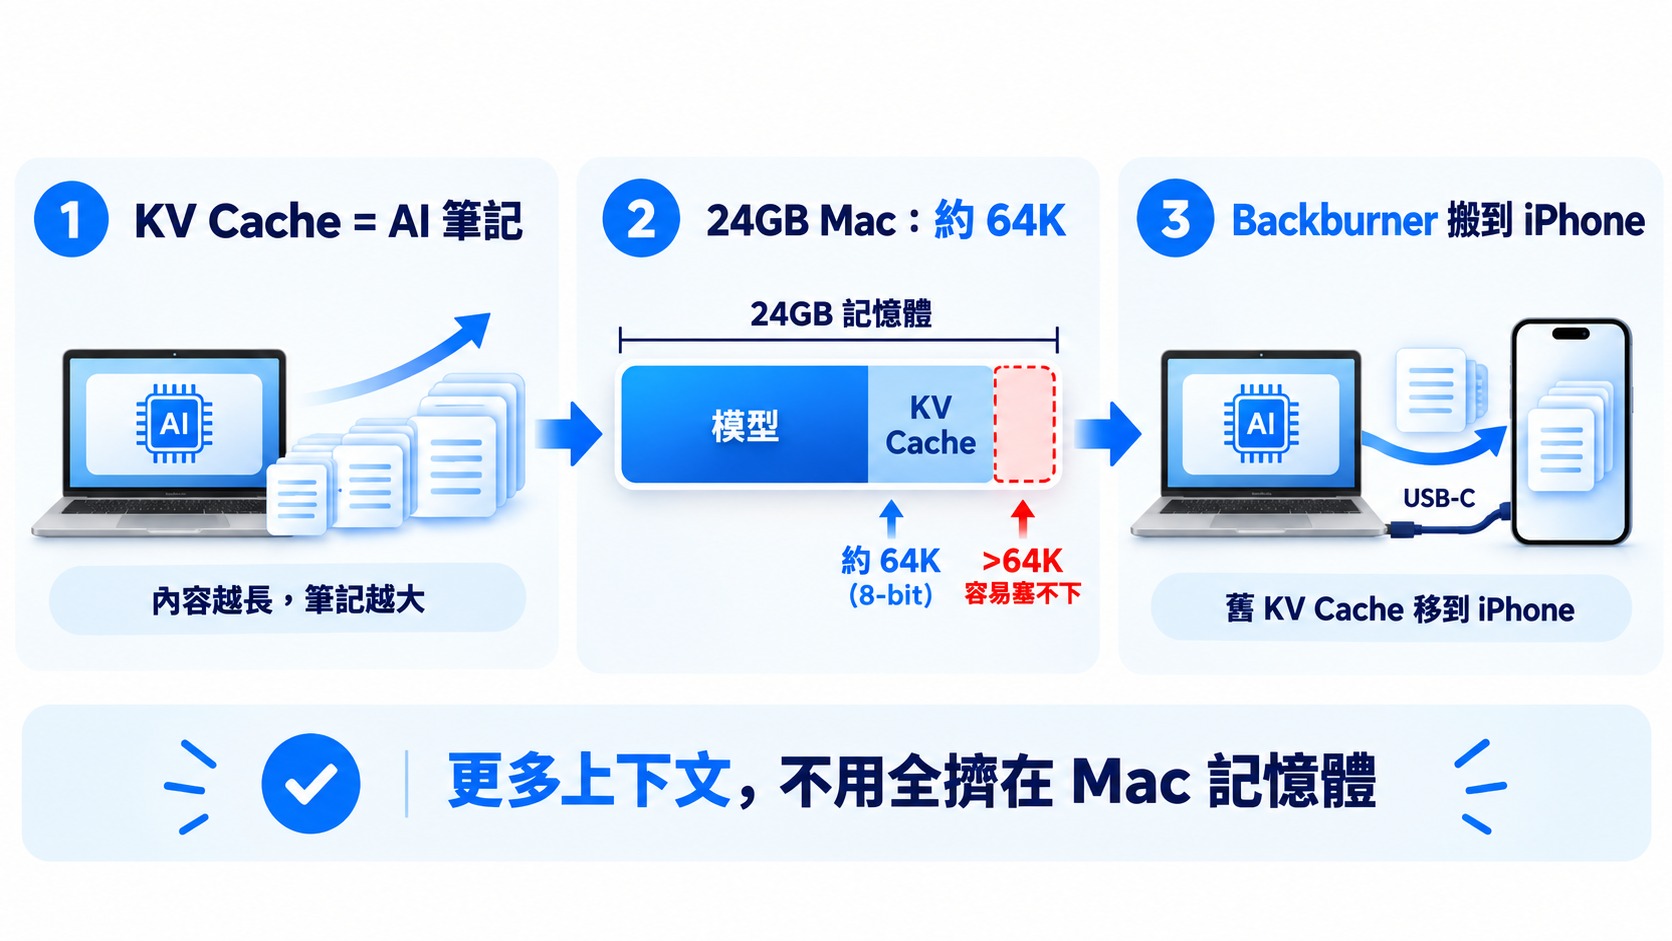
開發者目前實際測到,8-bit KV Cache 可以跑到 128K,4-bit 則能到 140K。相比之下,同一台 Mac 如果完全不靠 iPhone,8-bit KV Cache 大約只能撐到 64K。
專案公開後不久,Backburner 又加入了 Split Decode 模式,進一步讓只有 8GB 記憶體的 Mac,也能搭配 iPhone 運行 Qwen3.8-27B。
做法同樣是把模型拆給兩台裝置一起處理:Mac 負責前面的模型層,iPhone 則接手剩下的層數和最後的輸出,因此每產生一個 Token,都需要兩台裝置共同完成運算。
當然,速度部分沒很快,實測結果顯示,文字生成速度約為 3.9 Token/s。
每秒不到 4 個 Token 當然不算快,但對只有 8GB 記憶體的入門款 Mac 來說,原本 27B 模型無法完整載入,現在卻能靠 iPhone 分擔後成功跑起來。
有興趣的人,可到 Backburner 專案了解更多。