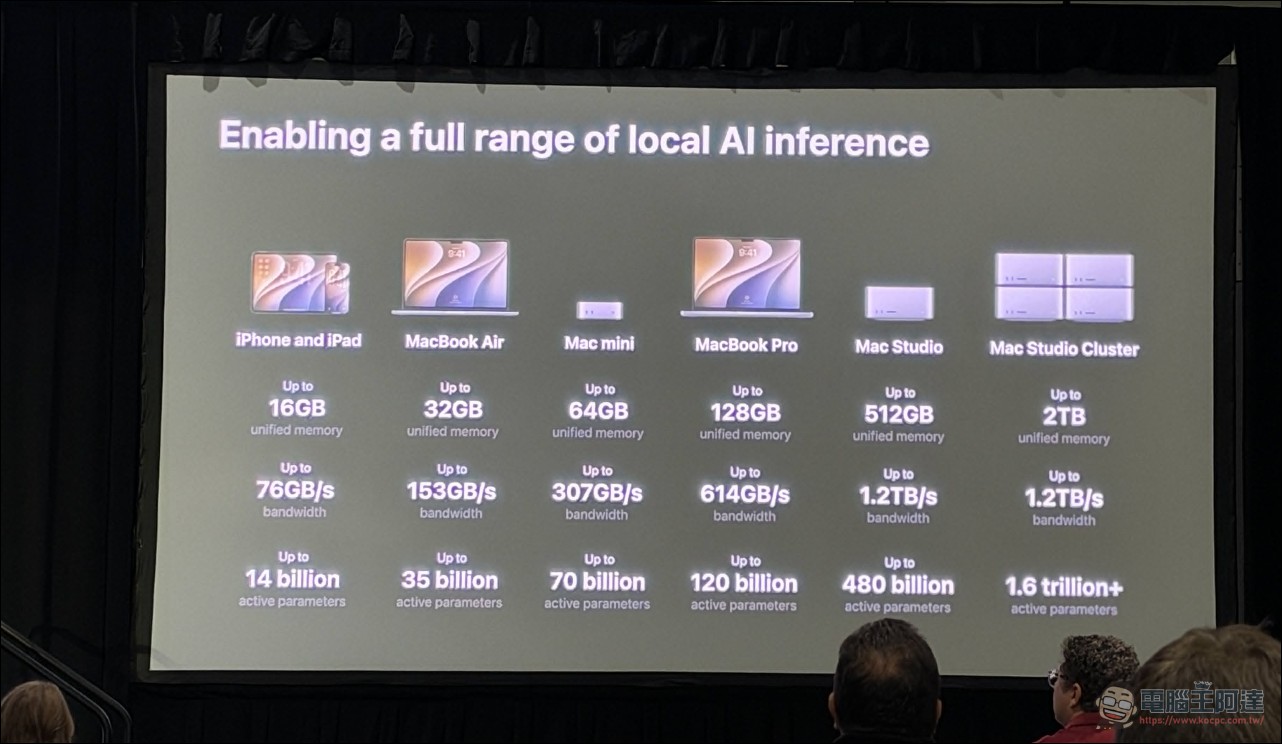
網路上很多蘋果用戶經常以 Mac 的統一記憶體適合跑本地端 AI 大模型,但似乎沒有任何人講清楚可以跑多大的模型。近日 Apple 把「哪一台機器能跑多大的模型」寫成了一張表,列出從 iPhone、iPad 一路到 Mac Studio 叢集的統一記憶體上限、記憶體頻寬與可承載的模型規模,最高一階寫著 1.6 兆個啟動參數。
六個欄位,一張表看完
表上六個產品線,每一欄都給了記憶體、頻寬與模型規模三個數字:
- iPhone 與 iPad:16GB 統一記憶體、76GB/s 頻寬,最高 140 億個啟動參數
- MacBook Air:32GB、153GB/s,最高 350 億個
- Mac mini:64GB、307GB/s,最高 700 億個
- MacBook Pro:128GB、614GB/s,最高 1,200 億個
- Mac Studio:512GB、1.2TB/s,最高 4,800 億個
- Mac Studio 叢集:2TB、1.2TB/s,1.6 兆個以上
Apple has shared a chart of their on-device AI capabilities across their product lines pic.twitter.com/yTGu5tDeko
— Aaron (@aaronp613) September 24, 2026
Mac mini 與 Mac Studio 的數字,Apple 自己寫過
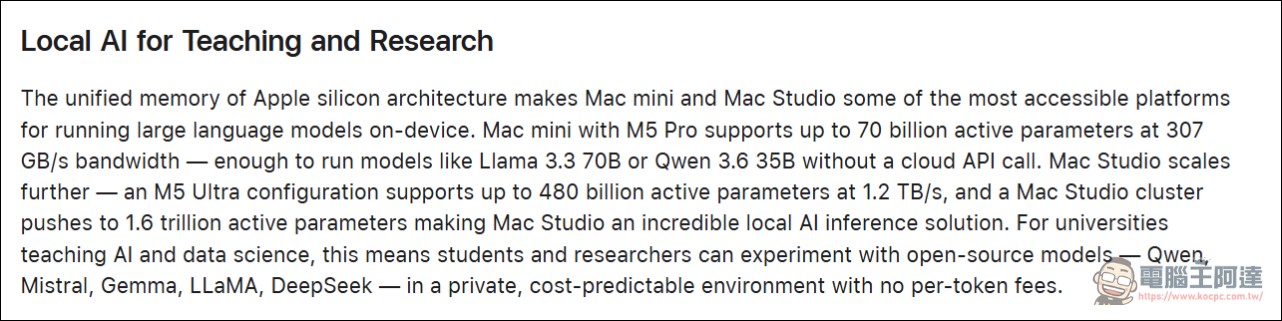
依照 Apple 教育社群由顧問工程師 James Garringer 撰寫主題是校園採購的文章,文中寫明 M5 Pro 版 Mac mini 支援最高 700 億個啟動參數、307GB/s 頻寬,足以在本機執行 Llama 3.3 70B 或 Qwen 3.6 35B,不需要呼叫雲端 API;M5 Ultra 版 Mac Studio 支援 4,800 億個啟動參數、1.2TB/s,多台串成的叢集則推進到 1.6 兆個啟動參數。文章列出的用途是大學的 AI 與資料科學課程,學生與研究人員可在私有環境裡實驗 Qwen、Mistral、Gemma、LLaMA、DeepSeek 等開源模型,不必按 token 計費。
表上 Mac mini 那一欄,對應的是 M5 Pro 配置。2 奈米製程的 M6 內建雙 16 核心神經網路引擎、GPU 每核心都帶神經網路加速器,統一記憶體最高 32GB、頻寬最高 170GB/s;要拿到 64GB 與 307GB/s,得選 M5 Pro 版本,也就是表上列出的那一階。我們最近也入手了一台 Mac mini M6 32GB 版測本地端(之後會出詳測影片),大家瞭解一下就好,原則上四萬多的機器體驗也沒有很好。
手機那一階:76GB/s 的門檻
表上為 iPhone 與 iPad 開出的條件是 16GB 統一記憶體與 76GB/s 頻寬,A20 Pro 的記憶體頻寬已達 115.2GB/s,高於表上列的數字。所以可能是以最低能支援的機型做為基準。
Mac Studio 的硬體底子
4,800 億那一階靠的是 M5 Ultra。這顆晶片以 UltraFusion 串起四個晶粒,CPU 最高 36 核心、GPU 最高 80 核心且每核心內建神經網路加速器、神經網路引擎 32 核心,統一記憶體最高 512GB,記憶體頻寬 1.2TB/s,比 M3 Ultra 高出 50%。Apple 稱其 AI 峰值算力可達 M3 Ultra 的 4.5 倍,在 LM Studio 中的提示處理快上 4 倍。這些數字都是出自 Apple 自行公布的測試結果,不是第三方實測。
1.6 兆怎麼湊出來:Thunderbolt 5 加上 RDMA
單機裝不下的模型,靠多台機器分攤。Apple 在 WWDC26 議程「Explore distributed inference and training with MLX」中把整套架構講得很清楚:macOS 26.2 起支援 Thunderbolt 5 上的 RDMA,資料可直接從一台機器的記憶體寫進另一台,省掉大部分 CPU 與作業系統的搬運成本;往上一層是 Apple 自家的開源集體通訊函式庫 JACCL,負責節點之間的資料交換與結果合併;最上層才是開源框架 MLX,負責把模型切開、派工給各台機器。
LM Studio 與 Apple 聯手在 WWDC 展示 4 台頂規 Mac Studio 跑 1 兆參數 Kimi K2.6 模型
Apple 的示範用四台 M3 Ultra,以 270 億參數的 Qwen 3.6 測試,叢集的 token 生成速度接近單機的 3 倍;微調 90 億參數的 Qwen 3.5 時,單機約每秒 180 個 token,叢集約 600 個。Apple 在 Mac Studio 的官方說明裡也用同一種說法,指分散式 AI 推理效能相較單一系統最快可達 3 倍,並註明實際結果依模型大小與架構而異。不過要注意的是這樣的組合至少要兩百萬台幣以上,話雖如此,但依然是目前最便宜的本地工作站級組合。
「啟動參數」不是記憶體佔用量
表上每一階的單位都是啟動參數,這個詞要放在混合專家(MoE)模型上才讀得懂。MoE 模型由多個專家子網路組成,處理每個 token 時只動用其中幾個,總參數量涵蓋全部專家,啟動參數量只算當下用到的那一小塊。模型要跑得起來,看的是總參數在指定的量化精度下塞不塞得進統一記憶體,還要留空間給上下文視窗與作業系統;速度則跟啟動參數走。
Apple 的示範裡就有現成例子。開源模型 Kimi 2.6 的總參數為 1 兆,即使壓到 8 位元量化,光權重就要約 1TB 記憶體,單台 M3 Ultra 裝不下,四台才夠。表上那句 1.6 兆,讀成「這個記憶體規模能容納多大的模型」比較貼近實情,它沒有交代量化精度與上下文長度,也沒有交代速度。
1,200 億那一階的對照組
表上 MacBook Pro 那一欄給的是 128GB 統一記憶體、614GB/s 與最高 1,200 億個啟動參數。這個組合與同樣搭載 128GB 記憶體的 RTX Spark 筆電放在同一級,兩邊能跑的模型規模相當。挑機器的分界線因此不在 GPU 核心數,而在記憶體容量與頻寬:統一記憶體讓 CPU 與 GPU 共用同一個池子,模型不必拆開搬進顯示卡記憶體(不過 Apple 會因為不支援 CUDA 生態在表現上相對吃虧)。
結語
這張表回答的是記憶體夠不夠,沒有回答跑得順不順。挑機器時把模型、量化精度與上下文長度放在一起算,比記住 14B 還是 480B 的標籤數字有用得多。Apple 這次至少把選購的起點講清楚了:先挑定模型,再回頭挑記憶體。不過蘋果跑本地端 AI 的優勢是記憶體大,劣勢是因為生態問題(靠大神燃燒熱情)所以表現不會比 NV 好,但只要你本夠厚,都是「能跑」,不會有連測試的機會都沒有,就看你怎麼選擇了。