
真沒想到,Google 這個月月初才發表大家等待許久的 Gemini 4 Argon 旗艦模型,不到一個月的時間,下一代又亮相了,稍早正式宣佈推出下一款前沿模型 Gemini 4 Carbon,從程式開發、資安防護與長時間自主執行任務都有提升,甚至在 Artificial Analysis 排行榜中,Carbon 以 59 分拿下第一,比 Argon 高出 9 分。除此之外,找漏洞、驗證漏洞到修補漏洞三項資安測試,也都刷新目前最佳成績。
但奇怪的是,這次一樣維持在 Gemini 4,只是名字變成 Carbon,看起來應該只是 Argon 的下一個新版本,而不是真正全新一代最強 AI 模型。
Google 發表 Gemini 4 Carbon:Artificial Analysis 評測登頂、資安能力大躍進,還能連續自主工作好幾天
稍早 Google 在官方部落格發表 Gemini 4 Carbon,成為 Argon 之後的 Gemini 4 系列新旗艦模型。
這次升級主要有四個重點:
- 綜合效能:在 Artificial Analysis Intelligence Index v5.0 拿到 59 分登上第一
- 資安能力:在找漏洞的 SEC-bench Pro、驗證漏洞的 ExploitGym、修補漏洞的 CWE-bench 三項測試都拿下目前最佳成績
- 長時間自主任務:Google 內部團隊觀察到它能連續工作好幾天
- 可靠度:無依據的主張減少約一半,間接提示詞注入攻擊的成功率降到 0%
Google AI Studio 負責人 Logan Kilpatrick 在 X 上表示,相較兩週前才推出的 Argon,Carbon 是一次很大的躍進
首先來看綜合效能,在 Artificial Analysis 的榜單上,Gemini 4 Carbon(High)拿到 59 分,前一代 Argon 是 50 分,兩代相差 9 分。對手方面,Anthropic 的 Claude Opus 5.5 是 58 分,OpenAI 的 GPT-6 Astra 是 57 分,不過 Carbon 雖然登頂,但也只有領先第二名 1 分,前三名的差距相當接近,所以只要 Anthropic 和 OpenAI 再推新版本,可能又會被超越:
| AI 模型 | Artificial Analysis Intelligence Index v5.0 |
|---|---|
| Gemini 4 Carbon(High) | 59 |
| Claude Opus 5.5(Max with fallback) | 58 |
| GPT-6 Astra(Max) | 57 |
| GPT-6.1 Sol(Max) | 55 |
| Gemini 4 Argon(High) | 50 |
Google 自己則公布 17 項測試成績,Carbon 在其中 15 項拿下最高分。
程式開發測試 FrontierSWE 2 中,Carbon 拿到 61.2%,前一代 Argon 是 55.0%,不過 GPT-6 Astra 是 65.5%、Claude Opus 5.5 是 62.3%,因此 Carbon 目前還是都輸。電腦操作測試 OSWorld-2.1 中,Carbon 拿到 81.5%,比 Argon 的 74.7% 提升不少,但競爭對手 Opus 5.5 的分數是 87.2%。
| 類別 | 測試項目 | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|---|
| 綜合能力 | AA Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| 綜合能力 | Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% | — |
| 程式代理 | SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% | 2.9% |
| 程式代理 | FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| 程式代理 | Terminal-Bench 4.0(AA) | 65.2% | 57.1% | 59.1% | 59.6% | 52.0% |
| 電腦操作 | Agents’ Last Exam v1.1 | 77.4% | 69.0% | 73.1% | 71.6% | — |
| 電腦操作 | OSWorld-2.1 離線子集 |
81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| 知識型工作 | AutomationBench Zapier |
53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| 知識型工作 | Vending-Bench 2 帳戶餘額(美元) |
$16,484 | $13,718 | $15,515 | $9,235 | $5,422 |
| 多模態理解 | Chartography | 72.5% | 71.6% | 71.0% | 66.3% | 46.2% |
| 多模態理解 | Blueprint-Bench 2 相似度分數 |
58.6% | 54.4% | 49.7% | 51.2% | 41.9% |
| 長文推理 | GraphWalks 25.6 萬~100 萬 Token |
96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| 科學與數學 | RiemannBench | 80.0% | 76.0% | 72.0% | 69.6% | 65.6% |
| 科學與數學 | Terminal-Bench-Science 0.1(AA) | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
再來是資安能力, Google 把資安防禦拆成三個階段:找出漏洞、確認漏洞是不是真的有風險、從根本原因把漏洞補起來,Carbon 在這三個階段的代表性測試都拿到目前最佳成績。
如果用居家安全來比喻,過去的 AI 比較像是幫你巡一圈房子,告訴你「後門的鎖好像怪怪的」。Carbon 則能進一步試試看小偷是不是真的能從那扇門進來,確定有風險之後,再幫你換上新鎖並確認鎖得上。
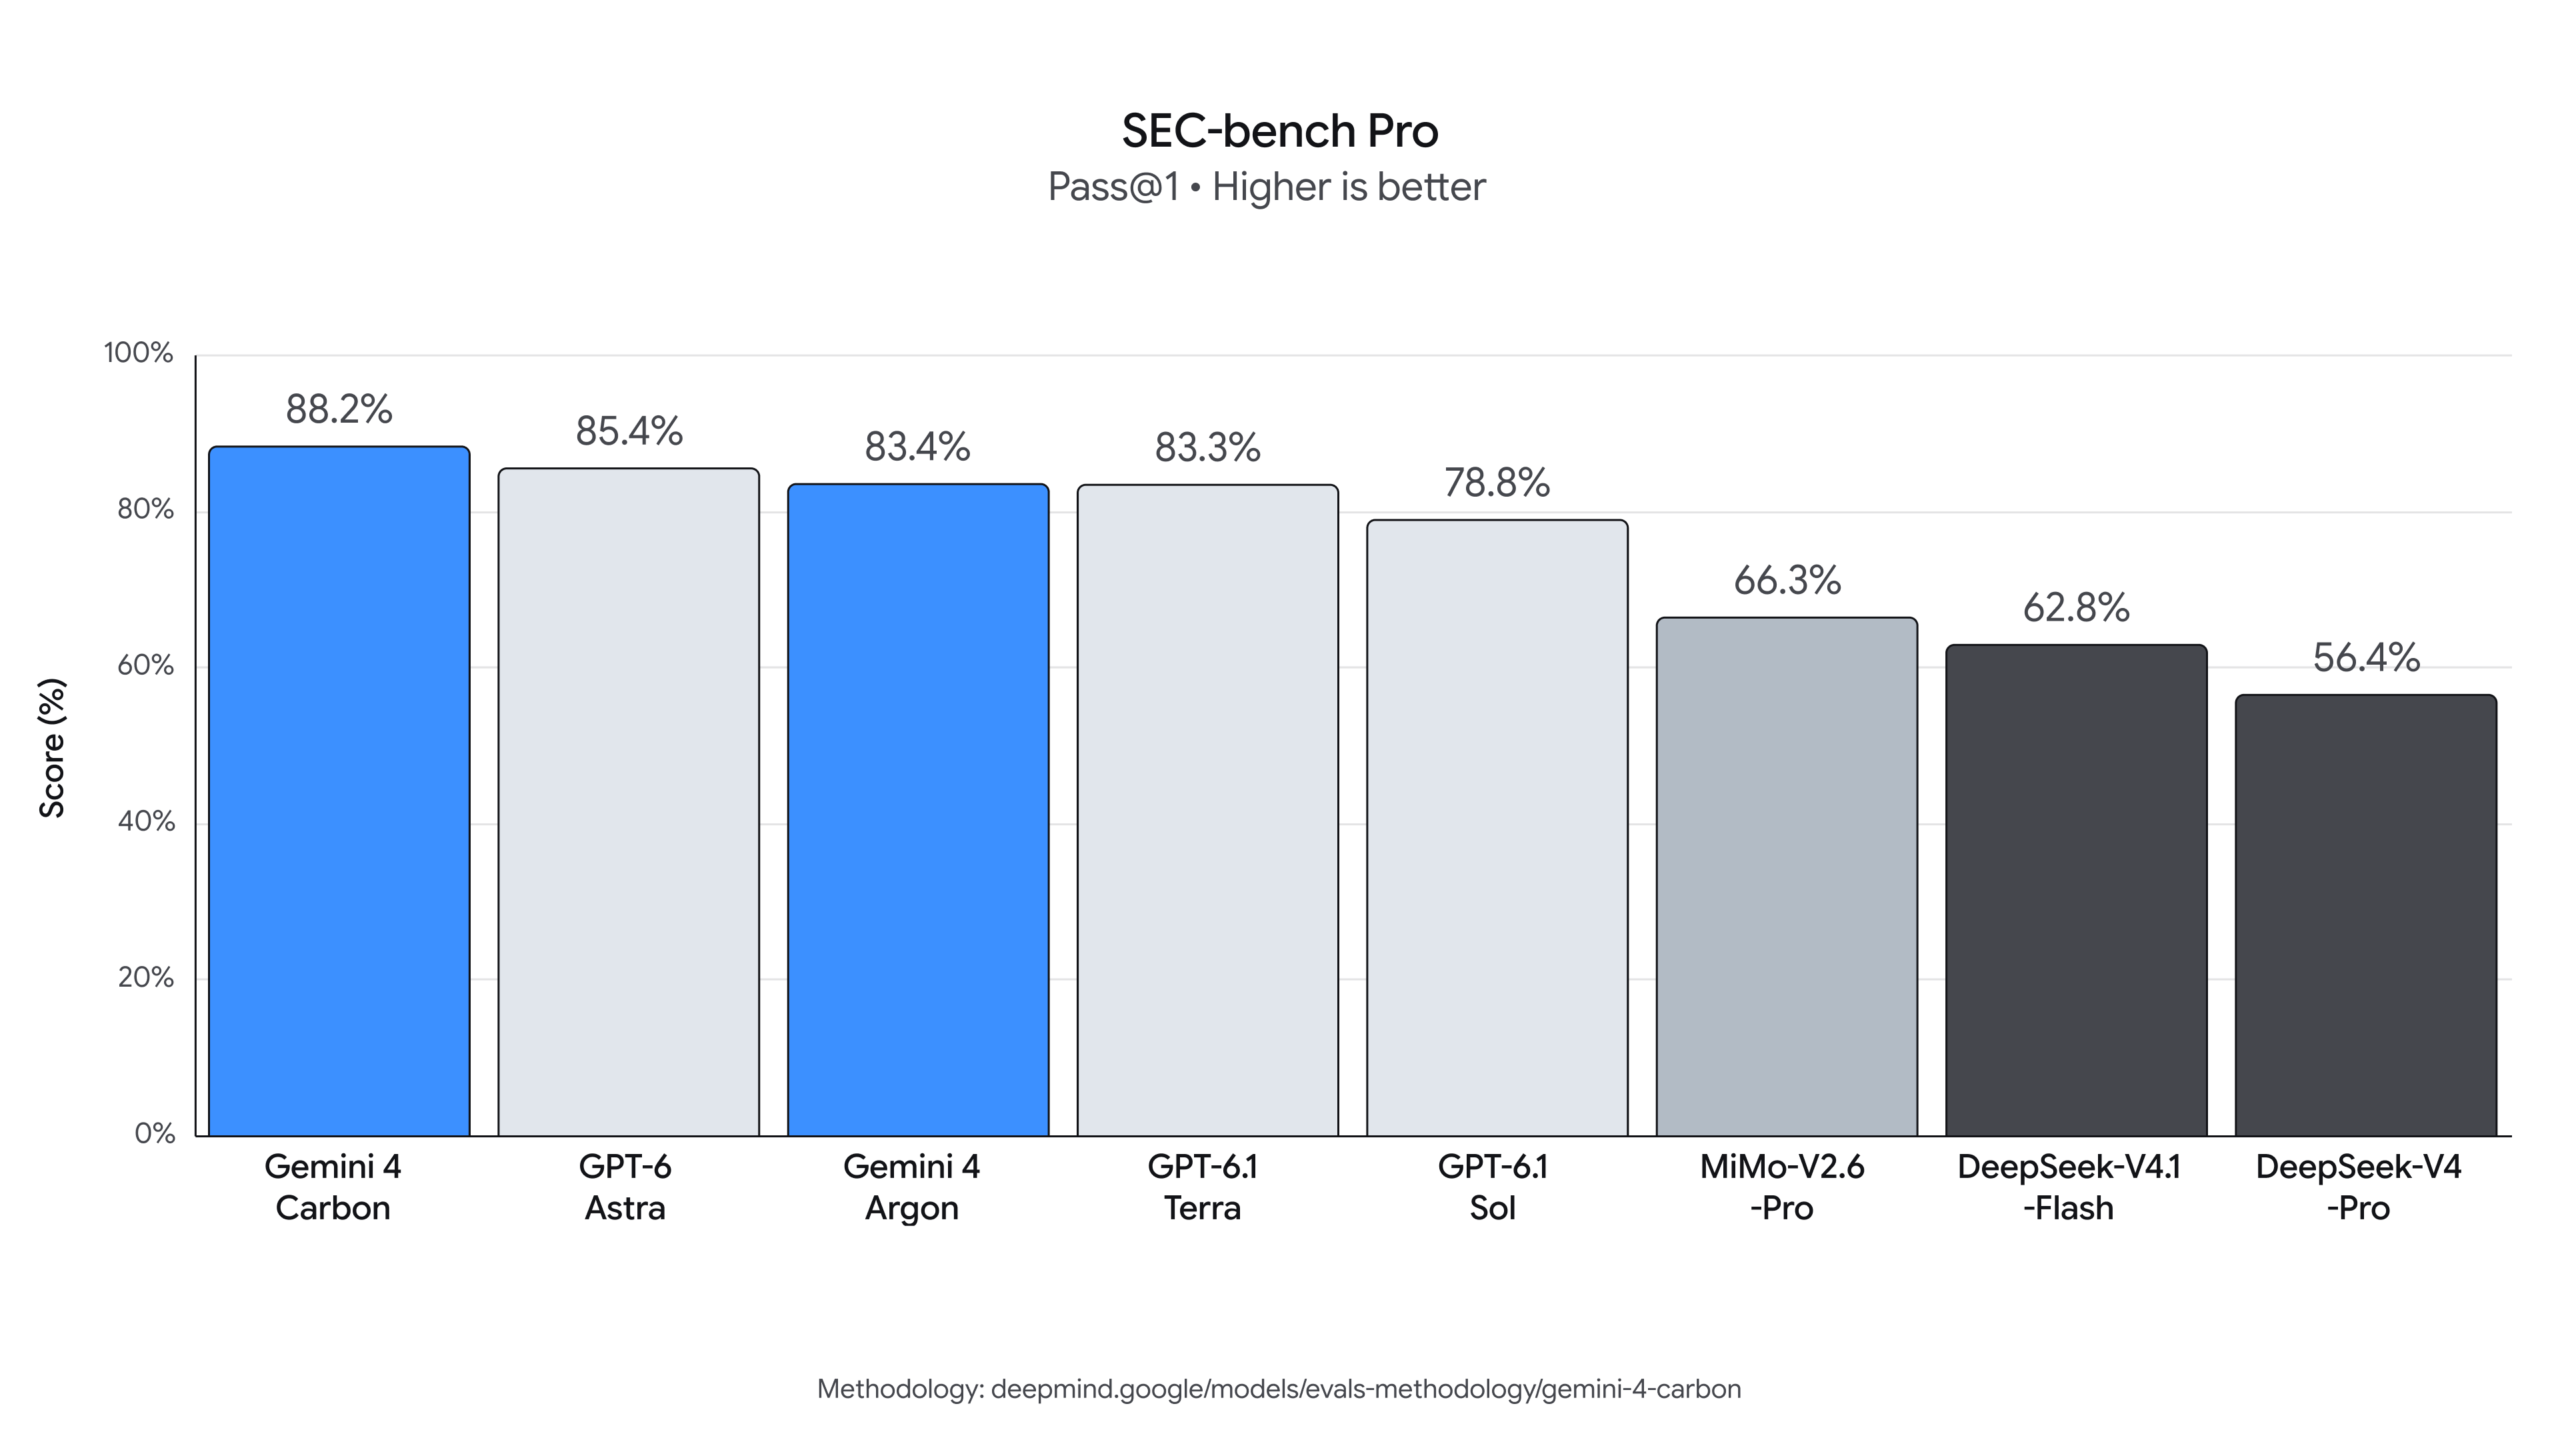
測驗 AI 能不能在真實世界的軟體中,自主找出藏很深的複雜漏洞 SEC-bench Pro 中,Carbon 獲得 88.2%,比 Argon 和 GPT-6 Astra 都還高:
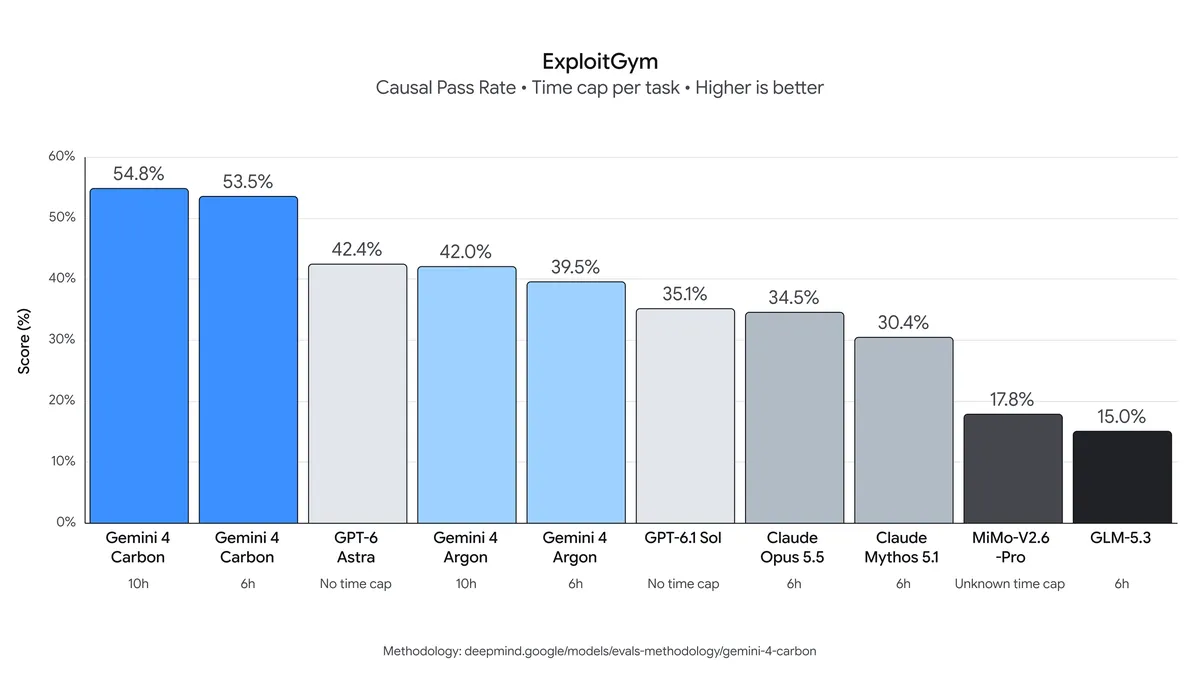
測驗 AI 能不能實際利用漏洞的 ExploitGym,Carbon 一樣是第一,不僅大幅領先 Argon 的 42.0%,也比 GPT-6 Astra 和 Claude Opus 5.5 高出不少,進步 12.8%,是安全測試三項中幅度最大的一項:
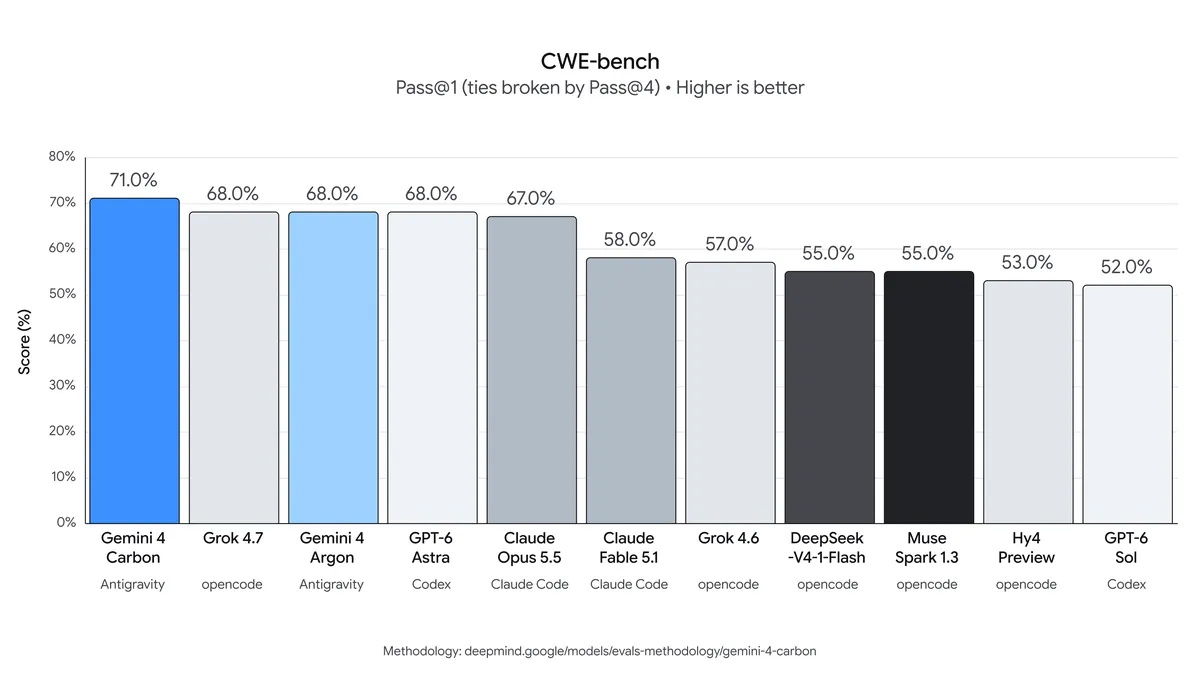
CWE-bench 成績則是 71.0%:
Google 也分享幾個內部數據,在 Google 自己的測試中,Carbon 生成安全程式碼的成功率是 Argon 的兩倍以上。Google Chrome 團隊回報,在產生高品質修補程式這件事上,Carbon 的表現比另一家 AI 實驗室的大型前沿模型好 10 倍以上。
長時間自主執行任務部分,Google 表示,內部團隊觀察到 Carbon 能連續運作好幾天,遇到死路時會改試其他解法,而不是卡住就停下來。它處理的是像在大型程式碼庫和底層系統中,追查細微錯誤的根本原因,並修補這類多步驟工程任務。
從測試數據也能看出這點,像是 Terminal-Bench 4.0 的成績 Carbon 從 Argon 的 57.1% 進步到 65.2%。電腦操作測試 Agents’ Last Exam v1.1 從 69.0% 提升到 77.4%。需要在 25.6 萬到 100 萬 Token 的超長內容中推理的 GraphWalks,Carbon 也拿到 96.2%,全都領先對手。
至於很多人重視的「可靠度」,Google 內部測試中,Carbon 缺乏依據的主張比 Argon 減少約一半。資料不足時,它會直接在成果裡註明限制,或列出還缺哪些東西才能完成,而不是硬編答案交差。
其他幾項改進還有:
- 指示不明確時先確認:遇到模糊的需求,Carbon 會先去找相關資料,把發現的矛盾告訴使用者,再決定怎麼做,而不是自己猜一個方向就往前做。
- 不越權、也不偷懶:越權執行的行為減少 26%,該做的工作沒做完整的情況減少 29%,執行多步驟計畫時更能守在任務範圍內。
- 不鑽測試漏洞:在 Terminal-Bench 4.0 中,成功作弊的比例降到 0.0%,嘗試作弊的比例只有 0.4%;Google 內部實際寫程式的環境裡,高嚴重度的行為偏差警示也減少將近 80%。
- 抵抗提示詞注入攻擊:提示詞注入是把惡意指令藏在網頁、文件裡,騙 AI 照著做。在 Gray Swan 的間接提示詞注入測試中,攻擊成功率從 Argon 的 0.7% 降到 Carbon 的 0.0%,擋下了所有受測的攻擊。
不過很可惜的是,目前一般使用者還使用不到。這次一樣採取審慎的分階段開放,並參與美國政府自願性的模型發布前測試。本週起先提供給部分資安防禦人員,之後透過 Fairwind Program 逐步擴大到其他可信任的合作夥伴,持續蒐集回饋、調整防護機制後,才會透過 Google 的產品提供給開發者、企業和一般消費者,但沒有公布全面開放的日期。