在模型還沒跑出成績前,就先簽下一張一千億美元以上的支票,這筆帳要怎麼算?近日 Meta 執行長 Mark Zuckerberg 與 Meta Superintelligence Labs(MSL)負責人 Alexandr Wang(汪滔)接受 Stripe 共同創辦人 John Collison 主持的 Cheeky Pint podcast 訪談,把這場千億賭局的幕後祕辛攤開在陽光下。這集選在Meta 旗下最新旗艦模型 Muse Wonder 發表之際上架。兩人對著鏡頭喝著啤酒,把從 Llama 4 失利到 MSL 練成的過程講得比官方新聞稿深入得多。
模型還沒見到,支票已經開出
節目開場就是最有戲劇性的一幕,Zuckerberg 回憶去年底的決定:「我們對進展相當興奮,但模型還沒看到。我們就要開出這張大概一千億、兩千億美元的支票。我轉頭問 Alex:你確定這會成功?」
買茶管家與 MMA 教練
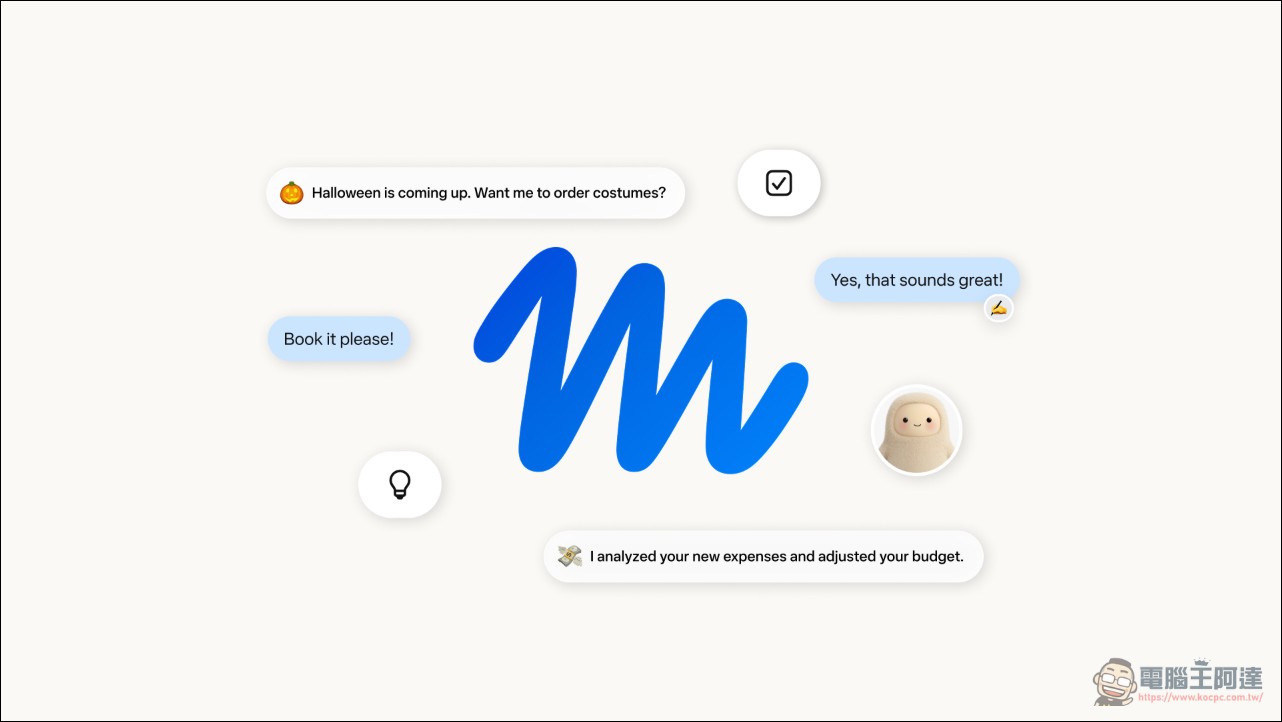
近日 Meta Muse 在美國紅透半邊天,被視為是 Meta 近期最成功的 AI 產品,Zuckerberg 與 Wang 自己就是重度使用者。被問到最喜歡的 Muse 用途時,Wang 說他的 Muse 叫 Oiler,專門從日本、台灣的偏遠茶園搜刮冷門茶葉,每週固定買一輪寄回來。Zuckerberg 的答案更狂:他在健身房裝了攝影機,讓 Muse 在 MMA 每回合之間 60 秒的空檔當教練,給出重心、髖部位置這類具體建議,「你在這裡沒拿到 underhook,會被翻過去」。
技術上 Muse 會自己抽影格分析,沒人教它切幀;Zuckerberg 還一直催它「你花 30 秒才回我,我只剩 60 秒休息,快一點,自己最佳化自己」。他把這當成模型的 coding 能力測試,agent 內部正在寫一整條影像處理管線,「未來每個人都在寫大量的程式碼,只是他們不知道自己在寫程式碼」。
一個買茶、一個打拳,都把多模態理解、即時推理與程式生成壓進日常場景。Zuckerberg 把 MMA 教練列為產品的正式評測項目,呼應「模型即產品」的主張。
模型即產品
「產品越來越薄,模型越來越像產品本身。」MSL 內部有句口頭禪:「模型本身就是產品」。他以 Muse 為例,這款 agent 最困難的產品工作不在介面,而在資料隱私與安全模型的設計,哪些東西可以連、哪些資料怎麼處理,才是使用者買單的關鍵。當模型能力直接決定體驗天花板,產品設計的重心就從介面轉移到模型行為本身。
Muse Wonder 登場:主動記憶與主動專注
Wang 把 Muse Wonder 定位成個人與專業 agent 任務的最強模型,官方量測在這類任務達到業界領先,寫程式能力也有進步。
Meta 發表最強 AI 模型 Muse Wonder!主打 AI 代理、長期記憶與程式開發,多項跑分贏過 Fable 5.1、GPT-6 Astra
兩個招牌能力是:
- 主動記憶(Active Memory):模型自己知道哪些資訊該留下、哪些該壓縮,跨天甚至跨月保留脈絡。Wang 直言市面上的 agent「用久了記憶體一堆 bug」,所以他們連模型帶系統一起重新設計記憶機制
- 主動專注(Active Focus):任務愈長、愈模糊、挫折愈多,模型愈要能撐著做完,對應使用者不斷拉高任務複雜度後的最大抱怨
上架策略雙軌制:Muse Spark 維持免費,Wonder 服務成本高,初期放在付費訂閱,開發者可透過 API、OpenRouter 或 Muse Code 取得;更高階的 Wonder Full 需訂閱 Muse Code,實測方案月費約 50 美元(約新台幣 1,625 元)。Zuckerberg 的終極目標是把 Wonder 等級能力塞回 Spark 的體積,「到時候就能服務全世界幾億人」,把記憶與持久性做成模型原生能力,對應 agent 用戶最普遍的抱怨。付費牆的出現,代表 Muse 開始要自己養活自己。
前沿模型怎麼煉成:預訓練吃玻璃,RL 精雕
John Collison 請兩人拆解訓練流程。預訓練階段是吞下巨量多模態資料,文字、影像、影片、音訊,外加自有語料;Wang 特別提到想讓模型擅長法律、稅務、金融這類專業問題,就得刻意補進對應的領域語料。Zuckerberg 引用研究員 Rune 的推文形容這份工作:「預訓練團隊是一群啃著玻璃、凝視深淵的人。」Wonder 把極高比例的算力押在預訓練上,錯一步代價極大。
後訓練是先監督微調、再上強化學習(RL)。Wang 形容 RL 跟預訓練哲學相反,要的是小而精的資料與環境設計;最危險的是 RL 的最佳化壓力逼模型走歪路,在只有靠作弊才能過關的環境裡學會不對齊的捷徑,所以環境挑選必須小心。
至於評測,兩人對公開跑分都很不客氣。Wang 說:「你去挖供應鏈就會發現,很多公開評測只是某個博士生念博士時順手做的工具。把心思全放在跑分上,等於把整家公司的產品思考外包給剛好做出爆紅測試的博士生。」MSL 因此把重心轉往自家評測,還在研究報告裡量化了「big model smell」指標,用分佈內外的表現落差判斷模型有沒有「大模型感」,與盲目刷分的 benchmaxing 恰好相反。
千億賭局的帳本:一座電廠級叢集一年 4,875 億元
接著談到 AI 千億美金等級的「豪賭」,其賭注的具體規模是這樣:俄亥俄州的 Prometheus 叢集正在擴到 1GW 以上,路易斯安那州的 Hyperion 叢集目標 5GW。Zuckerberg 特別澄清這兩個案子早於 MSL 成立,2023 到 2024 年間就定案。
帳怎麼算?Zuckerberg 一次給完:「運轉一座 1GW 叢集一年,大概是 150 億美元等級」(約新台幣 4,875 億元),把前期建設的資本支出算進來「差不多 500 到 600 億美元」(約新台幣 1.63 兆到 1.95 兆元)。而且這還只是一座叢集、一個訓練環節,小規模實驗的研究成本又是差不多的數目。
壓力最大的時刻在去年底的夏威夷高層會議。Wang 回憶財務長 Susan Li 好幾次把他拉到旁邊:「我要提醒你,如果這模型做不出來,在財務上會非常非常糟。我必須讓你記住,這個模型必須成功、必須夠好。成了,一切都好;沒成,那就真的糟到不行。」
Zuckerberg 的底氣來自冪律(Power Law)思維,Wang 說他對冪律的內化程度少有人能比。Zuckerberg 的盤算是:「如果 AI 整體成功,外面多的是人搶著要我們的算力,租金還能開得比成本高。要讓這筆投資失敗,得是 AI 整體都失敗才有可能。」就算最壞情況發生,「我們的核心業務只要靠這些模型多長幾個百分點,就撐得起研發支出」。
下限保護的邏輯是這場賭局的保險絲:算力是通用資產,模型輸了算力還在。加上 GPU 用到全額折舊後還能續役,Zuckerberg 甚至認為現在一張 H100 比去年還值錢。
MSL 從零到一:Llama 4 之後的四個決定
MSL 的誕生來自一次公開的挫敗。Zuckerberg 說 Llama 4 在 2025 年 4 月 4 日發表,4 月 20 日左右他就開始打電話徵詢意見,「我正在開會,突然收到 WhatsApp 訊息問有沒有空通話」,那是 Wang 找上門的起點。他坦言對 Llama 4 的軌跡「很不滿意」,最後的解法是把整個團隊重組。
John Collison 整理出這場重組的四個不尋常決定:
- 公開承認方向錯誤,該重開機就重開機
- 為人才付出天價,把 Wang 與一批頂尖研究員整批挖來
- 押注沒訓練過旗艦模型的人,Wang 做過 AI 公司,沒做過這件具體的事
- 清空行事曆兩個月,Zuckerberg「幾乎清掉一到兩個月行程,每天只做一件事:見研究員」
重組採完全重開機模式,交易讓 Meta 持有 Scale AI 49% 股份。創辦人執行長清空行事曆兩個月親自面試,動員規格在大公司極少見。四個決定指向同一個判斷:組織本身就是瓶頸,換人換腦袋比換策略更快。(編按:但找 Alexandr Wang 這種有點狂的人 All in 有點讓眾人意外)
缺乏安全感的超常發揮
Wang 形容這是一群「缺乏安全感的超常發揮者」:「我問大家三個月後會在哪裡,答案永遠是糟透了、我們完蛋了。」他會把這些預測錄下來,三個月後模型發表時再放給大家對帳。這招沒用,「他們還是一樣自我批判」,對 MSL 整體樂觀、對自己的專案永遠不滿意。用悲觀預測對帳管理研發節奏,比樂觀喊話務實:不確定性無法消除,自滿可以壓到最低。
扁平到沒有非技術主管
Wang 名下掛著兩百位直屬部屬,Zuckerberg 說重點在於「這裡沒有非技術主管」。Wang 解釋設計理念是反官僚,新進研究員全部直接向他報告,砍掉中間那層是防止人脫離第一線:「研究人員一旦從技術細節轉去做管理,就會以超乎想像的速度脫離技術現實。這個領域變化這麼快,那非常危險。」他的結論:「保持技術手感、親自用 agent、親自寫程式碼。」
結語
134 分鐘聽下來,這場訪談把 AI 競賽重新定義為資本與組織的雙重戰爭:先簽支票再看成果的困難模式創業、不抹花生醬的算力分配、沒有非技術主管的扁平組織,每一項都在跟傳統最佳實務唱反調。節目最後兩人給出的總結是「待在最前線,保持技術手感」,收尾喝的是 Zuckerberg 從都柏林扛回來的 Guinness 啤酒。當大家還在比誰的模型聰明,前線玩家已把戰場拉到算力與組織型態的層級,千億支票不保證成功,只保證入場券愈來愈貴。
篇幅關係無法收錄完整內容,僅摘要我個人覺得重要的點,有興趣的朋友可以好好聽聽這場訪談,有cc字幕: