幾個月前華為半導體業務部總裁何庭波今日在上海 IEEE ISCAS 2026 上發表「韜定律」,當時就講到可以在沒有先進製程的情況下,透過邏輯摺疊的方式讓半導體密度達到先進製程的水準。當時大部分媒體都認為這可能只是一個概念或吹牛皮的技術,不過在前陣子華為推出的三摺疊旗艦 Mate XT 2 裡面搭載的麒麟 9050 Pro 處理器中,當時中國科技頻道極客灣 Geekerwan 當時所發的性能測試就已經有相當明顯的進步。近日極客灣 Geekerwan 又發佈了新影片《邏輯摺疊深度解析!華為 Mate 90 系列韜晶片有多強?》,真的把麒麟 9050 Pro 處理器拿去實驗室切片,在 3D 空間重建內部結構,解開「邏輯折疊」的封裝之謎,再用 Mate 90 Pro Max 實測遊戲與續航。直接先講結論:這顆晶片用上下兩片晶粒「折疊」堆疊,在製程沒換代的前提下把電晶體密度拉高 28%,實測能效甚至贏過 Google 今年的 Tensor G6。
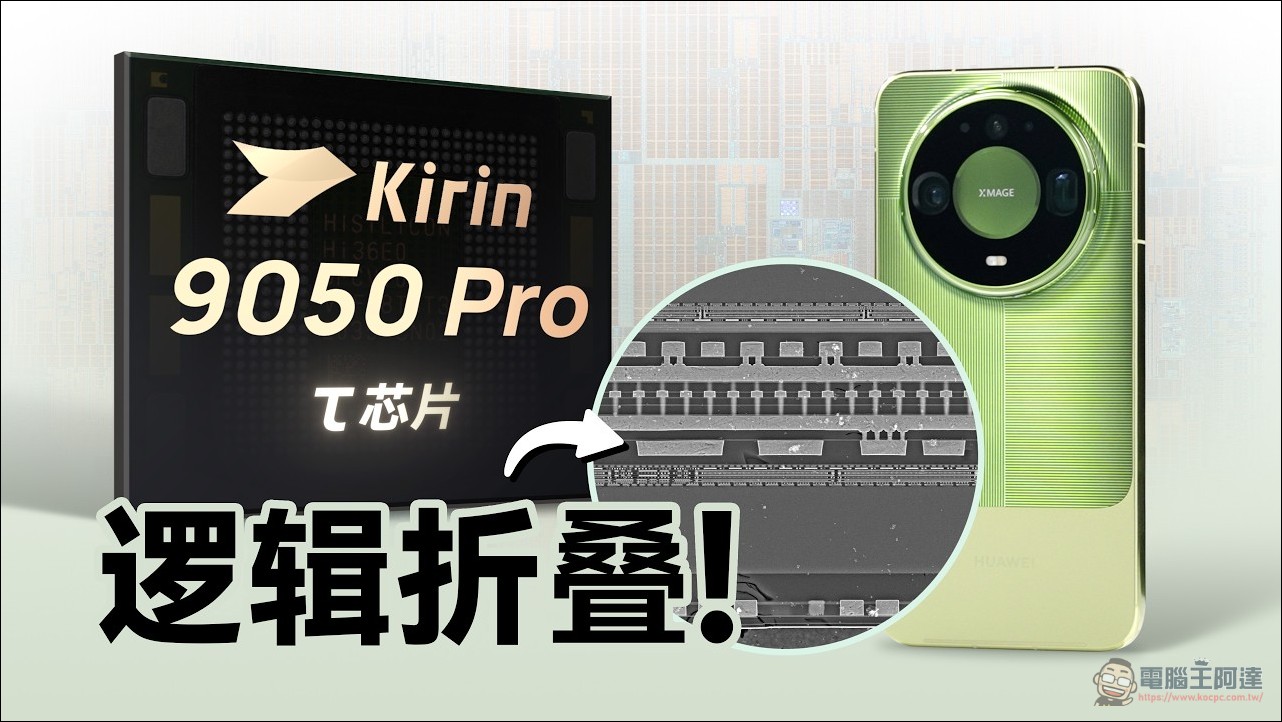
極客灣切片拆解華為麒麟 9050 Pro 邏輯摺疊技術
韜晶片家族:9030、9035 與 9050 Pro
華為 10 月 1 日發表的 Mate 90 系列共五款機型,全系出廠搭載 HarmonyOS 7,晶片陣容分三級:Mate 90 用麒麟 9030(8 核 12 線程,整機性能較前代提升 27%)、Mate 90 Pro 用麒麟 9035(規格近似 9030 Pro、調整峰值頻率,提升 20%)、Pro Max 及以上則是主角麒麟 9050 Pro,整機性能較上代旗艦提升 31%。
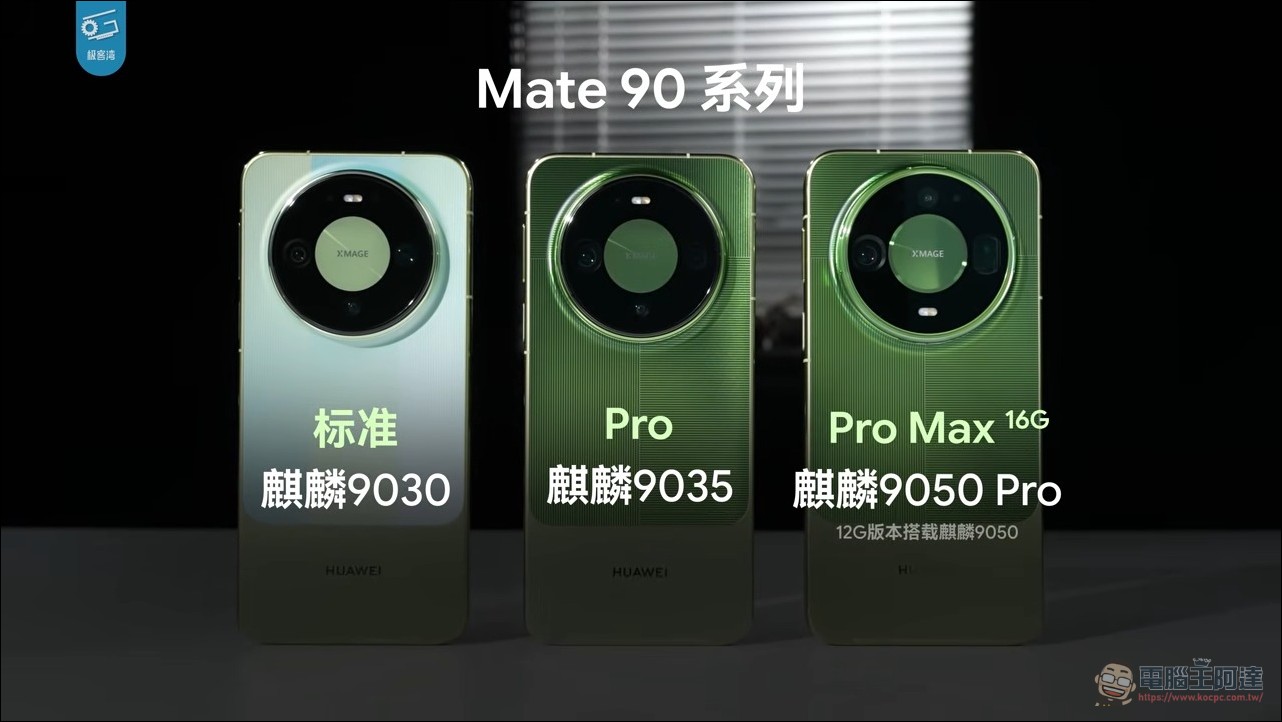
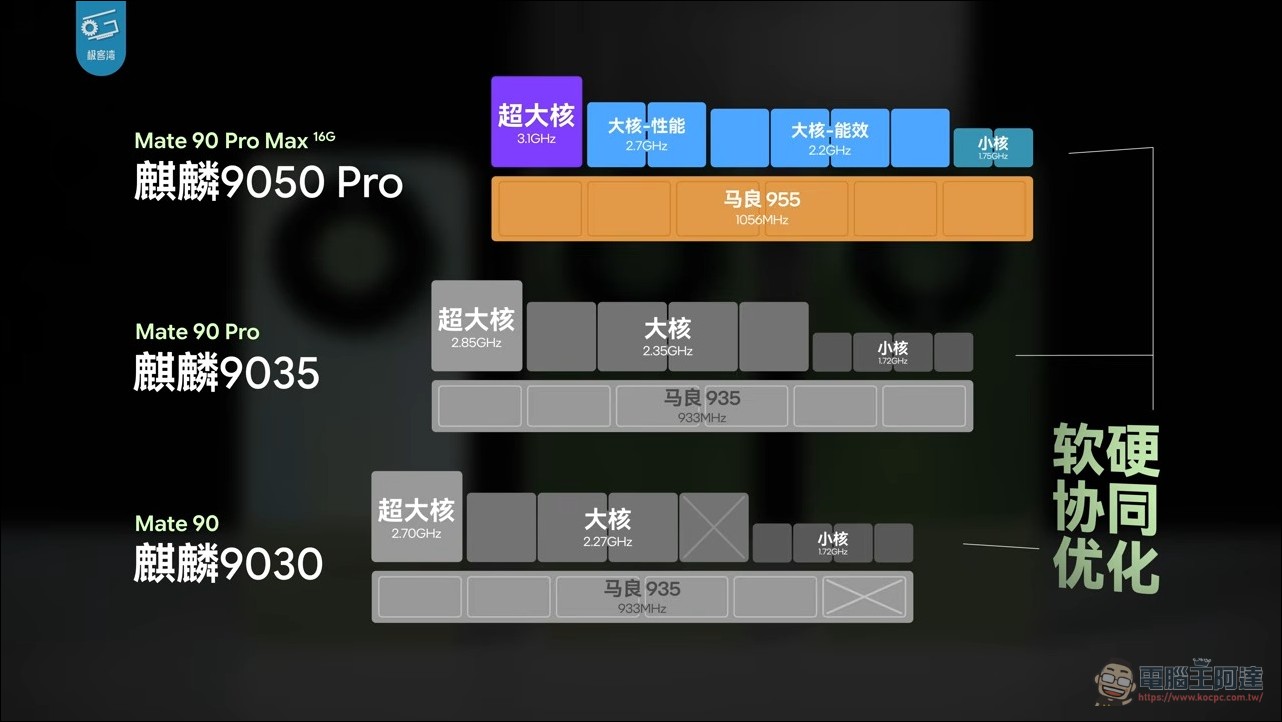
這代晶片有個統一的名字叫「韜晶片」,背後是華為自研的「韜(τ)定律」:用「時間縮微」替代傳統「幾何縮微」,在不依賴 EUV 曝光機的前提下提升性能,官方目標是 2031 年把韜定律晶片的電晶體密度做到與 1.4 奈米製程同等水準。9030 與 9035 都遵循韜定律但沒用上邏輯折疊,這項技術目前只屬於最旗艦的 9050 Pro。
切開來看:晶片漢堡與 8 萬根 TSV
極客灣把麒麟 9050 Pro 切片後看到的結構,和傳統晶片完全不同。一般晶片從基板往上一層層金屬層,頂端埋邏輯電路;9050 Pro 則是上下兩塊相向排布,中間用銅-銅混合鍵合(Cu-Cu hybrid bonding)把金屬層黏在一起,這整份「晶片漢堡」又被夾在兩層矽之間,不直接接觸封裝基板。上面那片是主 Die,製程較先進;下面那片是副 Die,兩片邏輯電路透過金屬層與銅-鍵合通信。
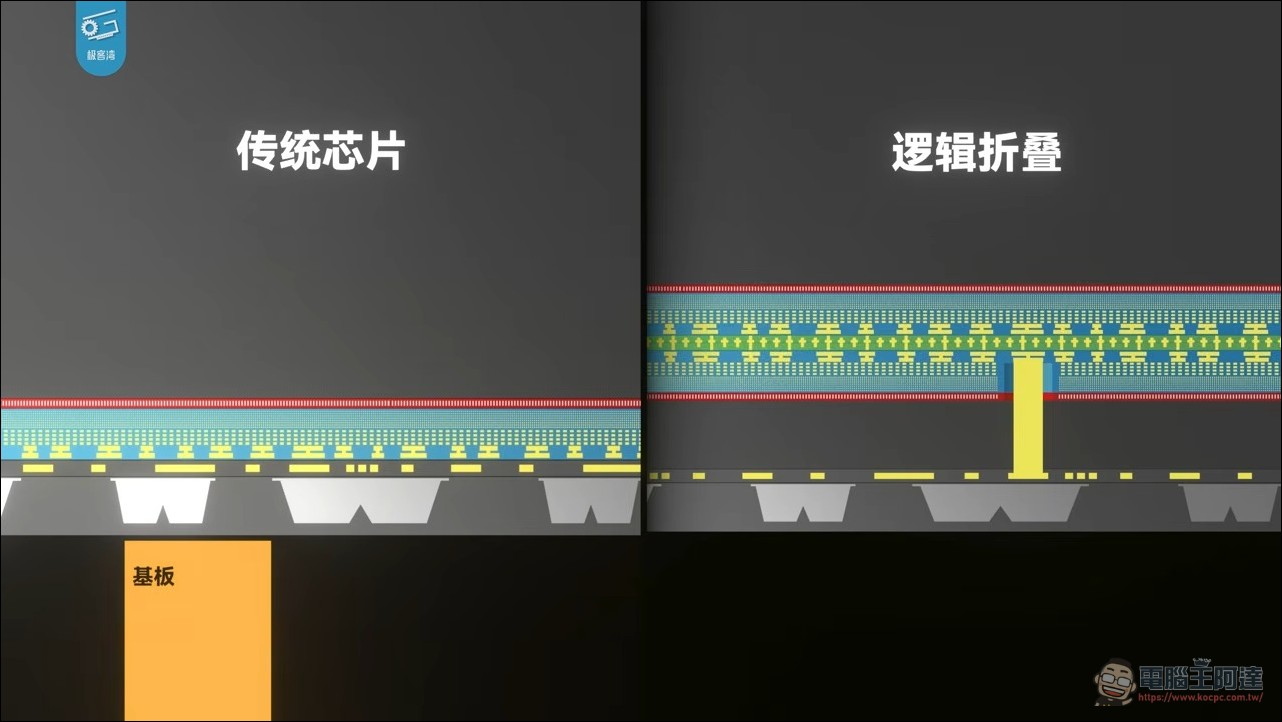
夾在矽中間帶來一個供電難題,解法是 TSV 矽穿孔:導電通路穿過底層矽與邏輯電路區,一路連到鍵合金屬層。極客灣統計海思在晶片與基板之間打了約 8 萬根 TSV,代價是下層 Die 約 8% 可用面積讓給了穿孔與禁布區。
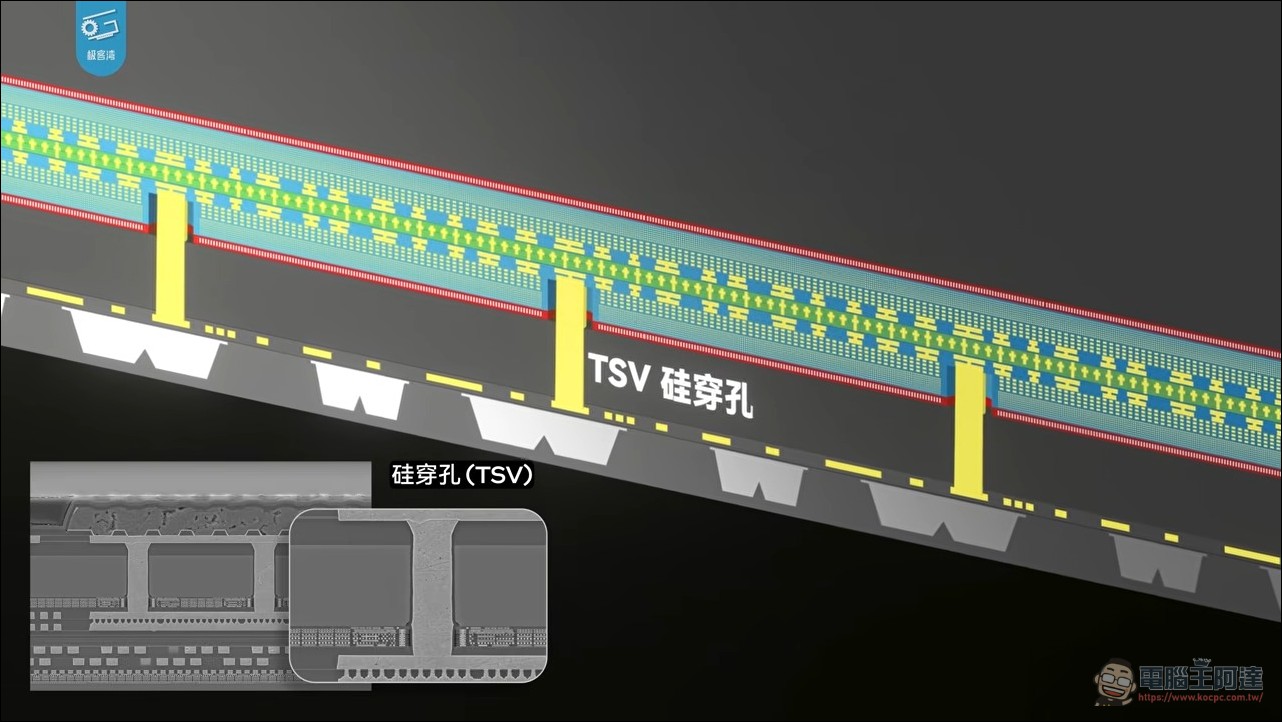
官方數據也對得上這個思路:9050 Pro 有 500 萬個訊號傳輸鍵合、跨 Die 傳輸頻寬 125TB/s,關鍵路徑時延縮短 30%、緩衝器數量減少 55%,電晶體密度來到每平方毫米 2.38 億個、較前代提升 28%。
邏輯折疊真的把每顆核心折起來放
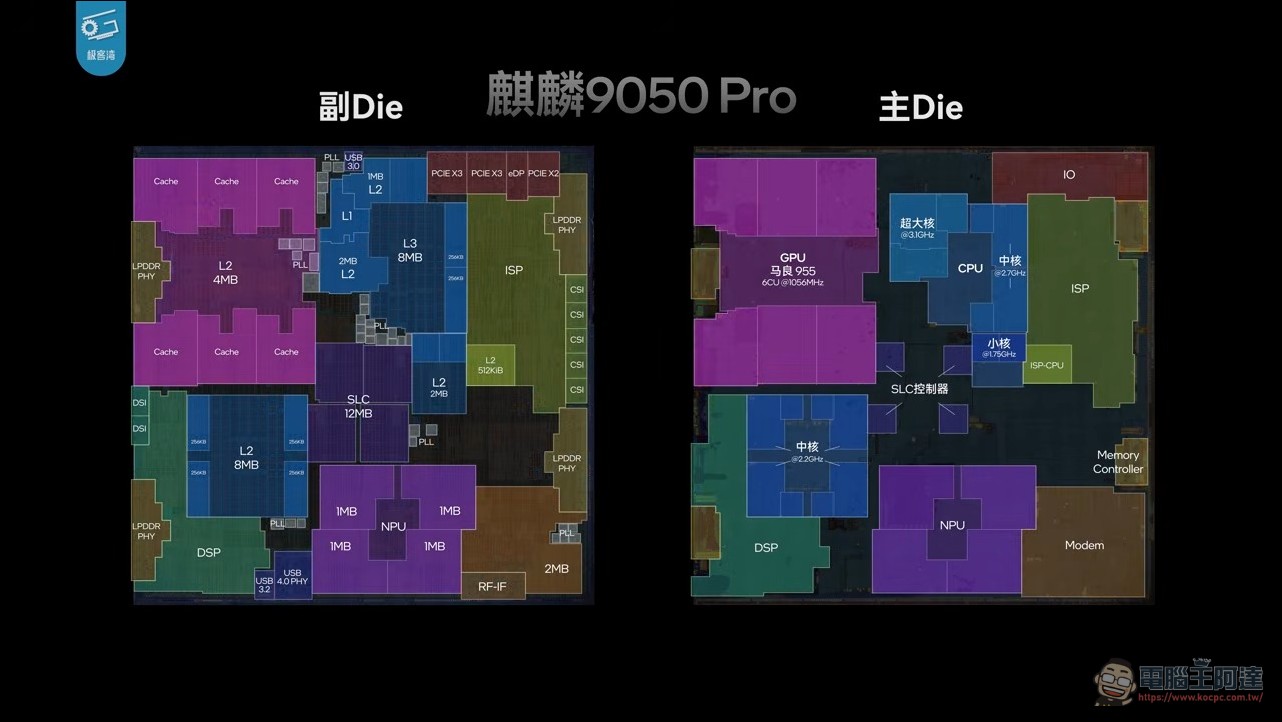
邏輯折疊不是「上面放 CPU、下面放 GPU」那麼粗暴。極客灣攤開兩片晶粒發現,每個 CPU 核心都被切成上下兩塊:超大核的執行單元(整數、浮點、Load & Store)留在主 Die,L1、L2 快取則放到副 Die,折疊後快取正好蓋在 Load & Store 的正下方,透過銅-鍵合直連,走線距離大幅縮短,延遲降低、同頻下電壓更低,功耗跟著下降。全晶片的 IP 都採同樣策略:快取、I/O、PLL 這類熱密度低、對製程不敏感的部分擺副 Die,高密度高發熱的運算單元擺主 Die。
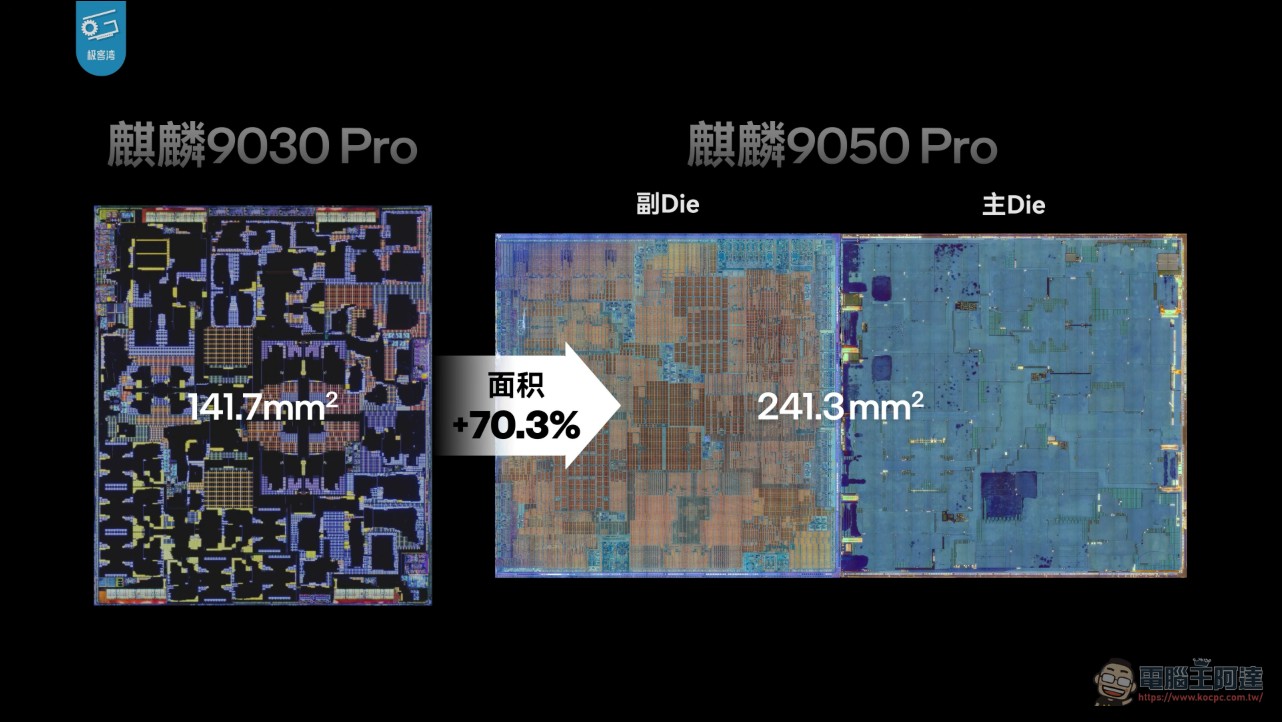
換來的集成度很可觀:上下兩片晶粒各約 120 多平方毫米,疊起來的佔位比前代 140 多平方毫米還小,但兩片加起來 240 多平方毫米的裸片面積足足多了 70%,等於在不換製程、不擴佔地的前提下多塞進 70% 的電路。這正是華為被逼出來的路徑:既然設備拿不到 EUV、製程卡在原地,就把封裝與堆疊當成新的戰場,用三維重構繞過平面縮微的極限。
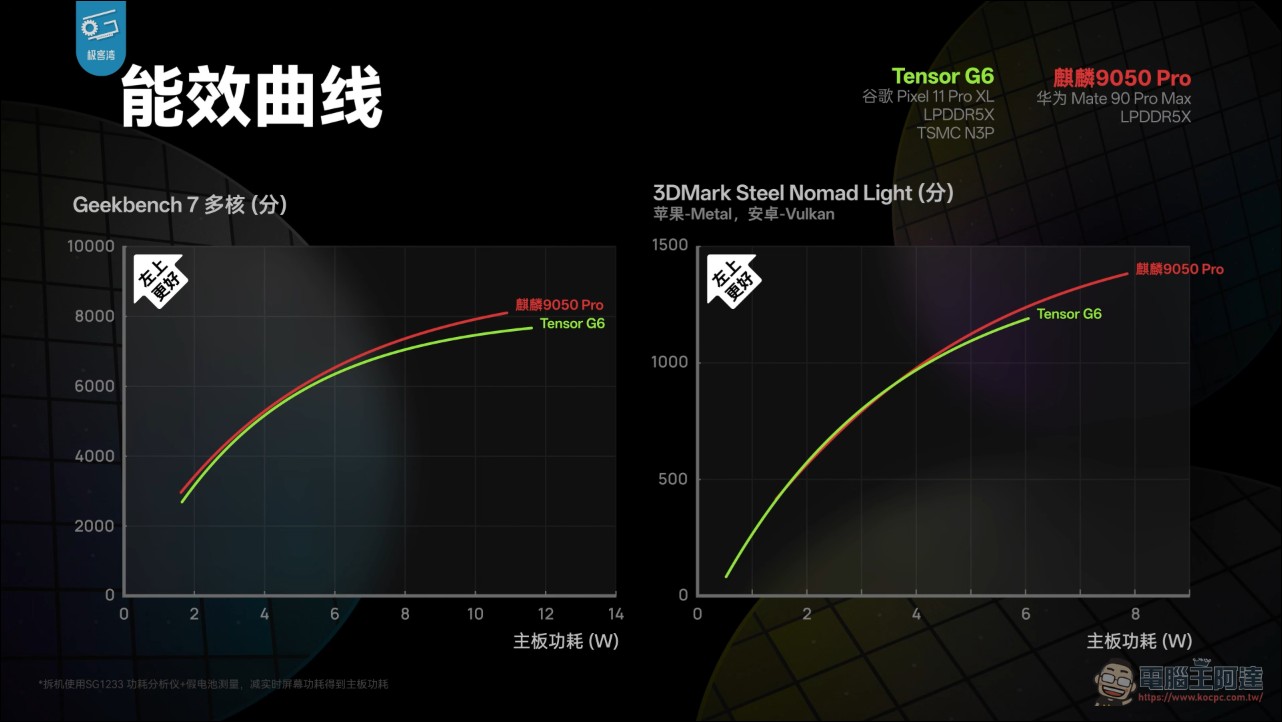
比較尷尬的是麒麟 9050 Pro 在能效曲線方面的表現甚至贏過採用台積電 N3P 3nm 製程的 Tensor G6 處理器(不過 Tensor 系列一直都不是以高性能作為主打,而是著重於 AI 的表現)。
麒麟 9050 Pro 遊戲與續航實測
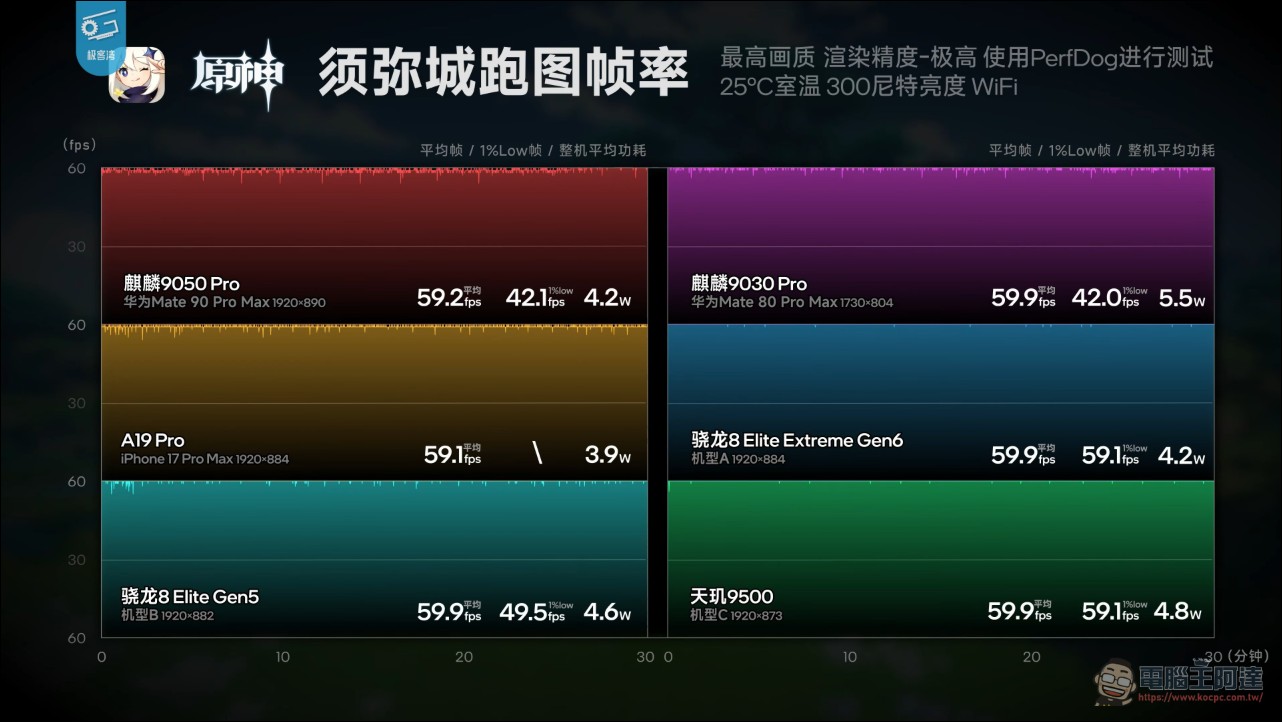
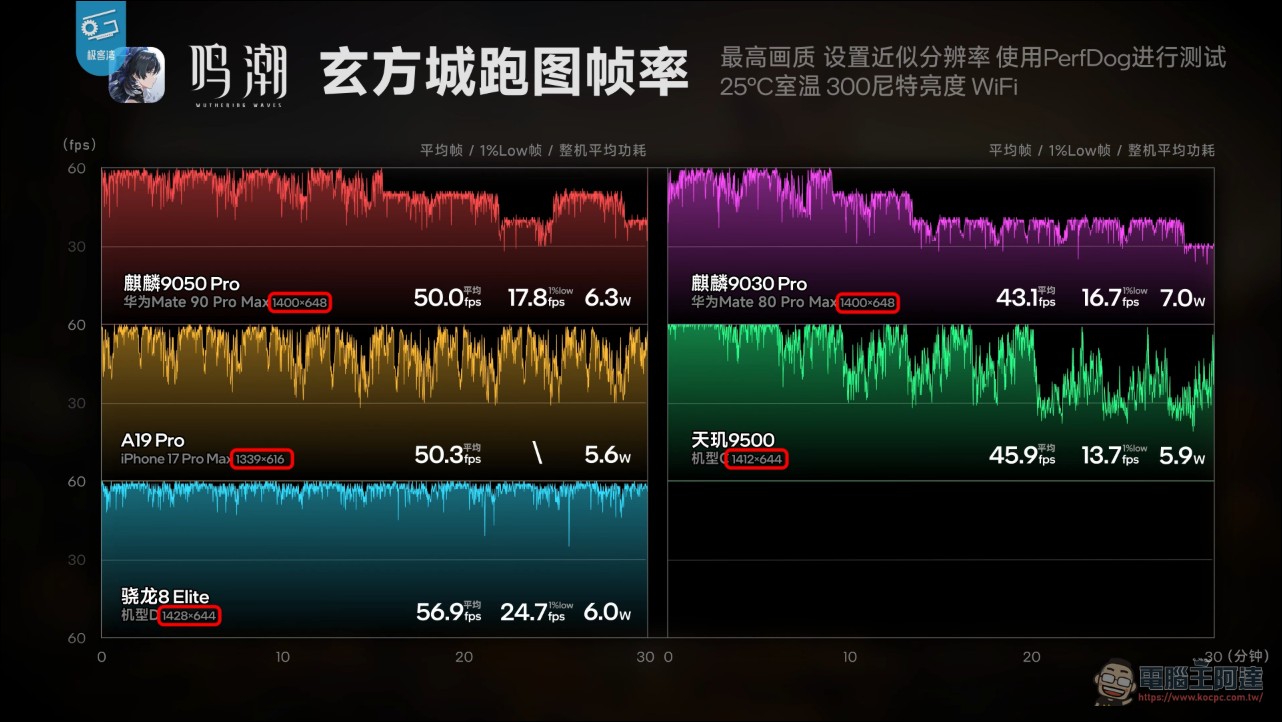
紙面之外,Mate 90 Pro Max 的實測同樣有看頭。原神 7.0 版在 890P 解析度、高性能模式下,整機 4.2W 就能跑滿 60 幀,比前代 Mate 80 Pro Max 用更低解析度的表現還省電,與高通最新旗艦和蘋果 A19 Pro 機型差距不大。壓力更大的鳴潮在 648P 下跑圖 30 分鐘平均 50 幀、6.3W,異環更拿到 53 幀、6.8W,比前代整整多 10 幀,能效幾乎追平安卓陣營的天璣 9500 與高通旗艦平台。極客灣也點出前提:這是鴻蒙原生遊戲才有的待遇,沒上鴻蒙的遊戲得靠轉譯層跑,流暢但能效不出色。
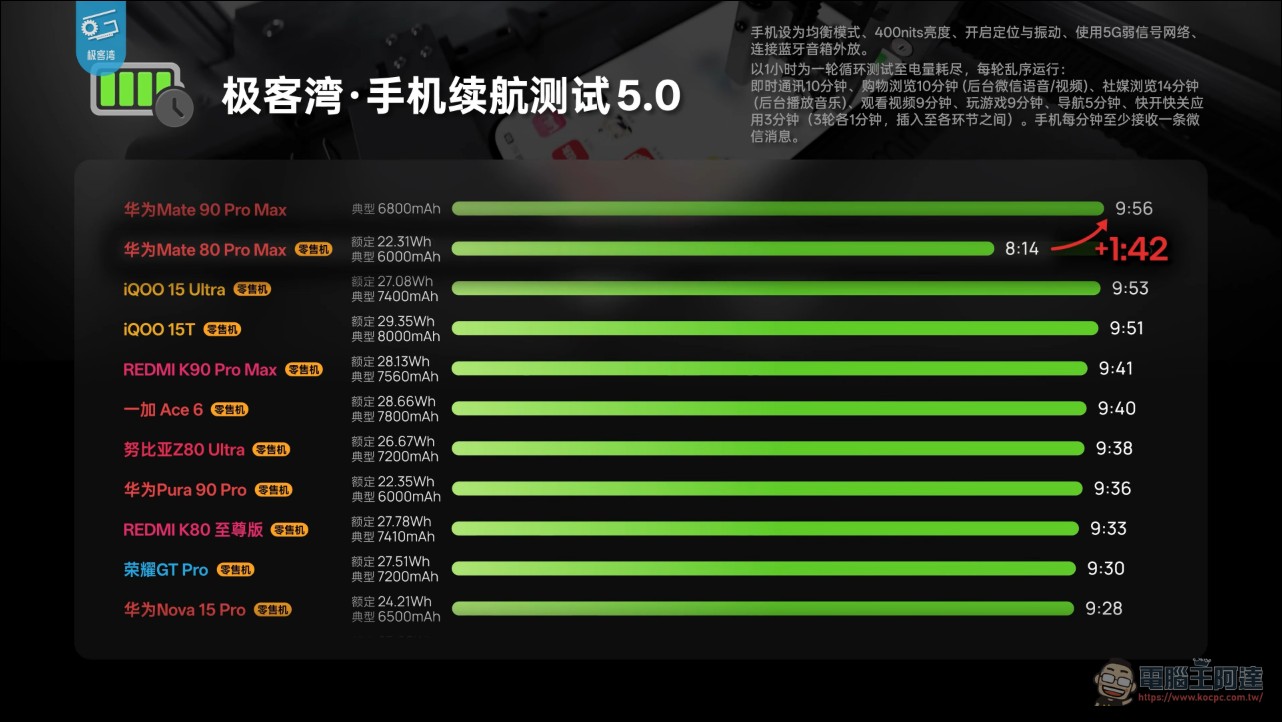
電池加到 6,800mAh,搭配晶片能效進步,在極客灣的 5G 續航模型裡撐了 9 小時 56 分,比前代多出一個半小時以上,和一票大電池安卓機相比毫不遜色。
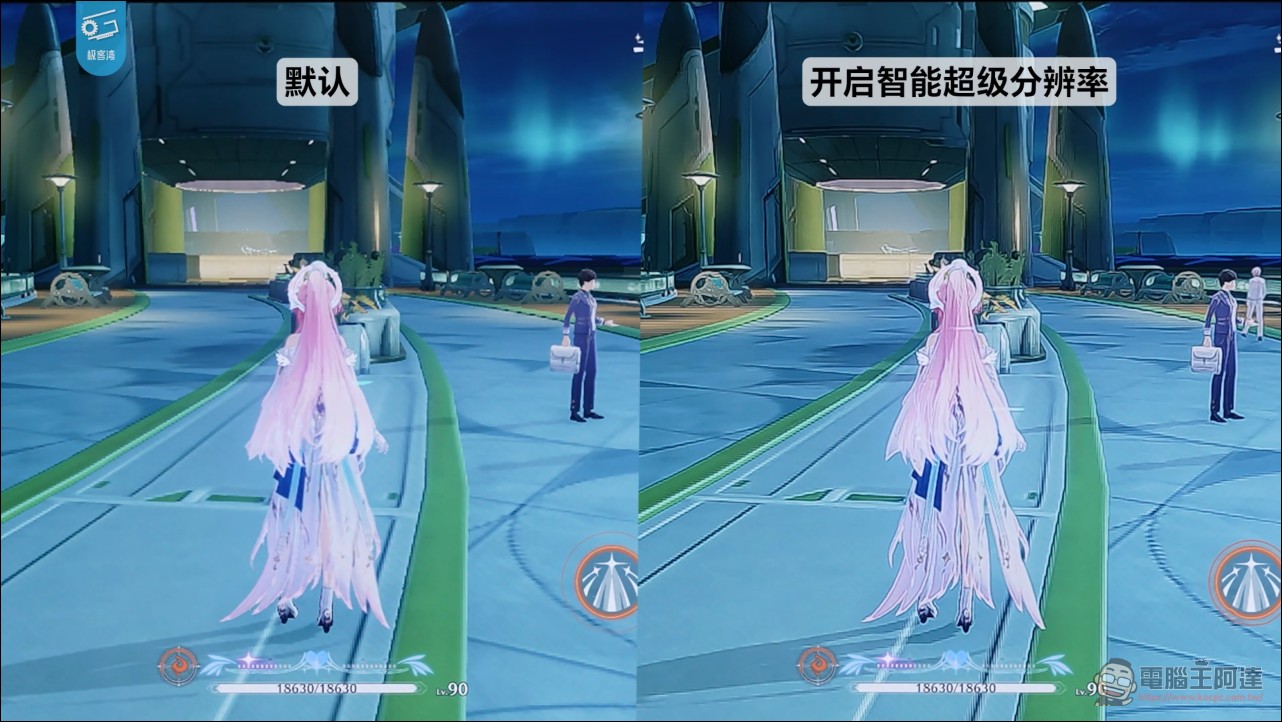
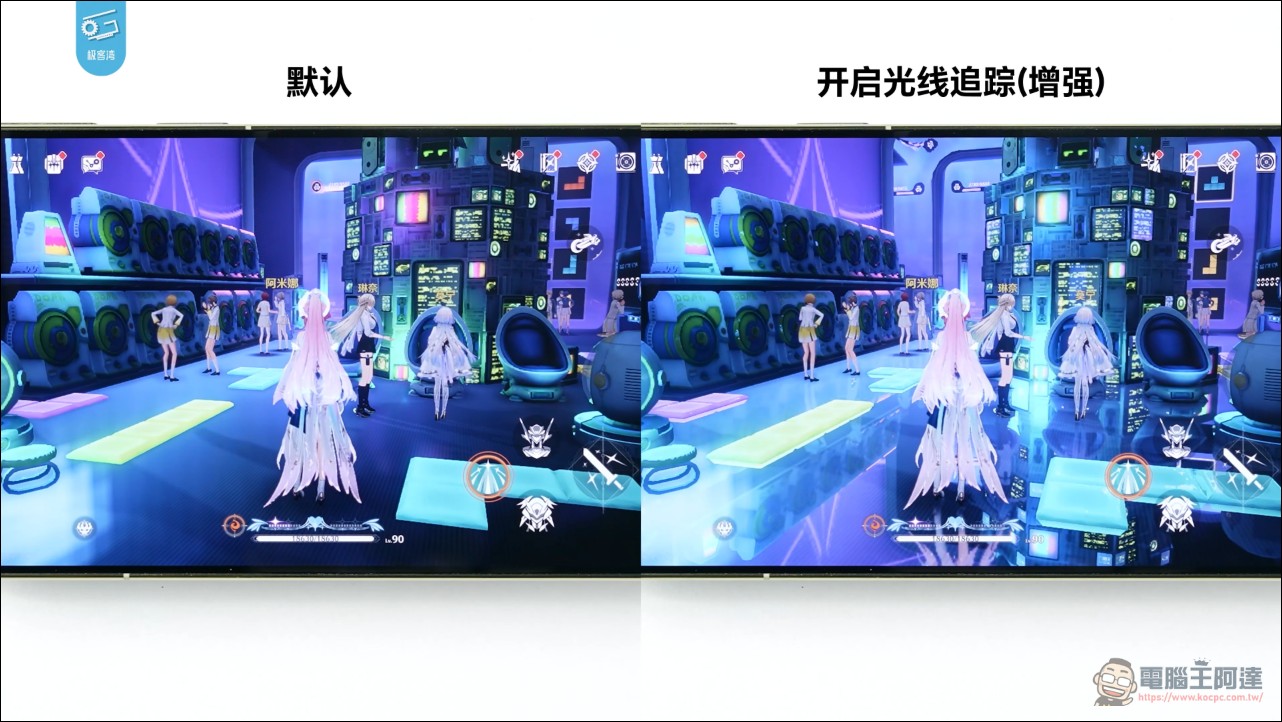
圖形技術這代也補了 AI 超分(NPU 與 GPU 協同)、更多遊戲的硬體光追支援(鴻蒙版鳴潮的光追反射肉眼可見)與遊戲內智能 HDR。
NPU:面積多 150% 更強的本地 AI 能力
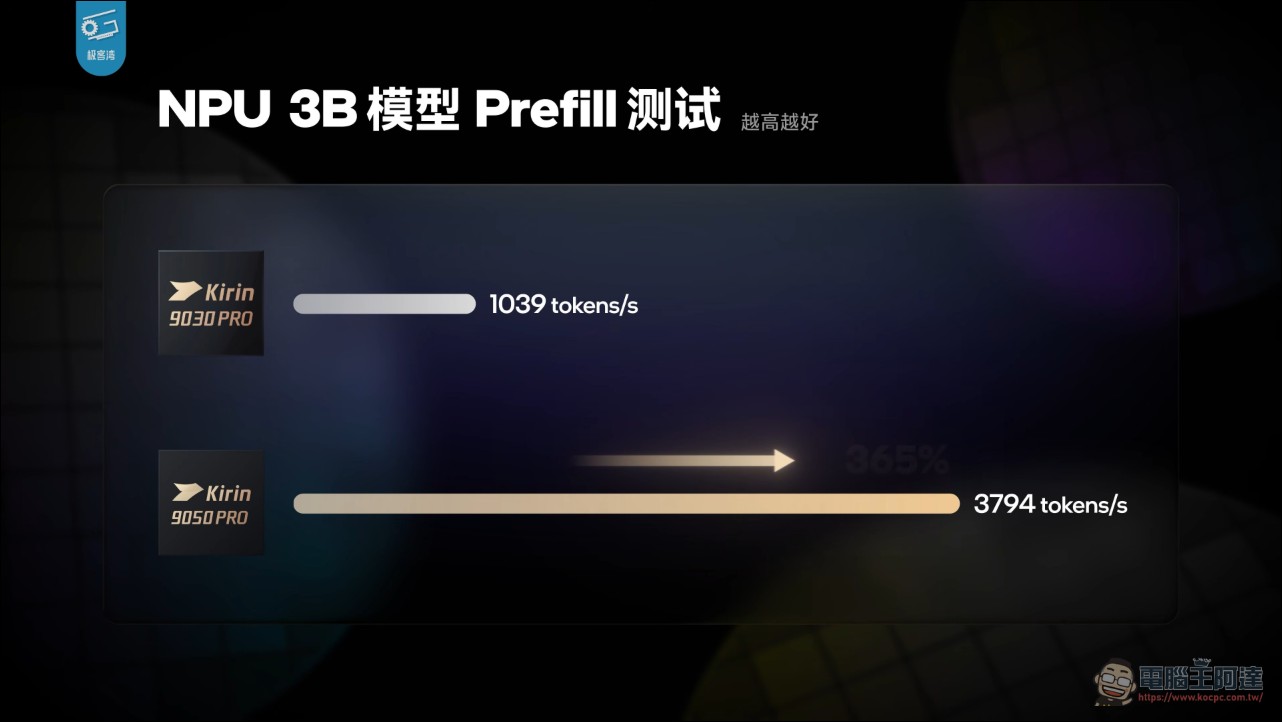
極客灣說這顆 NPU 大得誇張:光是主 Die 上的 NPU 面積就超過麒麟 9030 Pro 整顆 NPU,上下兩片加總面積比前代多 150%,INT8 吞吐 68 TOPS,跑 3B 模型的 Prefill 速度是前代的三倍。官方規格也呼應這點:達芬奇架構 NPU 性能提升 140%,並支援端側 30B MoE 大模型。
實際應用上,離線狀態就能叫小藝整理相簿(跑 30B-a2B 的 MoE 模型),修圖時先由 MoE 模型分析畫面給出去路人、加虛化的建議,再交給本地 6B 多模態模型動手修,成果不輸雲端模型。如果想瞭解麒麟 9050 Pro的更多能力也可以直接看極客灣的影片,個人是對這次華為的這顆處理器表現也很驚艷。
結語:折出來的第三條路
極客灣對邏輯折疊的評價很高,但也踩了煞車:這種技術現階段成本高昂、良率還在爬坡,短期內只會用在旗艦產品,華為自己也把韜定律與邏輯折疊定義成包含關係,並非每顆晶片都會折。價格反映了一切:Mate 90 Pro Max 的 16GB+512GB 版本賣 9,999 元人民幣、約新台幣 4.4 萬元,比前代同配置貴 2,000 元人民幣,余承東坦言記憶體漲價讓每台手機成本平均增加 200 美元。對半導體產業而言,邏輯折疊提供了一個耐人尋味的示範:當製程縮微的大門逐漸收窄,封裝、堆疊與架構設計這些「後段功夫」,同樣能把晶片往前推一代。這條路能不能走遠,最終考驗的是良率與成本曲線。