
電腦本地端 AI 模型近年可說變得越來越強大,很多基礎工作、程式用本地 AI 就能做到,也因此很多人一定也會希望能在手機上運行。雖然過去手機就已經能跑一些本地 AI,但受限於記憶體、效能與模型大小,能夠流暢運行的模型通常規模有限,實際使用體驗跟電腦上的大型模型還是有一段差距。好消息是,隨著 iPhone 18 Pro 系列推出,這樣的情況似乎開始有一些變化了。
最近有國外開發者實測在 iPhone 18 Pro 上運行本地 27B、也就是 270 億參數的 AI 模型 Bonsai 27B,結果顯示,相較去年的 iPhone 17 Pro,生成速度直接提升到約兩倍。更重要的是,整個模型完全在手機本地運行,不需要連接雲端。隔一代就有這麼明顯的提升,也讓人越來越期待未來手機本地端 AI 的發展。
iPhone 18 Pro 本地端 AI 實力曝光!A20 Pro 跑 27B 參數模型速度是 iPhone 17 Pro 的兩倍
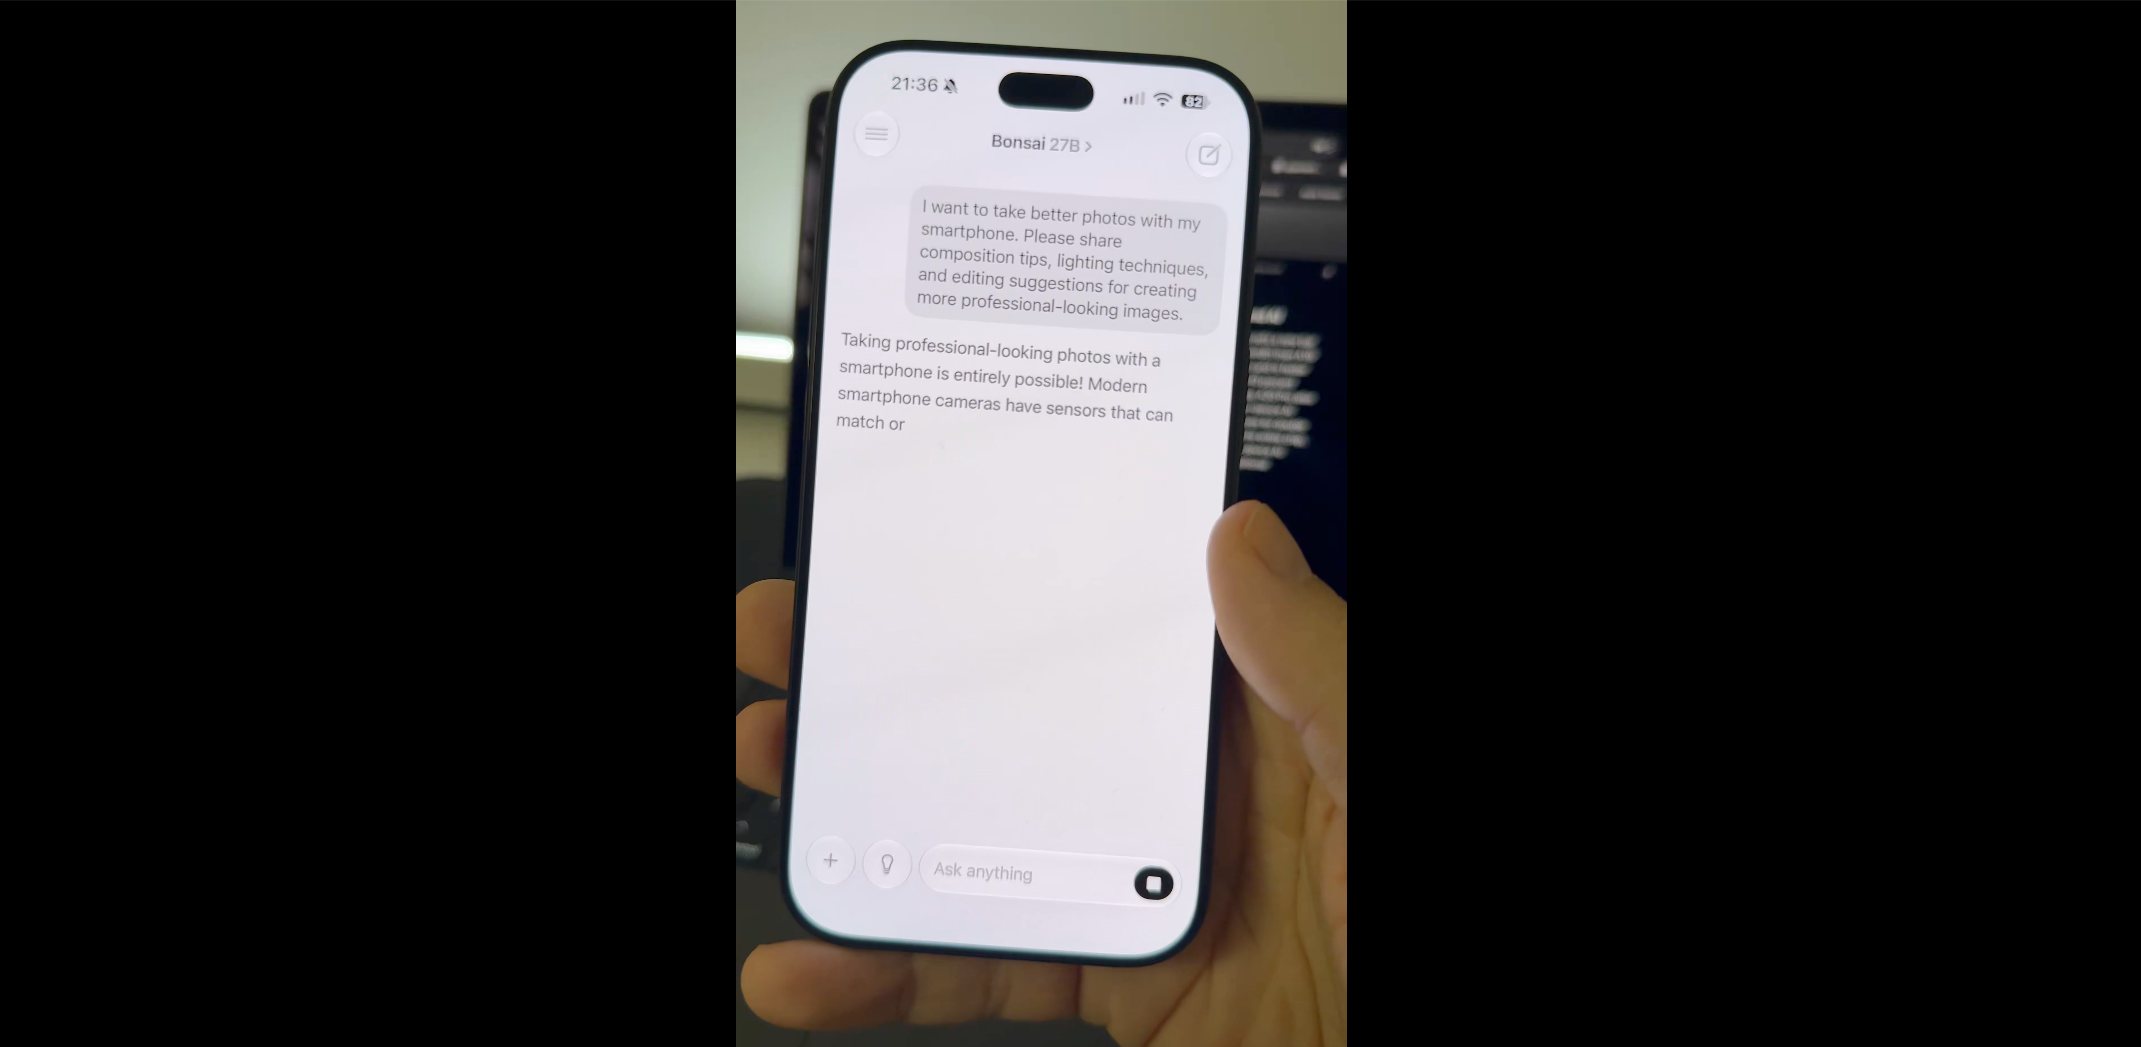
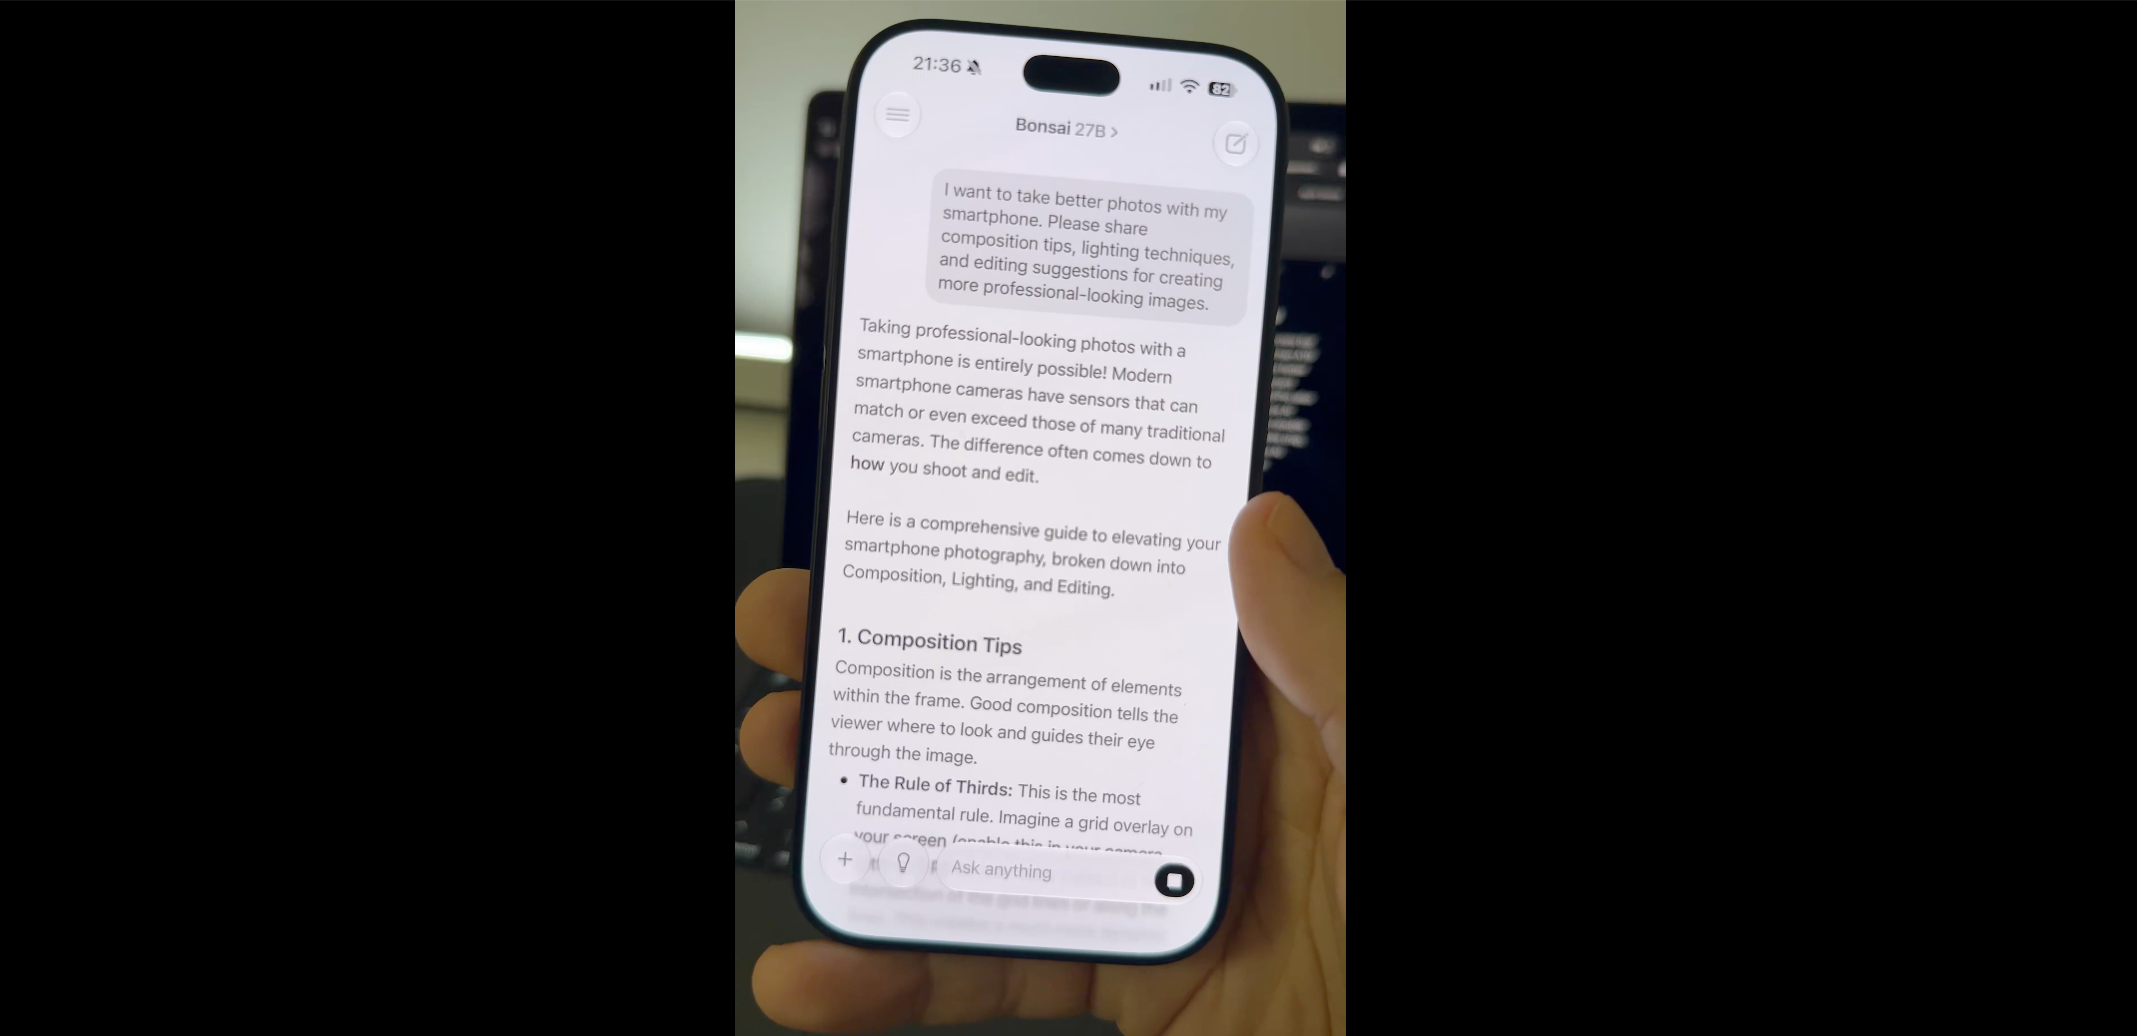
近日一位國外開發者 Adrien Grondin 在 X 上發布的實測影片:他使用 iPhone 18 Pro 跑 Prism ML 的 Bonsai 27B 模型,Token 生成速度大約是 iPhone 17 Pro 的兩倍。他在貼文裡寫道:「iPhone 18 Pro 的端側 AI 表現比我預期好很多,它跑 27B 模型的速度是 17 Pro 的兩倍。新的 A20 Pro 晶片是個怪物。」
Adrien Grondin 也不是隨便的路人,他是 iOS 本地 AI 聊天 App「Locally AI」的作者,這款 App 今年 4 月被 LM Studio 收購,他現在負責 LM Studio 在 Apple 裝置上的原生體驗。過去他就常拿 iPhone 跑各種開源模型做示範,像是在 iPhone 17 Pro 上把 Gemma 4 跑到每秒 40 個 Token,所以這次的實測有一定的參考價值。
Bonsai 27B 是新創公司 Prism ML 今年 7 月釋出的開源模型,以阿里巴巴的 Qwen3.6-27B 為基底,最大的特點是採用「1-bit 量化」,原本約 54GB 的模型檔,被壓到只剩約 3.9GB,理論上有 4GB 記憶體的裝置就能跑起來。這也是為什麼能在 iPhone 17 Pro 和 iPhone 18 Pro 運行的原因。
Prism ML 之前也公布過 iPhone 17 Pro Max 的測試數據,約每秒 11 個 Token,並宣稱這是第一個能在手機上跑的 27B 等級模型。
順帶一提,Grondin 這次的貼文只說「兩倍」,沒有給確切的 tok/s 數字。如果用 Prism ML 公布的 17 Pro Max 每秒 11 個 Token 去推算,iPhone 18 Pro 大概落在每秒 20 出頭。
這數字就有實際意義了!因為聊天要讀起來像「即時對話」,根據國外報告門檻大約要在每秒 15 到 20 個 Token,iPhone 17 Pro Max 的 11 tok/s 會讓人覺得一直在等待,而 iPhone 18 Pro 如果真的跨過 20,那 27B 模型在手機上就從「能跑」變成「能用」了。從 Grondin 釋出的影片也能清楚看到,速度確實很快。
Prism ML 除了 1-bit 版之外,還有一個能保留原版 95% 的能力 2-bit「Ternary Bonsai 27B」,體積約 7.2GB,但這個版本對 iPhone 18 Pro 來說太大,硬跑效能會掉下來,Prism ML 也定位在筆電和 GPU 使用。Grondin 也留言說新版 Bonsai 2(2 位元版本)太大,無法在 iPhone 上運行。