AI 新創 PrismML 於 9 月 17 日發表 Bonsai 2 27B,這是其三元量化模型家族的最新版本。這款模型基於阿里巴巴的開源模型 Qwen3.8 27B,透過將模型權重壓縮到僅需 +1、-1、0 三種數值(即「三元權重」),將原本需要約 54 GB 記憶體的模型縮小到 5.9 GB,體積減少約 9 倍,同時在綜合基準測試中保留 98.2% 的原始效能。這代表一顆 27B 等級的推理模型,現在能在個人電腦甚至高階智慧型手機上執行。對於一直在等待「裝置端 AI」走向成熟的開發者與使用者而言,這是一個關鍵的技術突破。
從加州理工實驗室走出來的壓縮技術
PrismML 由加州理工學院(Caltech)的研究團隊創立,執行長 Babak Hassibi 是該校教授,專精壓縮技術領域。公司的顧問陣容同樣亮眼,Ion Stoica 是 Databricks 的共同創辦人,同時也是加州大學柏克萊分校 Sky Computing Lab 的主任,該實驗室孕育了 Letta、SGLang 等多個知名技術專案與新創公司。投資方包括 Khosla Ventures、Cerberus Capital 以及加州理工學院本身。
三元權重的運作原理
一般大型語言模型的每個權重需要 16 位元來儲存。PrismML 的做法是將每個權重簡化為三個可能的數值:+1、-1 或 0。這種「三元」表示法每個權重只需 log₂(3) ≈ 1.585 位元,加上每 128 個權重共用一個 FP16 縮放因子(額外增加 16/128 位元),實際每個權重約 1.71 位元。相比標準的 16 位元,這是約 9.4 倍的壓縮率。
這種壓縮方式貫穿了模型中所有矩陣運算密集的元件,嵌入層、注意力投影、MLP 投影以及語言模型輸出頭。只有少量的正規化與縮放參數維持較高精度。PrismML 強調,Bonsai 系列屬於對既有開源模型的低位元重新表示,並非從頭預訓練。
Bonsai 2 27B 基準測試成績:壓縮的代價有多大?
根據 PrismML 公布的數據,Bonsai 2 27B 在 15 項基準測試(思考模式)中的表現如下:
- 數學:93.40(原始 Qwen 為 95.33)
- 程式碼:85.96(原始 88.74)
- 知識與推理:76.96(原始 83.15)
- 代理與工具呼叫:74.01(原始 80.00)
- 指令遵循:71.77(原始 78.47)
- 視覺:65.19(原始 72.61)
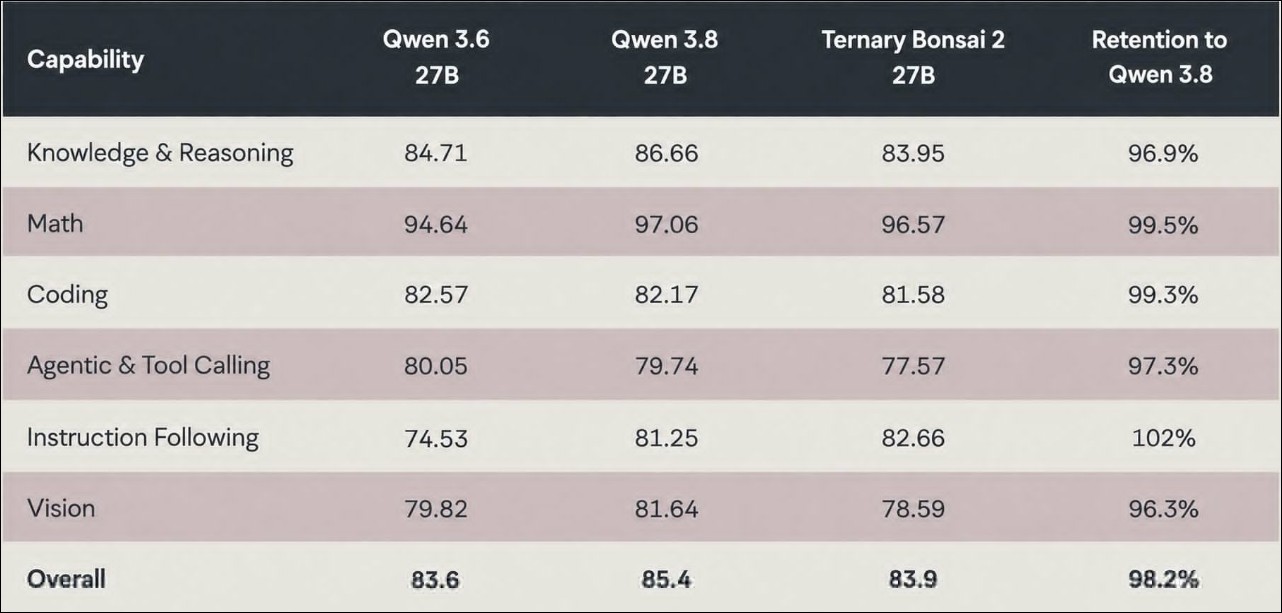
整體來看,三元版本保留了原始模型約 94.6% 的效能。相較之下,PrismML 同時提供的一位元(binary)版本體積進一步縮小到 3.9 GB,但效能保留率降至 89.5%。
傳統的低位元量化方式(如 Q4_K_XL、IQ2_XXS)在某些基準測試上會出現選擇性崩潰。以 IQ2_XXS(2-bit)為例,它在 AIME26 數學測試上跌至 57.5 分、LiveCodeBench 跌至 56.4 分,但在 MMLU-Redux 上仍有 88.93 分,短期問答類的基準測試掩蓋了它在複雜推理任務上的嚴重退化。PrismML 的三元壓縮方式在這方面的衰減則相對平緩。
記憶體才是核心瓶頸
要在手機上執行模型,儲存空間只是其中一個考量。iOS 系統對單一應用程式的記憶體使用量有硬性限制,大約是實體記憶體的一半。一臺 12 GB 記憶體的 iPhone,實際上只能給單一 App 使用約 6 GB。
KV 快取是另一個關鍵預算,Bonsai 27B 架構中只有 16/64 層使用完整的注意力快取,FP16 下每 token 約需 64 KiB。在 262K token 的上下文視窗下,KV 快取需要約 17.2 GB;使用 4-bit KV 快取可壓縮到約 4.3 GB。
在不同硬體平台上的吞吐量測試結果:
- M5 Max(Binary):生成 66.4 tok/s,預填充 874 tok/s
- M5 Pro(Ternary):生成 26.2 tok/s,預填充 393 tok/s
- iPhone 17 Pro Max(Binary):生成 11.0 tok/s,預填充 111 tok/s
- H100 GPU(Binary):生成 104.8 tok/s,預填充 2,755 tok/s
官網同時標榜 Bonsai 2 相較原始模型有 8 倍吞吐量提升與 5 倍能耗降低。
This is where higher retention matters most: fewer derailments across multi-step tasks, fewer silent failures as the state evolves, and better consistency from one decision to the next.
Here is Ternary Bonsai 2 27B running an agentic coding workflow with Cline on an NVIDIA… pic.twitter.com/lqaE2bktQ1
— PrismML (@PrismML) September 17, 2026
不只壓縮大小,代理能力是重點突破
Bonsai 2 相較第一代最大的變化是整體效能保留率從 95% 提升到 98.2%,但在特定領域的進步更為關鍵。PrismML 特別強調,新模型在代理式程式碼撰寫(agentic coding)、多模態推理以及長時間跨度的工具使用(long-horizon tool use)三個面向有明顯改善。
這三個能力恰好是當前 AI Agent 生態系最需要的:撰寫與修改程式碼、理解圖片與文字的混合輸入、在多步驟任務中維持上下文。過去量化模型最大的弱點往往是這類複雜推理任務,壓縮後的模型在簡單問答上表現不錯,但一旦涉及多步驟邏輯就會嚴重退化。Bonsai 2 在這方面的改善,讓它具備了作為裝置端 Agent 大腦的實力。
Computer use is another strong test.
The model has to repeatedly interpret state, choose the next action, and stay coherent across a long sequence of steps, exactly where small capability gaps become visible.
Here is Bonsai 2 27B running a computer-use workflow locally on the… pic.twitter.com/SlFwk6WZo7
— PrismML (@PrismML) September 17, 2026
在工具呼叫的基準測試中,Bonsai 2 的三元版本達到 74.01 分(滿分 100),雖然與原始模型的 80.00 分有差距,但已遠高於傳統 2-bit 量化方式在同類測試中的表現。一位 GitHub 使用者 MiaAI-Lab 的獨立評估也驗證了這一點:三元版本在簡單與中等難度的工具使用任務上分別達到 95.2% 與 88.4% 的原始水準。不過 X 上也有使用者反應 PrismML 誇大了 Bonsai 2 的能力,他實際使用表現並不如官方所宣稱優異。
98.2% of Qwen3.8 27B my ass.
I got hyped and gave it a real agent job right away. Build me an FPS in three.js, 6 hours on a 3090. My most standard and default prompt that I always use. It spent the first 32K tokens on a plan without writing a single file, then shipped a black… https://t.co/4ki588L4sg pic.twitter.com/g1PVgfXiww
— Alexey Fateev (@superalesha) September 18, 2026
誰在用?實際應用場景
PrismML 為 Bonsai 2 規劃了四個主要應用場景:
- 筆電端代理:三元版本可在筆電上完整處理 262K token 上下文的程式碼倉庫分析,適合需要在本地環境工作的開發者
- 手機端推理:一位元版本可塞進 iPhone 等裝置,白皮書測量在 iPhone 上每消耗 1% 電池電量可產生 672 個 token
- 隱私敏感與離線工作流:所有資料留在裝置上,完全不經過雲端
- 單 GPU 服務:搭配 4-bit KV 快取,27B 等級的品質可在 24 GB 顯示記憶體的顯示卡上提供服務
下載量已破千萬,下一步是百億參數等級
PrismML 的第一代 Bonsai 模型(今年 3 月發布)已累計超過 1,100 萬次下載,加上其他更小型號的 260 萬次,整個家族的總下載量已突破 1,360 萬次。第一代 Bonsai 的基準測試保留率為 95%,Bonsai 2 將這個數字提升到 98.2%,顯示壓縮技術仍在持續進步。
PrismML 計劃在未來幾個月內發布數百億參數等級的壓縮模型。「模型越大,壓縮時保留智慧的空間就越大。對於更大的模型,更容易逼近 100% 的效能保留。」PrismML 的技術路線是建立一套從小到大的完整壓縮模型產品線,而非僅僅做出一兩個能跑的手機模型。
Bonsai 2 27B 已在 Hugging Face 上架,採用 Apache 2.0 授權,支援 llama.cpp(CUDA、Metal)和蘋果的 MLX 推理框架。