有使用開源模型需求,但又不想或不能用中國開源模型的人有福了!AI 新創 Thinking Machines Lab 在 11 月 20 日推出開放權重模型 Inkling 2 Mini,把「讓前沿級模型跑在你的筆電上」當作主打賣點。這個模型只有 26.4B 總參數、每個 token 啟動 3.4B,卻在多項代理式編程與工具使用基準上贏過參數數倍於它的對手,靠的是一項不太新的架構想法:把中間層迴圈跑三次。 發布不到 48 小時,它已經登上 LM Studio 的 1.7 萬下載榜中。
來自前 OpenAI 技術長的「反堆參數」路線
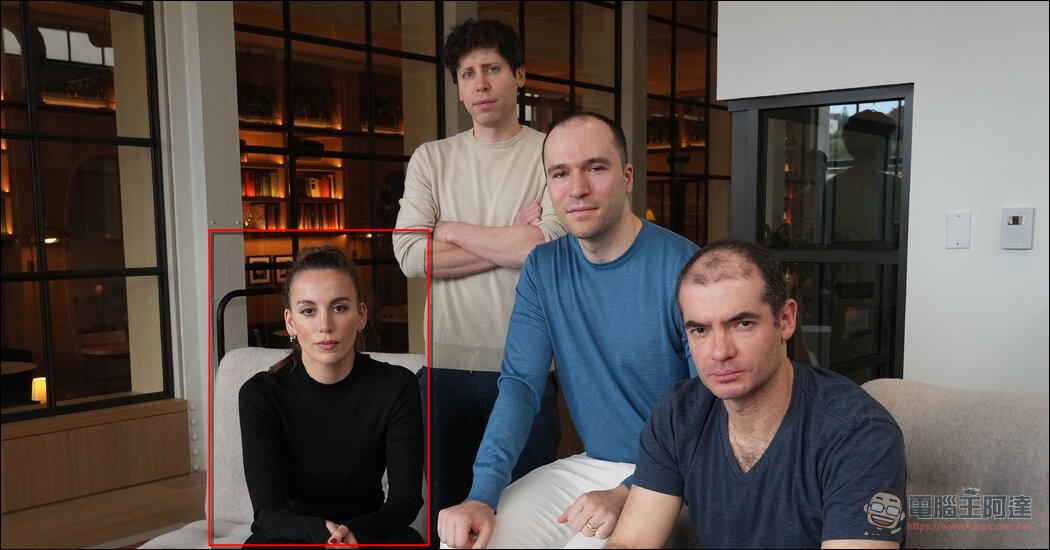
Thinking Machines Lab 由前 OpenAI 技術長 Mira Murati(米拉·穆拉蒂,當年把 Altman 逼宮走的成員之一)在 2025 年 2 月共同創辦,連合創辦人包括 OpenAI 資深研究人員 John Schulman、Barrett Zoph、Lilian Weng 等人,團隊約 30 人。公司在成立後五個月內募得 20 億美元種子輪,估值 120 億美元(約新台幣 630 億元),是矽谷史上最大種子輪之一;今年 9 月又有報導稱 Accel 正洽談領投 10 億美元新一輪,估值上看 400 億美元(約新台幣 1.26 兆元)。
產品線上,這家實驗室先在 2025 年推出模型微調平台 Tinker,2026 年 7 月 15 日發布首個從零訓練的開放權重模型 Inkling,是一個 975B 參數的 MoE 模型,採 Apache 2.0 授權;兩週後又推出 276B 參數的 Inkling-Small,以四分之一的體積維持接近的性能。 Inkling 2 Mini 延續同一條「預測縮放階梯」(predictive scaling ladder)訓練配方,主要改動有兩處:訓練中剪掉三分之二的專家,以及引入層間迴圈。
Inkling 2 Mini 迴圈架構:24 層跑成 48 層
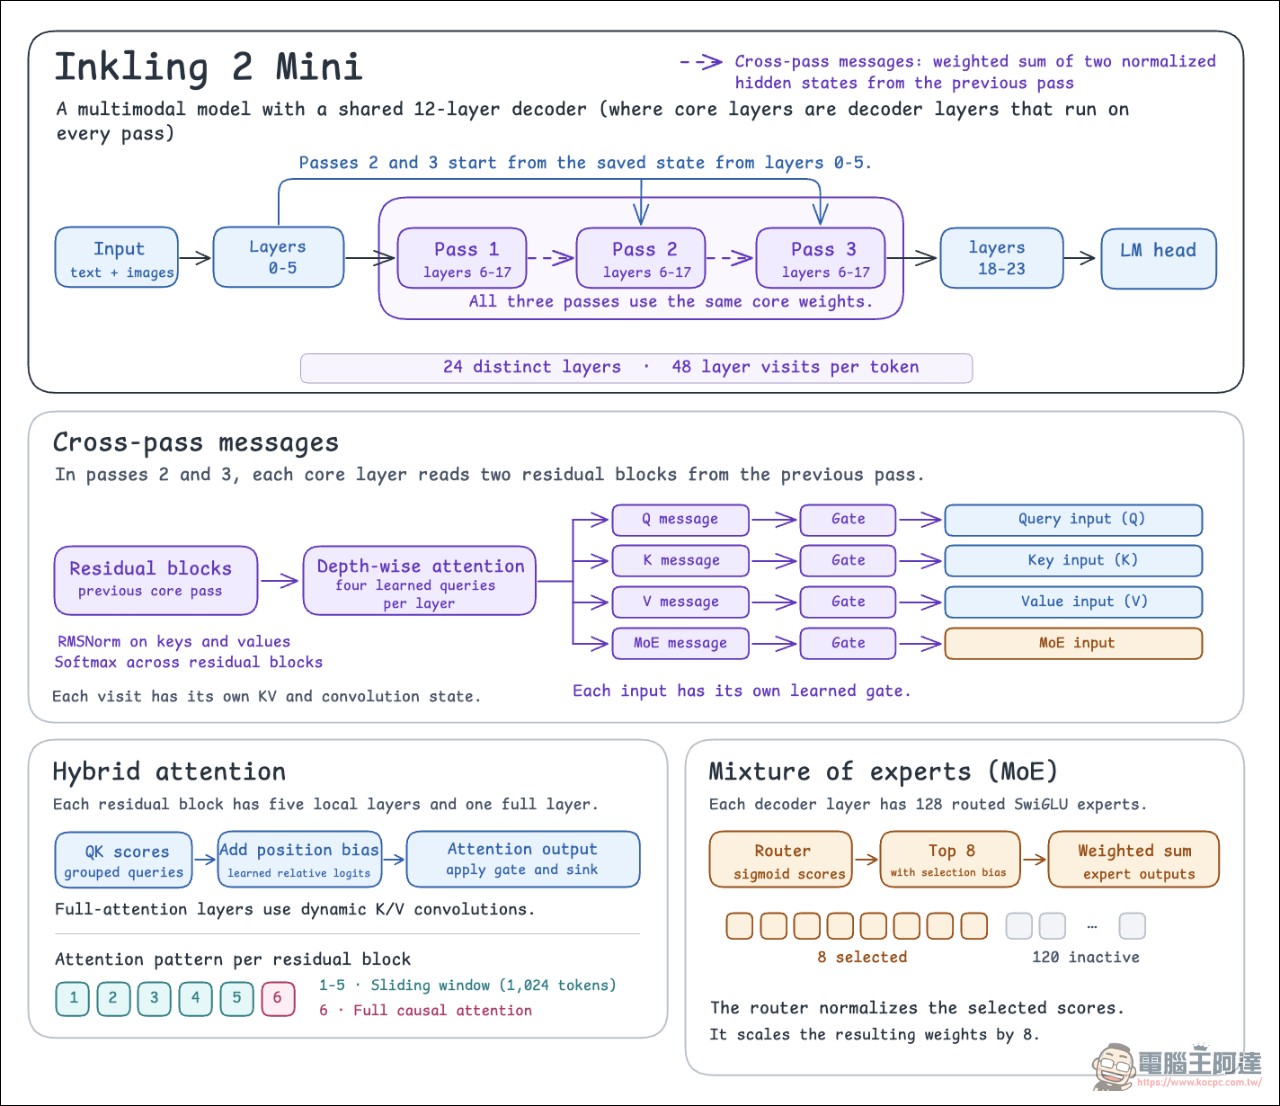
Inkling 2 Mini 是一個 24 層的 MoE 模型,分為四個六層區塊。頭尾兩個區塊各跑一次,中間兩個區塊以共享權重跑三次,等於每個 token 經過 48 次層運算,實際啟動參數從 3.4B 變成等效 5.4B,儲存體積不變。 模型把「想清楚再寫下來」這道程序搬進權重內部,不必像一般推理模型那樣把思考全部輸出成文字。
為了讓資訊在三次迴圈間流動,Thinking Machines 導入 attention residuals:每次迴圈都從第一區塊的輸出出發,再讀取上一輪中間層留下的「訊息」(message),由一個學習到的閘門決定要忘記多少當前輸入、加入多少上一輪的訊息。[1] 該公司實測,迴圈化中間 12 層在 28 項評估中的 27 項領跑迴圈化後段 12 層;一個不迴圈的基線模型訓練成本便宜 7.5%,但推理時要多花 140% 的算力才能追平迴圈版在 512K token 代理軌跡上的損失。
另一個關鍵是數值格式。Inkling 2 Mini 的 24 層裡有 20 層從預訓練到 RL 全程以 4-bit NVFP4 原生訓練,最後 4 層用 8-bit MXFP8,發布時直接以訓練精度出貨,跳過一般模型「訓練後再量化」的轉換損耗。 整個權重佔約 20GB,32GB 記憶體的 Mac 或單張桌面 GPU 就能離線運行。 Thinking Machines 的研究人員示範過在飛行模式的 48GB M5 Pro MacBook Pro 上,幾分鐘內讓模型做出一個可玩的飛行模擬器。
跑分:追平 Qwen3.8-27B,代理編程領跑同級
獨立機構 Artificial Analysis 的智慧指數 v5 上,Inkling 2 Mini 拿到 20.1 分,與阿里巴巴的 270 億參數稠密模型 Qwen3.8-27B 並列,而它每個 token 只動用 5.4B 等效參數。 官方 48 項基準對比 Gemma 4 31B、Muse Glimmer、Qwen3.8-27B 與 Nemotron 3.5 Super VL 四個對手,Inkling 2 Mini 在其中 32 項領先。
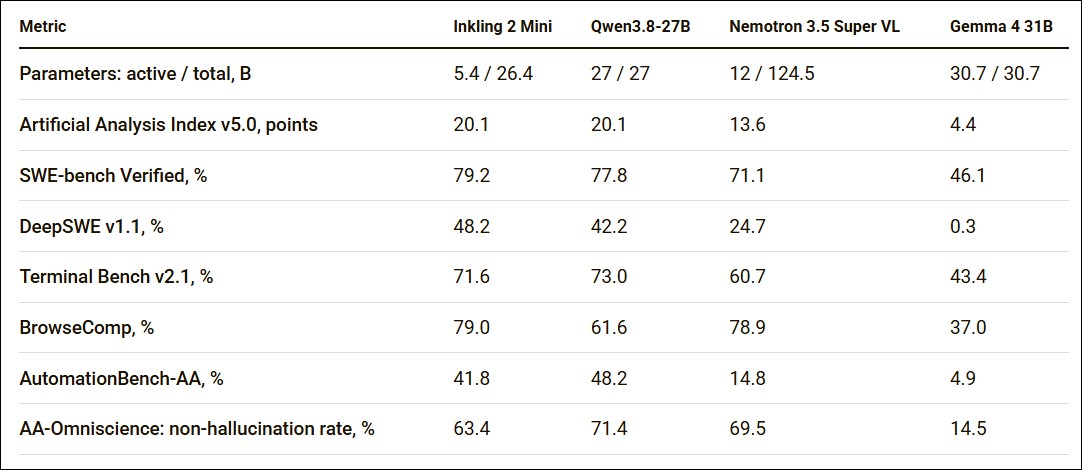
代理式編程是它最亮的一區:DeepSWE v1.1 拿下 48.2%(Qwen3.8-27B 42.2%)、SWE-bench Pro v2 Hard 77.9%、SWE-bench Verified 79.2%,都是 100B 以下開放模型的最好成績。 搜尋與長文件同樣突出:BrowseComp 79.0% 對 Qwen 的 61.6%,LongBench v2 66.9% 對 52.3%,文件理解 OmniDocBench v1.6 92.8%。
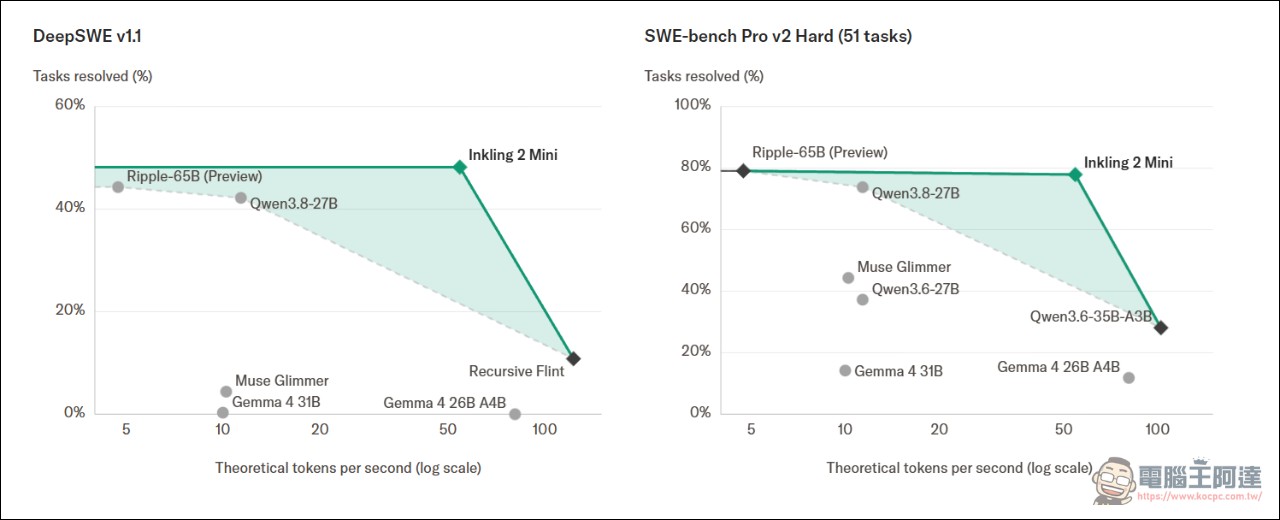
效率方面,Stanford 的 Hazy Research Lab 與 Scaling Intelligence Lab 拿到早期測試權,在 NVIDIA DGX Spark 上量「每焦耳智慧」,Inkling 2 Mini 得 0.703,大幅領先 Qwen3.6-35B-A3B 的 0.430、Gemma-4-26B-A4B 的 0.159。 成本端,OpenRouter 上目前唯一供應商 Prime Intellect 報價每百萬 token 輸入 $0.10、輸出 $0.40(約新台幣 3.2 元與 12.6 元),Neurohive 估算一組 2M 輸入加 100K 輸出的代理工作階段約 $0.10(約新台幣 3.2 元),幾乎是 Qwen3.8-27B 的一半。
短板:知識、多輪對話與監控疑慮
迴圈能增加思考深度,卻不能讓權重裝下更多事實,知識量大致取決於總參數。 AA-Omniscience 的事實性分數上,Inkling 2 Mini 是 -8.6、不幻覺率 63.4%,落後 Qwen3.8-27B 的 -6.4 與 71.4%。官方也承認它不是多輪對話與多約束指令的頂級小模型:MultiChallenge 50.0%、ComplexConstraints v1.1 33.4%,兩項都輸給 Qwen,推理重的 CritPt v2、HLE-Diamond 也落後更大的模型。
迴圈架構還帶來一個安全問題:模型在內部做了更多「沒寫出來的思考」,外界讀它思維鏈(CoT)進行監控的能力會不會下降?Thinking Machines 一併發布可變迴圈研究版 TML-d24-varloop-research,實測 5 次迴圈的推理長度只剩 1 次的一半(平均 1,661 對 3,703 token),但可讀性不變,CoT 操控測試中模型幾乎無法刻意改寫自己的思維鏈(遵循率最高 0.1%),LinuxArena 監控評估也沒看出迴圈次數與規避監控有明確關聯。 該公司也把模型提供給 Goodfire、NDIF 等可解釋性研究機構,主動邀請社群研究迴圈模型的內部計算。
社群評價:本地圈興奮,也有「炒作」質疑
Hugging Face 官方部落格給出高評價,稱 vibe 測試中至少可比 Qwen3.8-27B,並上線 transformers、llama.cpp、MLX 的首日支援,Unsloth 隨後發布 16.6GB 的 4-bit 量化版。Reddit r/LocalLLaMA 的實測者回報 RTX Pro 6000 上單併發約 200 token/s、4 併發聚合約 550 token/s,已經略快於 27B 級對手;也有人偏好它比 Qwen 系模型更省記憶體,「盲測分不出差別」。
反方聲音同樣清楚,同一討論串轉述的批評影片指美國模型存在炒作、中美模型評價雙標,社群則反駁該說法沒有證據;有實測者指出 llama.cpp 初期實作有 bug 影響品質,稠密未壓縮的 attention 在長上下文下會明顯拖慢生成速度,模型偶爾卡在重複除錯迴圈,中文等非英文輸出偶有截斷。 LM Studio 的模型頁也提醒:把這個迴圈架構跑好需要設定輸出與代理回合上限、沙箱化編程代理、破壞性動作前要確認。
以意義來看,Inkling 2 Mini 代表了能力強且消費端能運行的開源模型並非只有中國的模型可選擇,它的出現讓一些禁止使用中國開源模型的單位有了其他的選擇,至於能力如何就等大家自己測試使用看看。