
最近 Google 可說在加速 AI 模型的發展,繼上週發表 Gemini 4 Hydrogen 後,稍早就推出對標 Claude Opus 5.5 和 GPT-6.2 Sol 的「Gemini 4 Neo」全新模型,主打擁有旗艦等級的推理能力,同時把速度和成本控制在比較好入手的範圍,屬於「夠強又不會太貴」的中間型模型。當然,就跟過往一樣,Gemini 4 Neo 在官方的測試中許多成績都超越競爭對手,GPT-6.2 Sol 算比較可憐,才剛推出就立刻被超越(笑)。
Google 推出 Gemini 4 Neon:19 項測試 16 項勝出,正面挑戰 Opus 5.5、GPT-6.2 Sol,API 價格比 Opus 便宜 25%
Google 稍早宣布推出 Gemini 4 Neon,成為 Gemini 4 系列的新成員。
目前這系列的分工是:Carbon 負責最困難、最長時間的複雜專案。Hydrogen 則是負責快速的日常執行。而最新推出的 Neon 介於 Carbon 與 Hydrogen 之間,主打兼顧效能與效率的複雜軟體工程、知識工作和科學研究流程,支援 100 萬 Token 上下文:
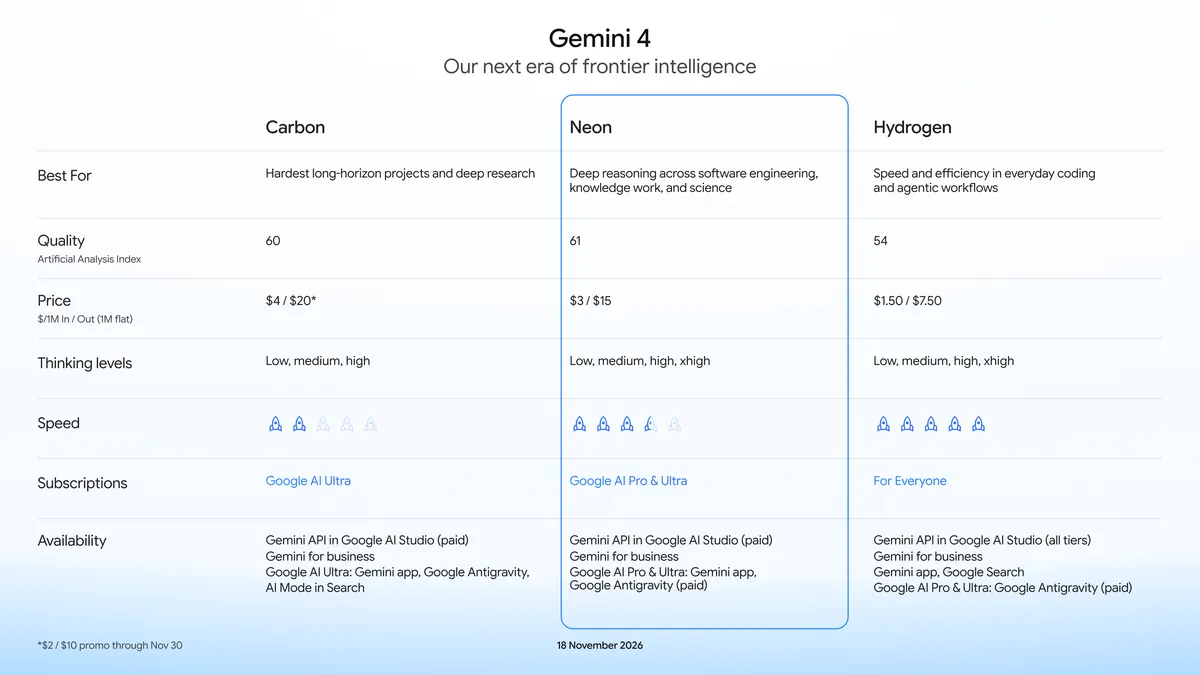
至於最早推出的 Argon,則是主力旗艦推理模型,適合大多數軟體工程與知識工作。
下方是 Google DeepMind 公布的 Neon 評測成績,與 Opus 5.5、GPT-6.2 Sol 一同比較:
| 測試項目 | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| 綜合能力 | |||
| AA Index v5.0.1 | 61 | 59 | 57 |
| Vals Index v2.2 | 70.9% | 70.1% | 66.1% |
| AI 代理程式與程式開發 | |||
| CursorBench 4.1 | 65.4% | 58.1% | — |
| Terminal-Bench 4.1 | 65.2% | 65.8% | 61.5% |
| FrontierCode 2.0 | 46.2% | 47.3% | 43.8% |
| SWE-sweep(Provider harness) | 39.0% | 10.1% | 8.3% |
| SWE-sweep(Mini-SWE harness) | 12.8% | 3.6% | 11.6% |
| 知識工作與自動化 | |||
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| 科學與數學 | |||
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| 推理能力 | |||
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
| 多模態理解 | |||
| MKA(Climb WSR) | 56.5% | 53.0% | 52.7% |
| Chartography | 73.5% | 66.3% | 75.1% |
| LVBench | 89.0% | 83.7% | 87.6% |
| 長上下文能力 | |||
| GraphWalks(256K–1M,BFS F1) | 95.2% | 66.8% | 80.1% |
| 網路安全 | |||
| CWE-Bench v2 | 70.7% | 67.1% | 66.0% |
| SEC-bench Pro | 90.5% | — | 88.3% |
| WebExploitBench v1.2 | 51.3% | 37.1% | — |
註:粗體代表該項目表列最高分;「—」代表未公布成績。不同測試的評分標準不同,不宜直接比較。SWE-sweep 的 Provider harness 與 Mini-SWE harness 使用不同測試環境。
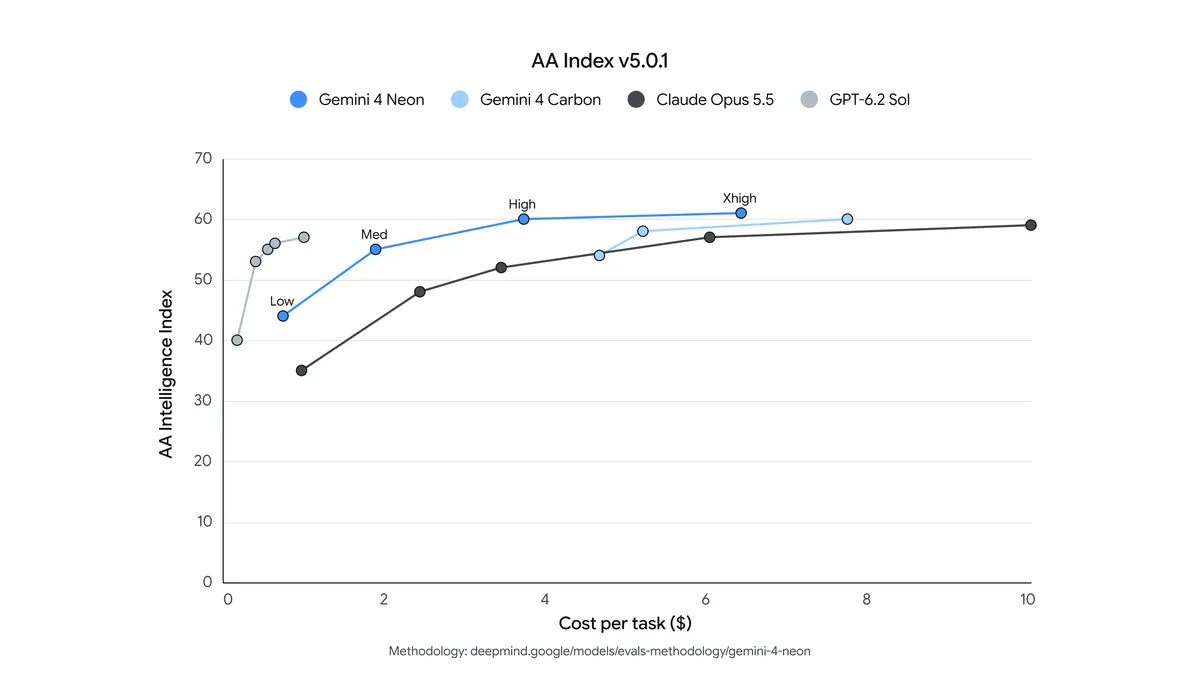
AA 綜合能力指數是第三方機構 Artificial Analysis 的「AI 智商分數」,Neon 在最高的 xhigh 思考層級拿到 61 分,比 Opus 5.5 的 59 分和 GPT-6.2 Sol 的 57 分都高。Vals Index 是測法律、金融、稅務這類專業工作的指數,Neon 拿到 70.9%,同樣都領先競爭對手:
而最多人在意的寫程式能力,Neon 的成績有贏有輸。
像是 Cursor 提供的 CursorBench 4.1 拿到 65.4%,明顯高於 Opus 5.5 的 58.1%。Artificial Analysis 的程式代理指數也以 58.6 分排名第一。
但在終端機操作測試 Terminal-Bench 4.1 上,Neon 拿到 65.2%,Opus 5.5 是 65.8%,小幅領先 0.6%,GPT-6.2 Sol 為 61.5%。程式能力測試 FrontierCode 2.0 也是類似狀況,Opus 5.5 的 47.3% 領先 Neon 的 46.2%,GPT-6.2 Sol 則是 43.8%。不過差距都在 1% 左右,不是說非常大。
SWE-sweep 是最值得注意的,Neon 在 Google Antigravity 拿到 39.0%,Opus 5.5 用 Claude Code 只有 10.1%,GPT-6.2 Sol 用 Codex 只有 8.3%,可說壓倒性勝利。
不過有趣的地方在,換成三家共用的 mini-SWE 環境後,Neon 掉到 12.8%,GPT-6.2 Sol 是 11.6%,差距只剩 1.2%,Opus 5.5 則只有 3.6%。
AI 自動化也是 Neon 明顯領先競爭對手的項目之一。
Zapier 推出的 AutomationBench 測試中,Neon 拿到 56.3% 排名第一,Opus 5.5 是 42.5%,GPT-6.2 Sol 是 41.3%,領先將近 14%。另外在模擬經營自動販賣機一整年的 Vending-Bench 2 中,Neon 最後的銀行帳戶餘額達到 16,843 美元,同樣排名第一。
Gemini 4 Neon 目前已經推出,可以透過以下管道體驗:
- Gemini App:Google AI Pro 和 Ultra 訂閱者可以從模型下拉選單選擇 Neon
- Google Antigravity:付費的 Google AI Pro 和 Ultra 訂閱者可以使用
- Google AI Studio:Pro 和 Ultra 訂閱者可以試用
- 開發者:透過 Gemini API 付費層級、Android Studio 使用
- 企業:透過 Gemini for business 的 API 或模型選單使用
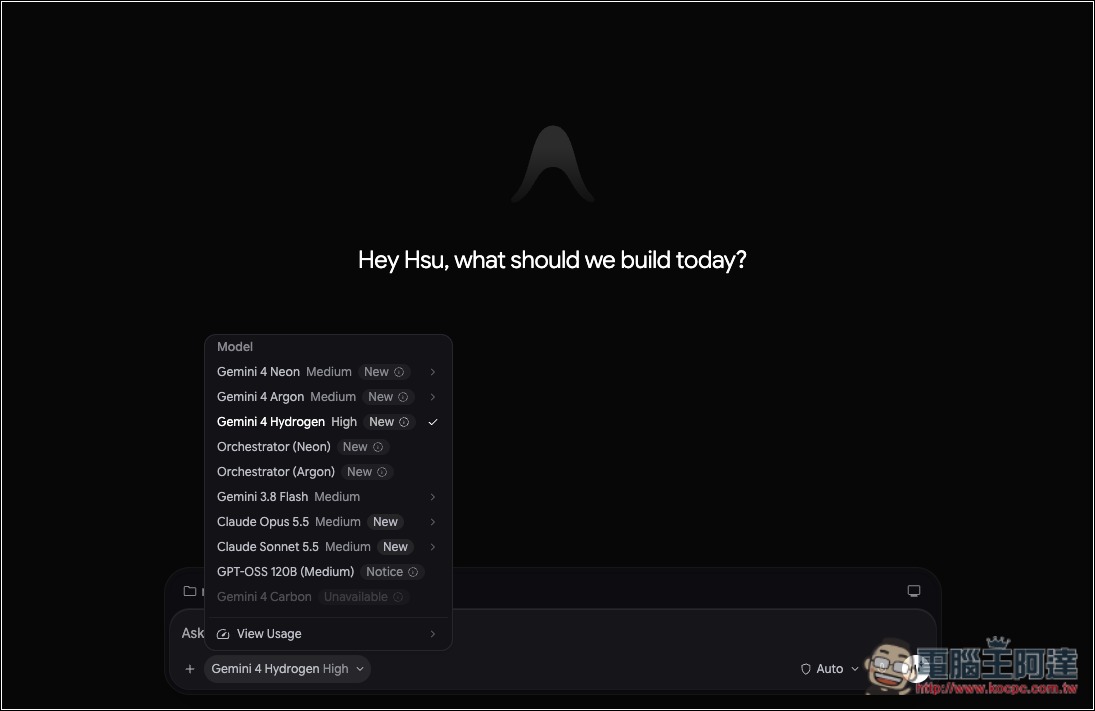
Gemini 4 Neon 的 API 定價為每 100 萬輸入 Token 3 美元、輸出 Token 15 美元,快取輸入則是 0.15 美元,比一般輸入便宜 95%。下面是三款模型的標準 API 價格對比:
| 模型 | 輸入 | 輸出 | 快取輸入 |
|---|---|---|---|
| Gemini 4 Neon | $3 | $15 | $0.15 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6.2 Sol | $2 | $10 | $0.10 |