Meta 在 2026 年 11 月 9 日發表 Muse 系列中最小、最省錢的模型「Muse Ember」,主打讓 AI 代理大量執行重複性工作,包括工具呼叫、程式開發子任務、請求路由、資料擷取與長文件解析。發布隔天,Artificial Analysis、Vals AI、Arena.ai 等第三方評測機構陸續公布成績單:這款模型在多項基準上追平 Anthropic 的 Claude Haiku 5.5 與 OpenAI 的 GPT-6 Luna,實際花費卻只有對手的約三分之一。
智能分數追平 Claude Haiku 5.5,每任務成本剩三分之一
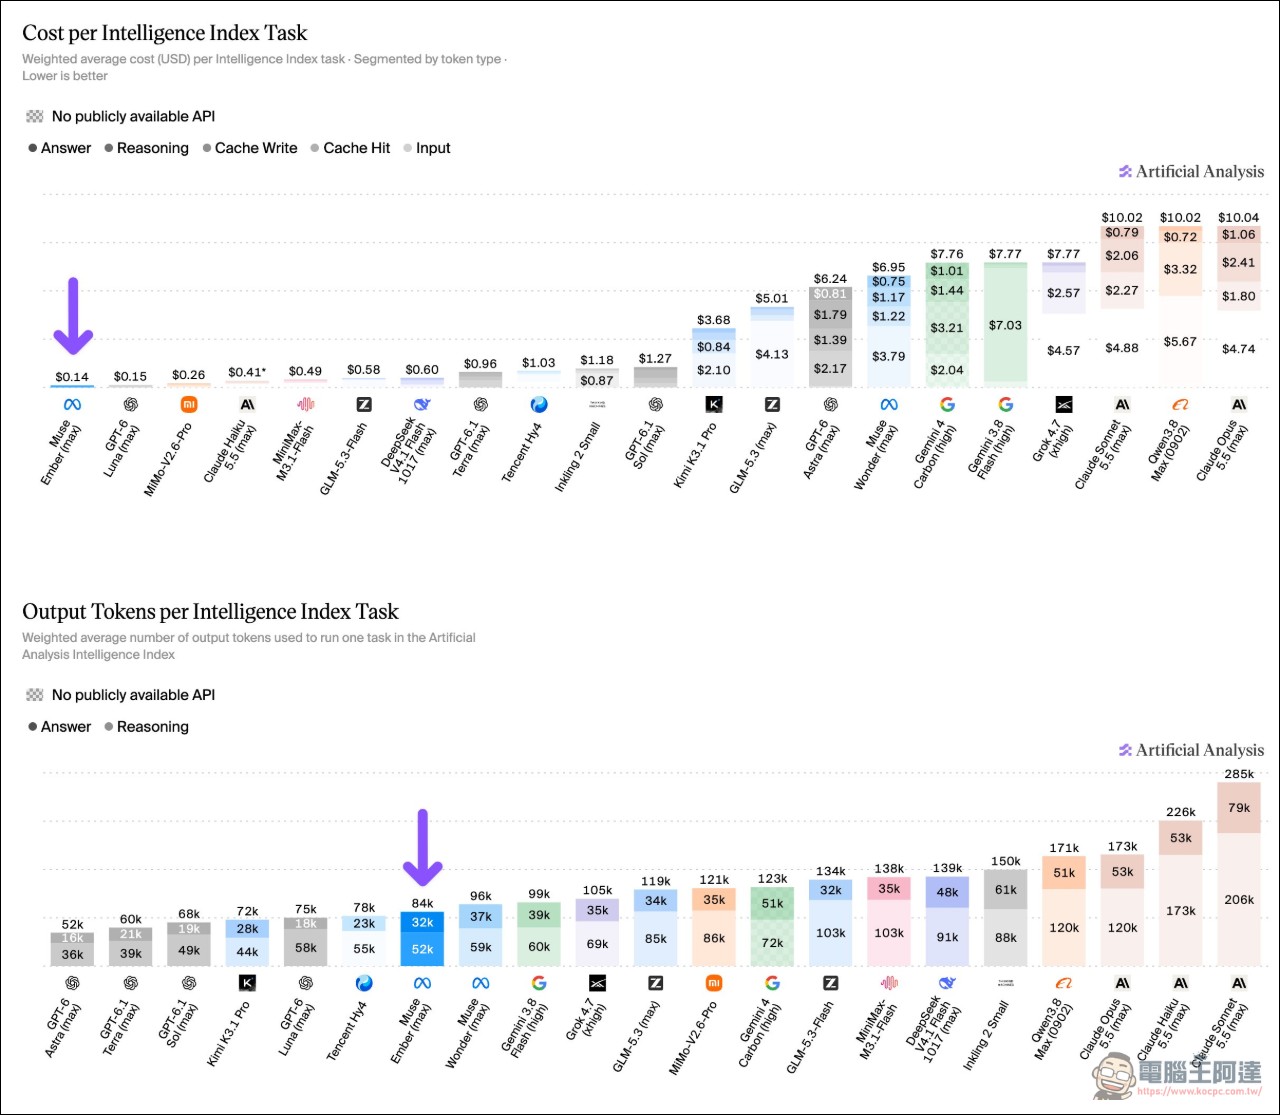
根據 Artificial Analysis 的評測,Muse Ember 在衡量綜合智能的「Intelligence Index」拿下 36 分,與 Claude Haiku 5.5 最高推理設定同分;Meta 公布的未取整數值是 35.8 對 36.2,差距很小。每個評測任務的處理成本方面,Muse Ember 約 0.14 美元(約 NT$4.4),Claude Haiku 5.5 為 0.41 美元(約 NT$12.9)。OpenAI 的 GPT-6 Luna 最高設定得 27.8 分、每任務約 0.15 美元,較低設定降到約 0.07 美元但分數只剩 21.4 分。
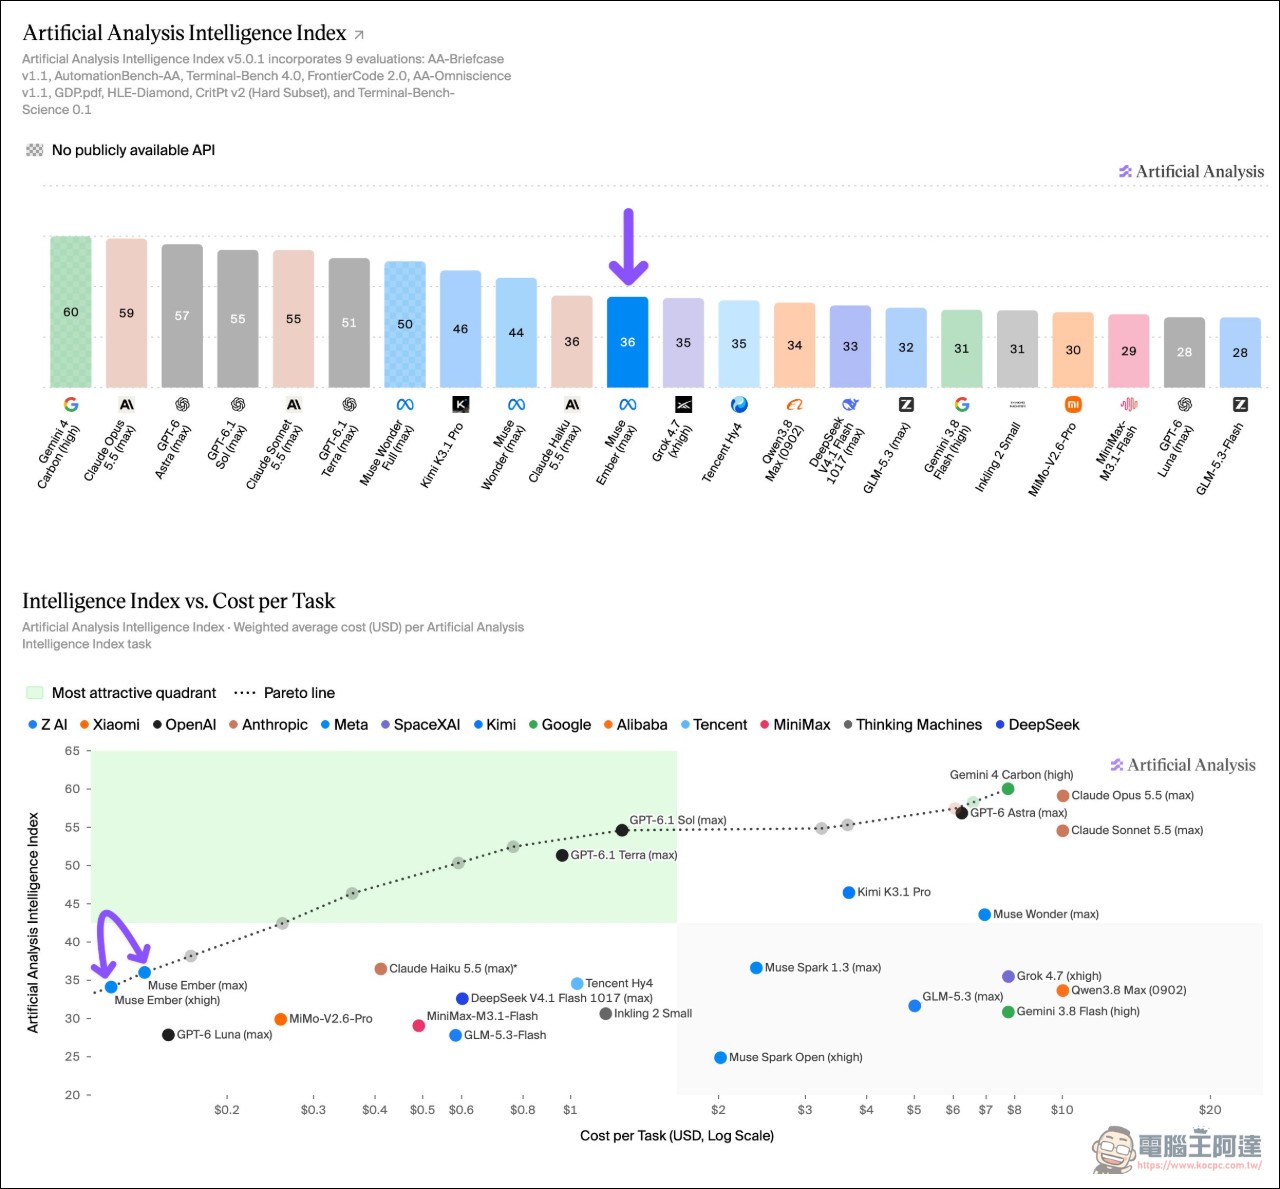
有意思的是,兩家的 API 單價完全一樣:輸入每百萬 token 0.10 美元(約 NT$3.2)、輸出每百萬 token 0.50 美元(約 NT$15.8)。Artificial Analysis 分析成本差距的來源有兩個:Muse Ember 的快取輸入 token 價格便宜 60%,而在該機構的代理評測裡,快取輸入正是成本大頭;另外 Muse Ember 處理同一個任務所需的輸出 token 只有 Claude Haiku 5.5 的約三分之一。Meta 官方部落格同樣引用這組數據,強調 Muse Ember 排在效率與智能的最佳組合位置上,沒有任何模型能用更低的每任務成本拿到更高分數。
弱點在知識問答,但很少亂講
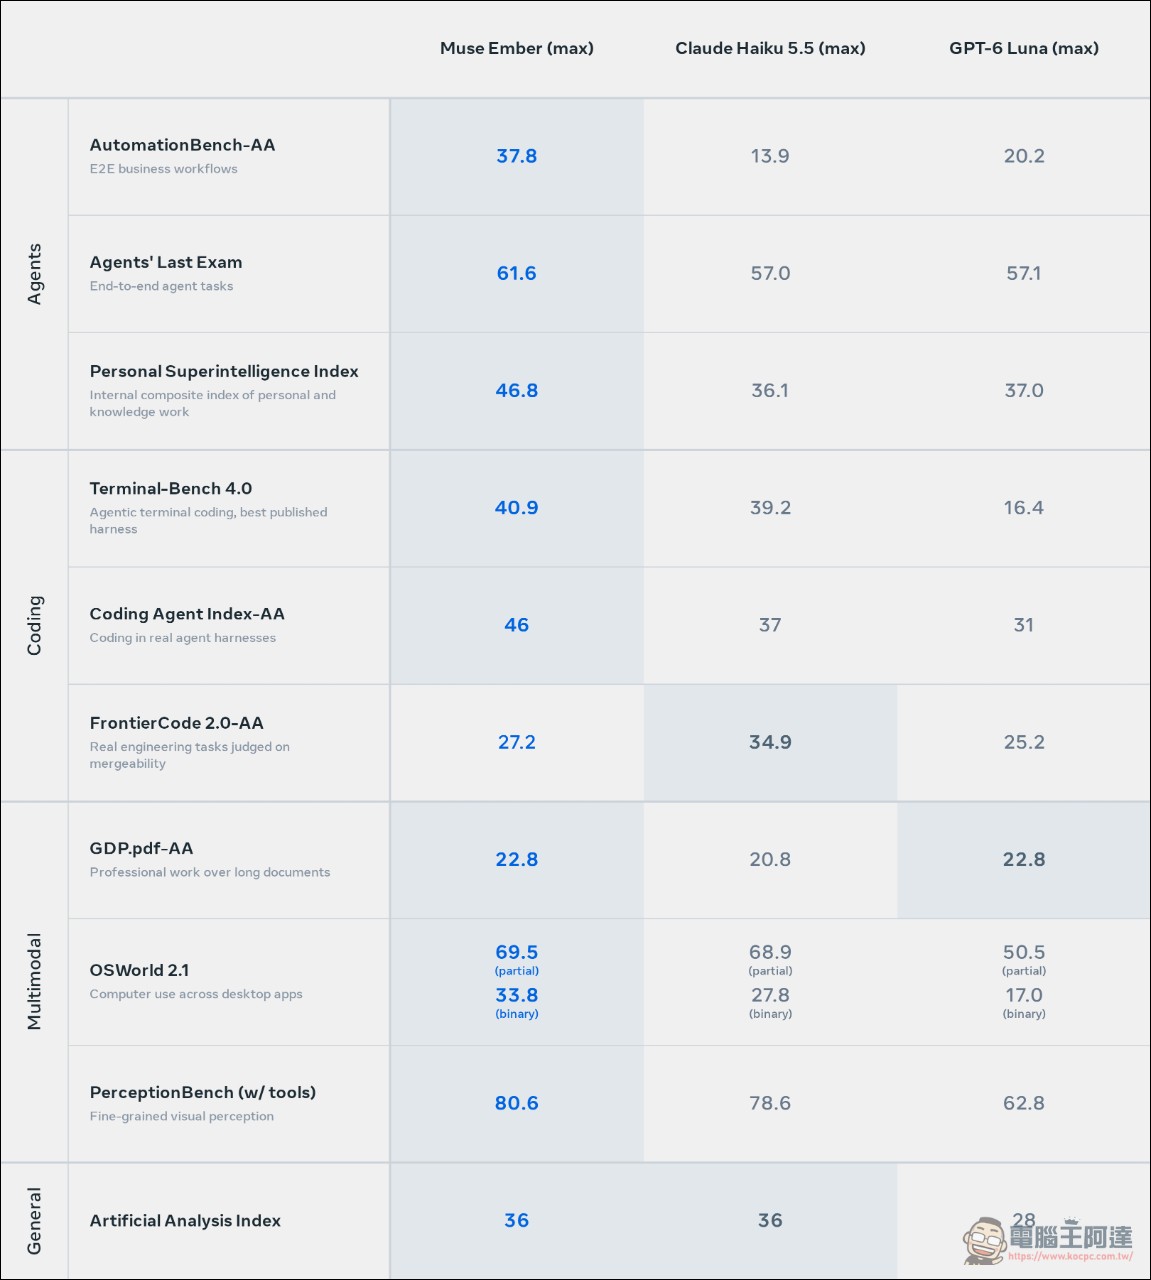
Muse Ember 並非面面俱到。在 Artificial Analysis 的知識測試「AA-Omniscience」中,它的正答率只有 21.1%,在同級智能的模型裡最低,主因是它對 64% 的問題選擇拒答。這種保守策略帶來的好處是幻覺率低:產生錯誤資訊的比率為 17.4%,約是 Claude Haiku 5.5 的一半。Muse Ember 在多數基準上只贏 Haiku 與 Luna 幾個百分點,優勢集中在特定用途。在接近真實軟體開發情境的「FrontierCode 2.0」評測中,Muse Ember 輸給了 Claude Haiku 5.5。
法律、金融、代理自動化是強項
另一家評測機構 Vals AI 的「Vals Index v2.2」給 Muse Ember 60.48%,在 35 個模型中排第 12;每次測試成本約 0.15 美元(約 NT$4.7),是全場最便宜,完成測試只花約 15 分鐘,在前 12 名中最快。拆看個別領域,它在法律類「Legal Index」拿第 4(共 36 個模型),專業任務「HLAB-Vals-1.1」並列第 2,金融「Finance Index」第 10(共 38 個模型),終端機程式設計「Terminal-Bench 4.0」第 15(共 62 個模型),稅務代理「Tax Agent Bench」第 14(共 83 個模型)。
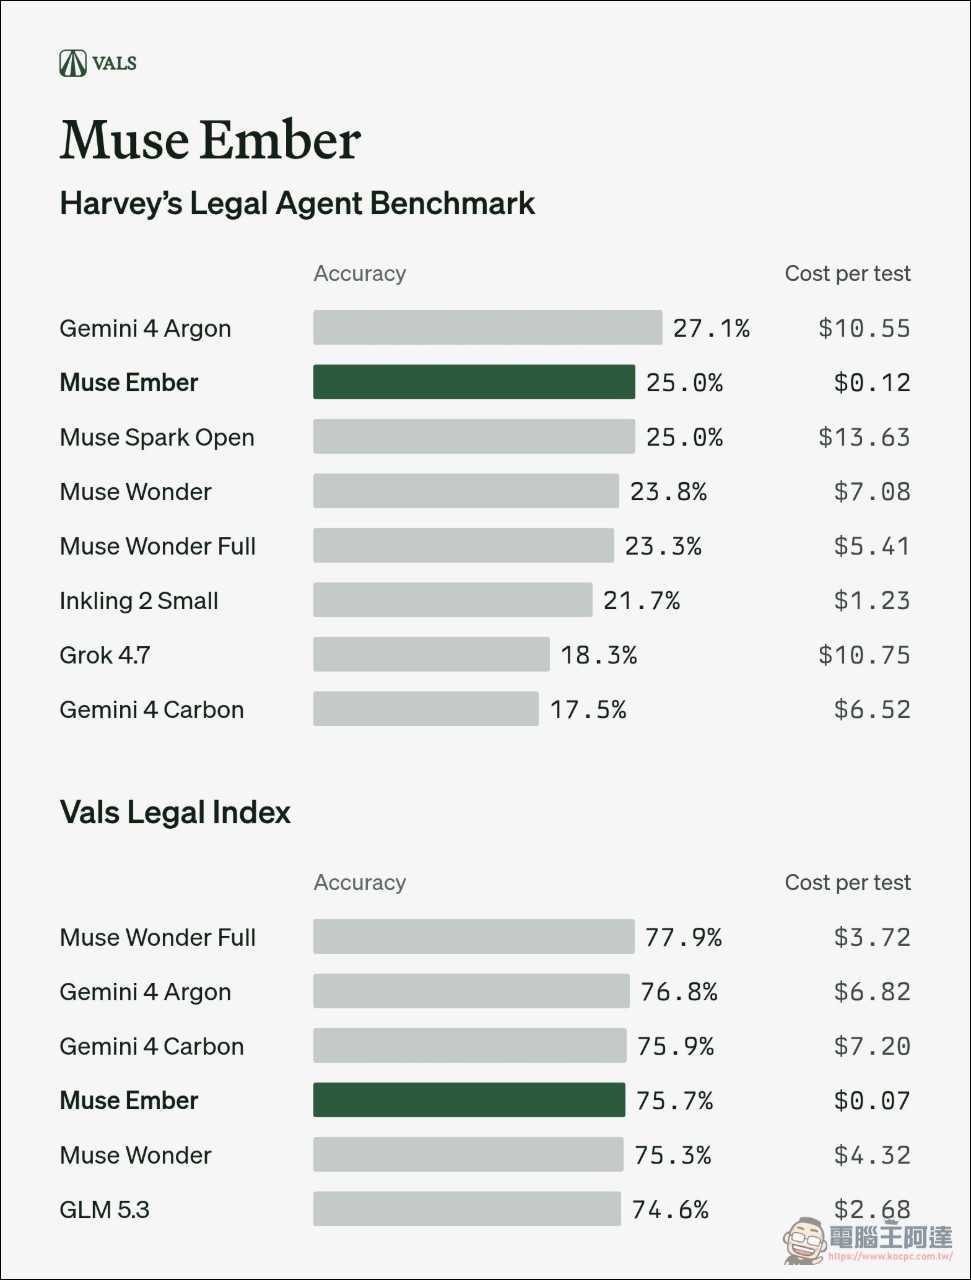
Muse Ember 領先幅度最大的地方是企業流程自動化:在涵蓋 Gmail、Salesforce 等雲端應用 657 個任務的「AutomationBench-AA」上,它比 Haiku 與 Luna 領先 17%,其他基準的優勢多半只有幾個百分點。這是 Meta 第一個用自家旗艦模型 Muse Wonder 訓練出來的 AI,Meta 沒有說明具體自動化哪個環節,推測方向包括後訓練流程。常見的多模型架構裡,旗艦模型負責把工作拆成小任務,再派給低成本模型驅動的代理去跑,Meta 表明 Muse Ember 就是為後者這個角色優化的。
網頁開發小型模型中第一
專攻網頁開發評測的 Arena.ai 公布,Muse Ember 最高推理設定在「Code Arena: WebDev」拿到 1608 分,是小型 AI 模型中的最高成績,超過 Claude Haiku 5.5(高設定)的 1595 分與 GPT-6 Luna(最高設定)的 1578 分;兩款競品在總榜分別排第 35 與第 42,Muse Ember 的 1608 分對應總榜約第 34 位。成本端更明顯:網頁開發任務每件的中位數成本,Muse Ember 是 0.03 美元(約 NT$0.9),GPT-6 Luna 為 0.06 美元、Claude Haiku 5.5 為 0.11 美元(約 NT$3.5)。
Muse Ember (Max) from @AIatMeta just landed in the Code Arena: WebDev as the highest-performing small model – built for fast, high-quality, low-cost work. Watch the video below: 20+ websites and animations, all generated by Ember in one go. Across the generations we timed, the average was about 2 minutes and about $0.04 per task.
— Arena.ai (@arena) November 9, 2026
發布定位上,Meta 把 Muse Ember 放進代理系統的分工架構:AI 代理能把複雜任務拆成小工作反覆執行,例如軟體開發裡讀檔案、跑測試、改程式碼,這些步驟如果一路交給昂貴的前沿模型,成本會迅速累積,Muse Ember 的目標就是大量處理這類較小的作業。
定價結構與超過 20 萬 token 的價格跳漲
Muse Ember 以「muse-ember-1.0」名稱在 Meta Model API 上線,支援 Responses、Chat Completions 與 Messages 端點,可讀取文字、圖片、音訊、影片與 PDF,輸出文字,推理強度從最低到最高皆可設定,預設為最高。情境視窗達 1,048,576 token,最大輸出 524,288 token。定價分兩級:輸入不超過 200,000 token 時,未快取輸入每百萬 0.10 美元、快取輸入每百萬 0.004 美元、輸出每百萬 0.50 美元;一旦跨過 200,000 token,整份請求(含輸出)改按 0.30、0.012 與 1.50 美元計費。
取用管道方面,除了 Meta Model API,Muse Ember 也整合進 Meta 自家的程式輔助工具 Muse Code,Meta 同時列出 Oracle Cloud 作為另一條取用路線,Google Cloud 的預覽文件則記載支援文字與圖片輸入。模型採專有授權,模型權重未開放下載。
高層定調與開發者實際測評
Meta 執行長 Mark Zuckerberg 在 X 上把 Muse Ember 介紹為「我們最小的模型,在同級中提供更高的每美元智能」。首席 AI 官 Alexandr Wang 的說法更直接:「Wonder 負責規劃,Ember 處理量能」。官方部落格也強調 Muse Ember 位於 Artificial Analysis 全榜的效率前緣,在該榜上沒有任何模型能用更低的每任務成本換到更高智能分數。
Releasing Muse Ember today — our smallest model that delivers higher intelligence per dollar than others in its class. Built for token-heavy work that agents repeat all day: tool calls, coding subtasks, routing, extraction, and long document parsing. Available today on the Meta Model API and in Muse Code.
— Mark Zuckerberg (@finkd) November 9, 2026
綜合各家結果,Muse Ember 在知識問答與高難度軟體工程上落後 Claude Haiku 5.5,但在代理反覆執行、企業自動化與網頁開發這類大量重複的場景,它以同價 token、更少的輸出與更便宜的快取,把每任務成本壓到對手的約三分之一。各家評測機構測的任務與執行環境不同,分數不能直接互比;對重視成本與速度的代理工作負載來說,這款模型多了一個實際可選的選項。