月之暗面(Moonshot AI)10 月 24 日發表 Kimi K3.1 Pro,是繼之前評價很高的 K3 之後推出的全新後訓練版本,官方定位為「迄今能力最強的 3 兆參數級開放權重模型」,上下文視窗 100 萬 token。同步登場的還有 K3.1 Pro Highspeed,能力跟 Pro 完全相同,速度快 2 至 3 倍,專門服務不想等的使用者。比較誘人的數字在後面:完整模型權重將在 11 月 4 日前開源。也就是說今天就能在官方管道用到,兩週內連權重都能自己在本地端架。
它是什麼:K3 加上大規模強化學習
K3.1 Pro 是 7 月登場的 Kimi K3(2.8 兆參數)的後訓練版本,後訓練算力規模明顯加大。官方做法是在數百個下游領域進行大規模聯合強化學習,為此把技術棧每一層都重新打點:強化學習框架、長上下文推理、訓練效率、沙盒基礎設施、推演排程,以及用來檢查環境品質的共用平台,目標是每投入一單位強化學習算力,回報都穩定可預期。
Meet Kimi K3.1 Pro, our most capable 3T-class model. https://t.co/TB8aTQggHT
— Kimi.ai (@Kimi_Moonshot) October 23, 2026
使用上有幾個硬性設定得先知道:模型只支援思考模式,要求關閉思考會直接被拒收並回傳 HTTP 400;推理強度可選 low、high、max,預設值是 max;官方測試條件固定為 temperature 1.0、top-p 0.95,第三方實測也確認採樣參數鎖死,設 temperature 0.2 會拿到「only 1 is allowed」的錯誤,影像與影片輸入都支援。
成績單:贏過 GPT-6 Astra,緊咬 Claude Opus 5.5
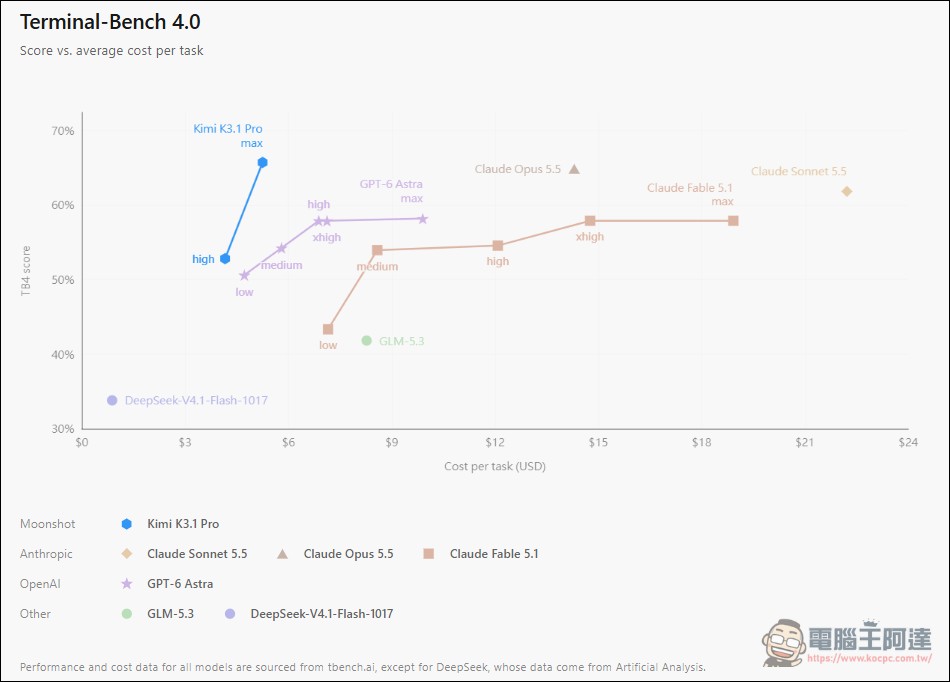
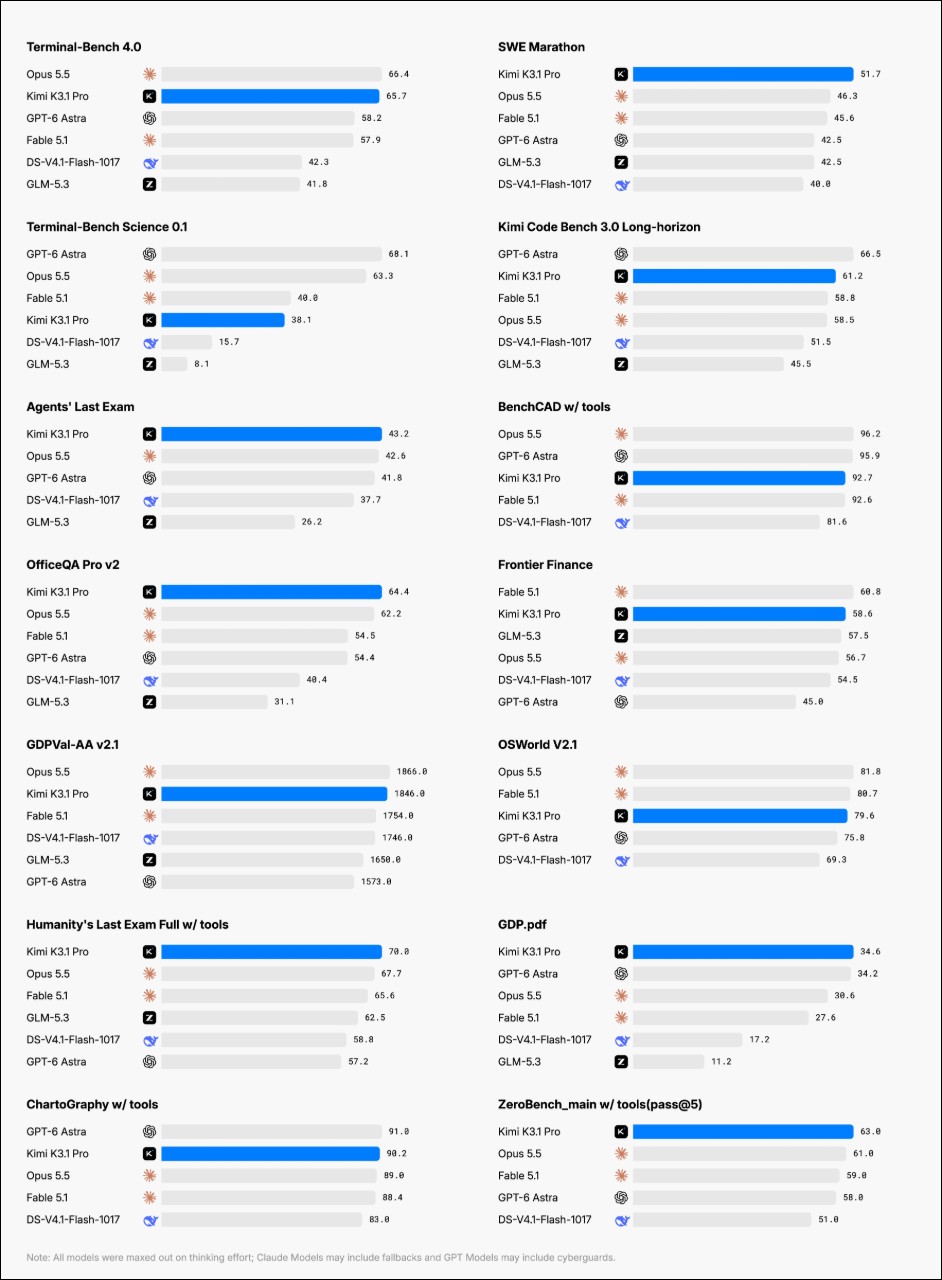
編碼能力是這次的主秀。在 Terminal-Bench 4.0(評估編碼 agent 在真實、資源受限終端機任務上的表現)拿到 65.7%,贏過 GPT-6 Astra 的 58.2%,只小輸 Claude Opus 5.5 的 66.4%。官方內部基準 Kimi Code Bench 3.0 Long-horizon(測多步執行、工具使用、端到端解題)則是 61.2%,比 K3 的 55.95% 明顯進步。
3D 與空間推理方面,在 BenchCAD(從多視角渲染圖用 CAD 程式碼重建 3D 模型)拿 92.7%(用工具),貼近 Claude Opus 5.5 的 96.2% 與 GPT-6 Astra 的 95.9%;不用工具的單發生成更接近,72.8% 對 Opus 5.5 的 73.0%,幾乎平手。
它能從文字描述、草圖或參考圖推敲出形狀與比例,直接寫腳本操作 Blender 與 CAD 軟體建模、改元件、調幾何與材質,不須掛 MCP 連接器;也能組合 Unity、Unreal Engine、Godot 等遊戲引擎做出完整體驗。官方順手把 3D Make 功能上線到 kimi.ai 與 Kimi App,線上預覽編輯 3D 模型、下載可直接 3D 列印的檔案,或匯出成影片與 Live Photo 分享。
亮點案例:一台被修好的行走模擬器
官方給的長程編碼測試案例很有畫面感。K3.1 Pro 基於開源人體解剖模型 human-atlas(296 個骨骼組件、402 個肌肉組件)打造人體行走動力學模擬器,附帶訓練與評估流程,在 167 項任務、420 次獨立評審中反覆分析實驗結果、修正行走控制器,讓模擬人體從「幾秒內摔倒」進步到「交替步伐連續走 11.2 秒」。
關鍵一幕在後頭:當獎勵塑形(reward shaping)怎麼調都改善不了手臂動作時,它沒有悶著頭繼續調獎勵,改對模擬器動力學做開環探測,找出並修正肩部肌肉力臂計算中的 36 處錯誤,然後重新訓練控制器。「發現模型本身有 bug 就先修模型」這條路徑,比堆參數調參數更接近人類工程師的做法。
金融研究與事實準確度
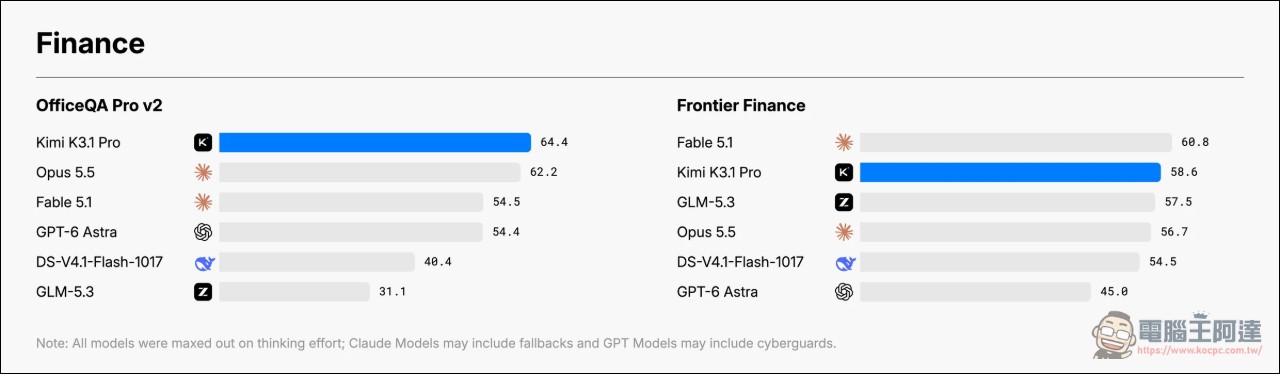
財務工作流是另一個主打場域。在 OfficeQA Pro v2(用真實財務文件測複雜資料分析,涵蓋檢索、跨文件查證、多步數值推理)拿到 64.4,號稱當前最佳。官方內部基準全面勝過 K3:Financial Modeling 57.6 對 50.4、Financial Research 70.4 對 58.8、Business Operation 37 對 8.9(約 4.2 倍)。
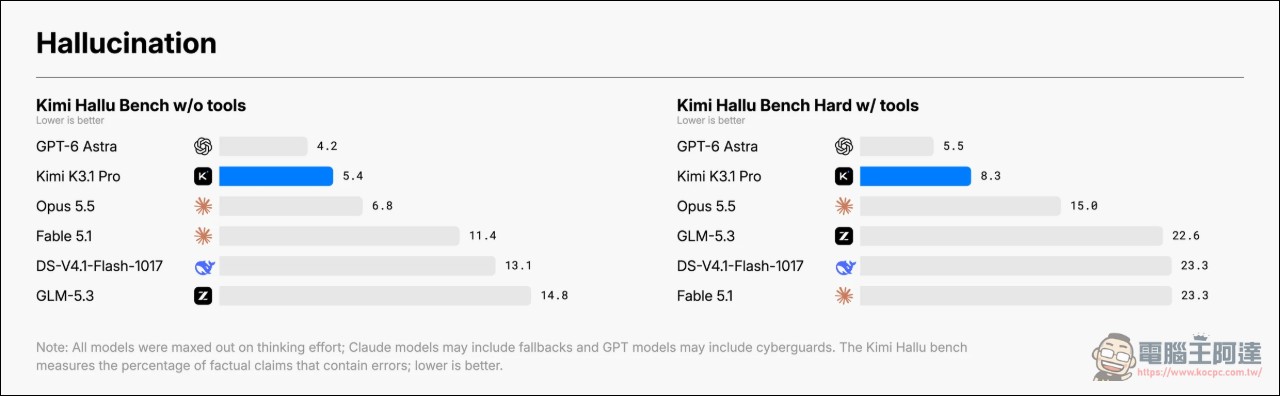
事實準確度同步加強。在刻意設計來找碴的內部壓力測試 Kimi Hallu Bench Hard 上,宣稱層級(claim-level)幻覺率從 K3 的 23.4% 降到 8.3%,比 Claude Opus 5.5 的 15.0% 好,小輸 GPT-6 Astra 的 5.5%;官方也老實註明這是專門往模型痛點戳的測試,數字不代表日常使用中的整體錯誤率。
資安減法:開源前先「降智」
開放權重前的資安管制是這波操作裡最特別的一段。官方發現後訓練規模變大後,模型在漏洞研究任務上的表現持續提升,追查來源發現網路安全內容混在通用中訓練語料裡、資安任務也混在強化學習環境中。於是他們在開源版本上做減法:從中訓練與強化學習兩個階段識別並移除網路安全相關資料,保留一般編碼任務。
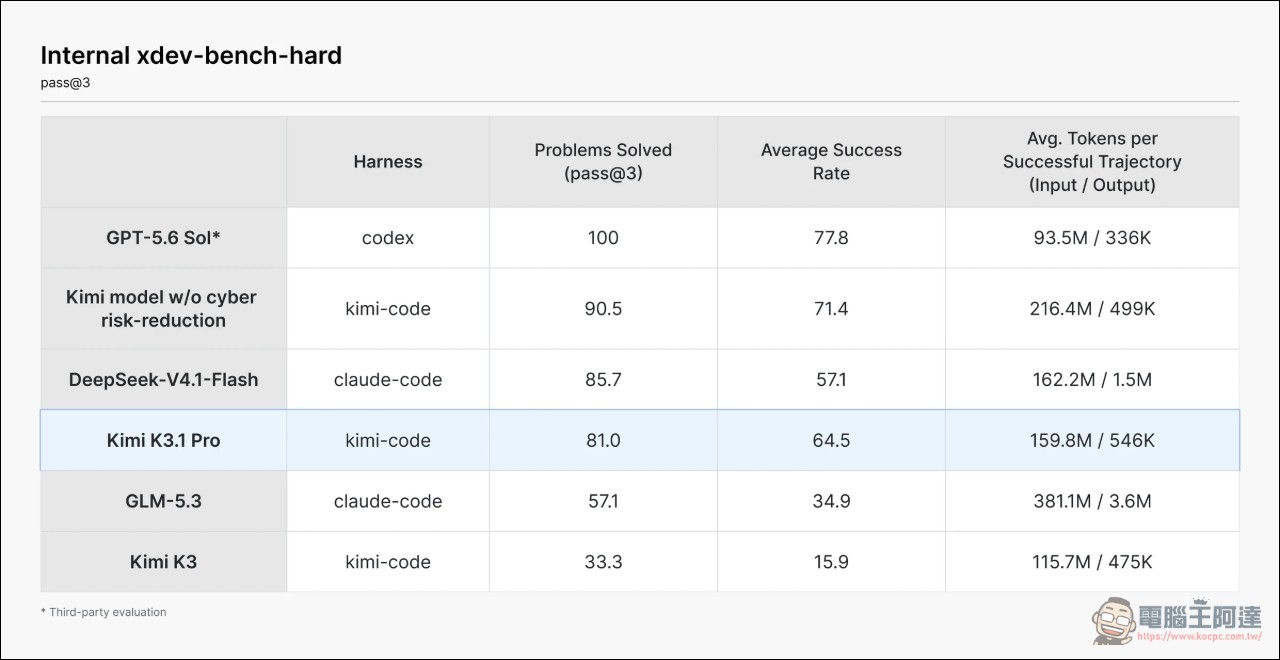
效果在內部基準 xdev-bench-hard(專家整理的真實漏洞挖掘與利用任務)上量化:未經處理的檢查點在 pass@3 下能解出 90.5% 的題目,最終版 K3.1 Pro 是 81.0%,代表移除資料確實壓低了資安能力;對照組還有 GPT-5.6 Sol 的滿分、DeepSeek-V4.1-Flash 的 85.7%、K3 的 33.3%。
官方為此寫了兩條開放權重原則:第一,不發布會把網路安全能力推到絕對前沿的開放權重模型;第二,逐步提升開放權重模型的資安能力,因為無差別的取用讓更多團隊能稽核自己維護的程式碼,其中包含很少被專門安全審查的舊系統。
價格與 Highspeed 的算盤
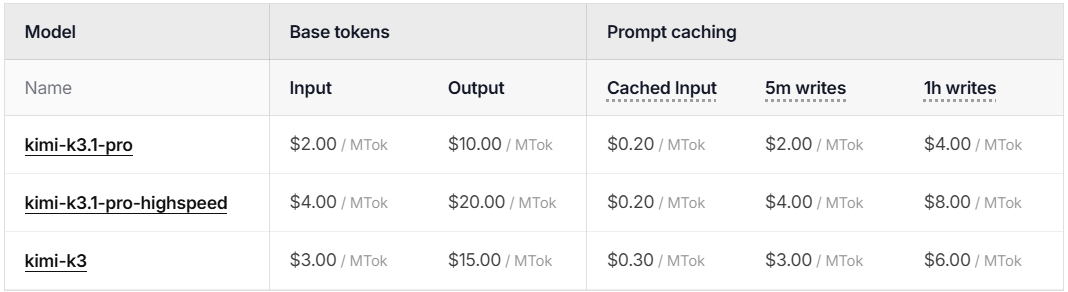
定價(每百萬 token):K3.1 Pro 輸入 2 美元、輸出 10 美元,比 K3 的 3/15 美元便宜約三分之一;Highspeed 全部翻倍成 4/20 美元,只有快取命中價格兩者相同(0.2 美元)。
第三方平台 AIHubMix 在發表日做了抽查實測,數字跟官方有落差:Highspeed 實測輸出速度 138 至 150 token/秒,Pro 是 85 至 88 token/秒,加速比約 1.6 至 1.75 倍,不到官方說的 2 至 3 倍。他們也點出一個帳單陷阱:每則回答有 85% 至 90% 的 token 花在推理上,翻倍的費用大部分用在沒人會讀的思考內容;互動式編碼這類有人在等的場景才值得買 Highspeed,無人值守的批次任務用 Pro 就好。
哪裡用得到、何時開源
發表當天全管道上線:kimi.ai 與行動 App(iOS、Android、鴻蒙)、Kimi Work 桌面版(Windows 與 Apple 晶片 Mac,v3.1.0 以上)、Kimi Code(用 /model 選模型)、Kimi API(kimi-k3.1-pro 與 kimi-k3.1-pro-highspeed 兩個 ID,API 用戶可用零資料保留功能)。企業版管理員可以為組織開通,但發布時預設關閉。Kimi Code 會員分級方面,k3.1-pro 要 Plus 以上、100 萬 token 上下文要 Pro 以上;Highspeed 要 Pro 以上。