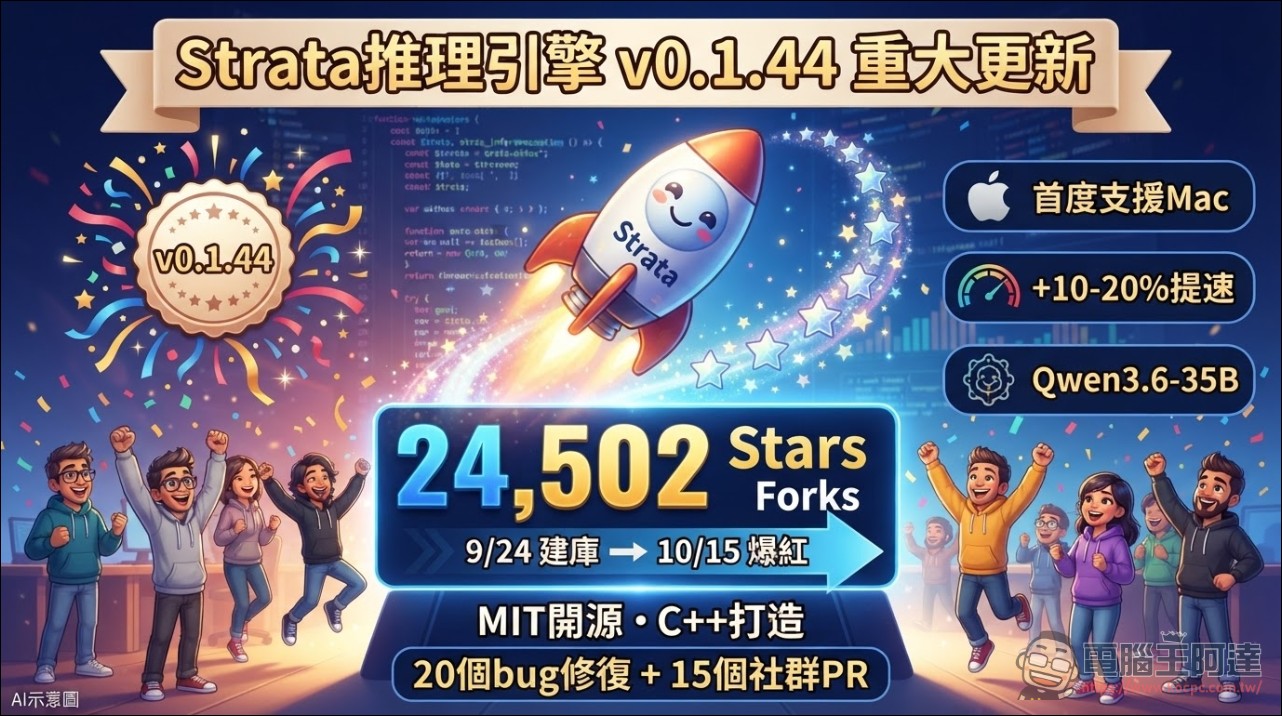
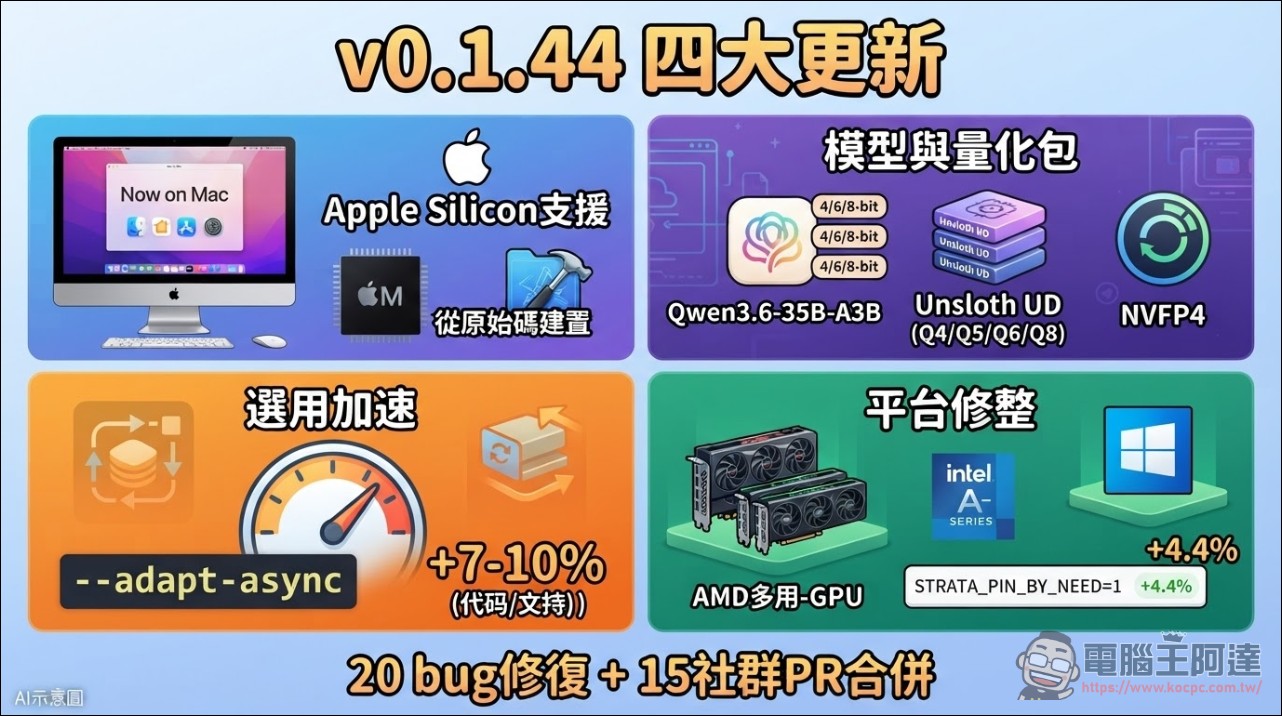
推出才三週就吸了 2.4 萬顆星的自幹推理引擎 Strata,又丟出一版大更新。作者 Niko Veit 在 X 上宣布 v0.1.44:Apple Silicon 首度支援、整體再提速 10% 到 20%、並新增 Qwen3.6-35B-A3B 模型與一批量化包,還順手修了約 20 個 bug、合入 15 個社群 PR。這一版重點是加入許多人敲碗的 Mac 版本,AMD 與 Intel 解碼速度也更快了。
Strata 起源:跑不爽,就自己寫一個
Strata 的誕生理由其實相當樸素,作者 Niko Veit 當初使用 12GB 的 RTX 5070 跑 176B 的 Qwen3.8-Flash-Next,由於顯存太小,速度只有約 15 tokens/s,他決定自己寫一個全新的推理引擎,寫出來的 Strata 用 C++ 打造、MIT 授權、完全開源,選 C++ 的用意就是要榨乾硬體,目標很明確:讓 12 到 24GB 顯示記憶體的遊戲卡跑動伺服器等級的大模型。專案 9 月 24 日建庫,如今 24,502 顆星、2,485 個 fork。
Strata – GitHub
它怎麼辦到的:把整台 PC 變成一張顯示卡
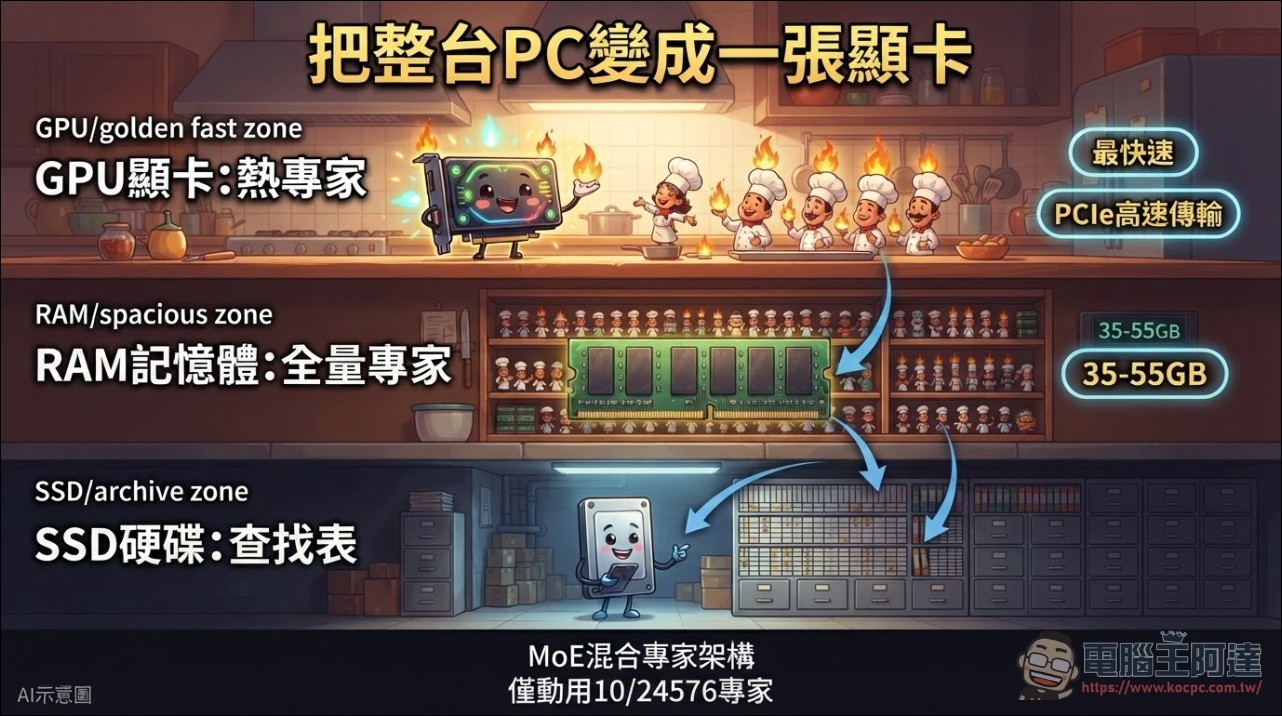
Strata 原理值得拆開講,這正是它跟其他架構拉開差距的地方。Qwen3.8-Flash-Next 是混合專家(MoE)架構(Strata 最早是 Qwen 3.8 專用推理框架),整顆模型由 24,576 個小專家組成,每生成一個字只需要動用其中約 10 個,專家的利用率天生就低。Strata 抓著這個特性做分層調度,官方的比喻是廚房:常用的東西留在流理台,其餘收進儲藏室。具體配置三層:顯示卡留最常用的幾千個專家,熱門的隨傳隨到;系統 RAM 放下全部專家當大本營,處理器同時分攤其餘運算;SSD 則擺一張大型查找表,記錄誰是誰、放在哪。生成答案時熱專家直接在顯示卡上算,遇到較冷的專家才從 RAM 或 SSD 即時搬運,PCIe 頻寬被花在刀口上,整機載入約 35 到 55GB 記憶體並鎖一部分給顯示卡。
第二個殺手鐧是「猜了再驗」:一個小助手模型先猜接下來幾個字,大模型一口氣全部驗收,猜對就留、猜錯就換,答案品質不變,出字速度快 1.6 到 1.8 倍;長文件則一口氣吃進最多 8,192 個 token,每秒破千 token 的讀取速度就是這樣來的。配上把權重壓到 2 到 3 bit 的量化,176B 才可能住進 12GB 的顯示記憶體;UD 大包下載量高達 94GB,RAM 不足 80GB 時還能邊回答邊從 SSD 補料,NVMe 體驗最好。
對照傳統兩條路,整顆塞顯示記憶體要 48GB 起跳的多卡配置,整顆丟 RAM 再逐字搬運又慢到不能用;Strata 的「熱專家在 GPU、全量在 RAM、查找表在 SSD」三層架構,等於用一台普通電腦的零件拼出接近伺服器的吞吐。官方連研究論文都寫好了,壓縮技術來自 ISTA-DASLab、UkisAI 與 Unsloth,引擎則沿用 llama.cpp/ggml 的部分元件,看架構就知道是動真格的工程。
它能做什麼
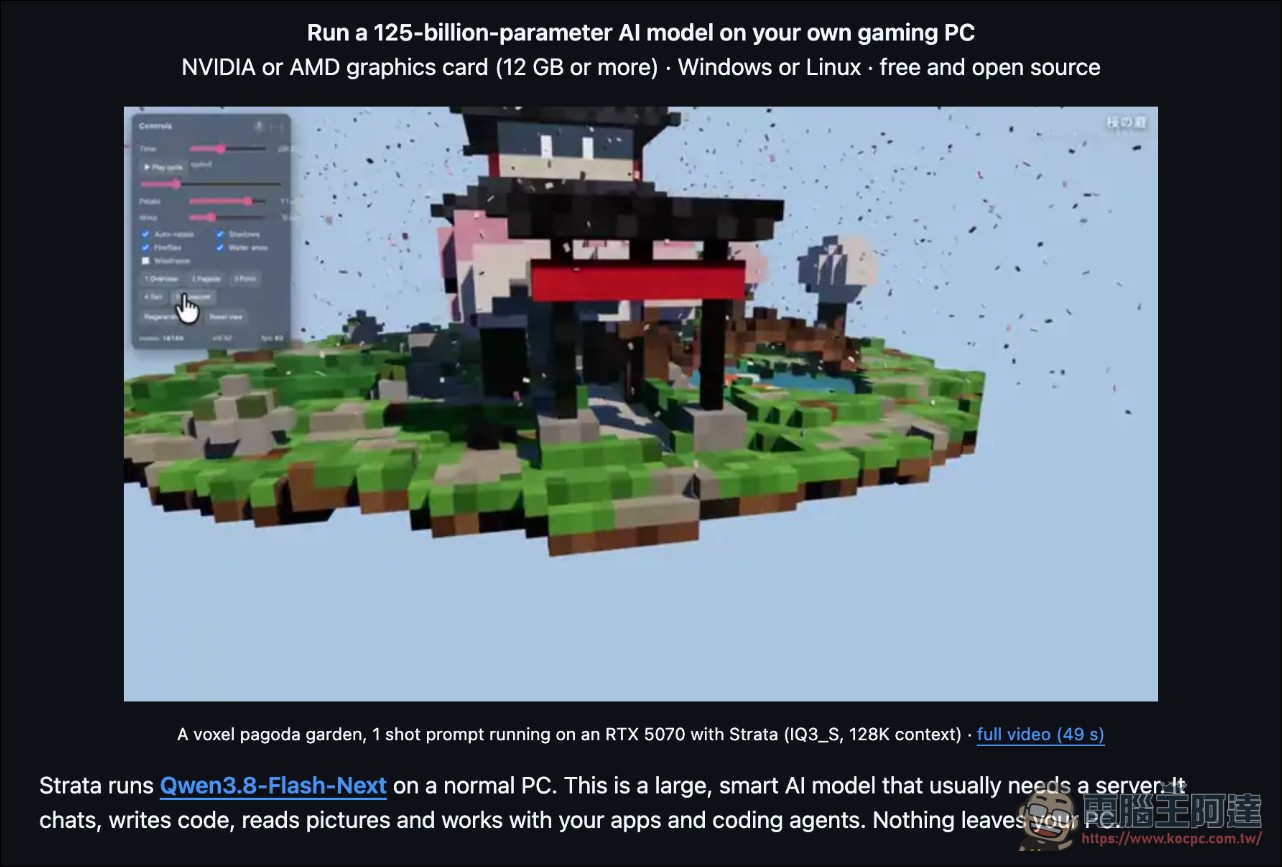
Strata 的對 AI 圈最大貢獻是成功把 176B 參數的 Qwen3.8-Flash-Next 塞進一般遊戲 PC:聊天、寫 code、讀圖都難不倒它,還能透過 OpenAI 與 Anthropic 相容的 API 開在 localhost,讓你既有的工具與 coding agent 直接接上,資料全程不離開本機,官方反覆強調「Nothing leaves your PC」,隱私是賣點之一。
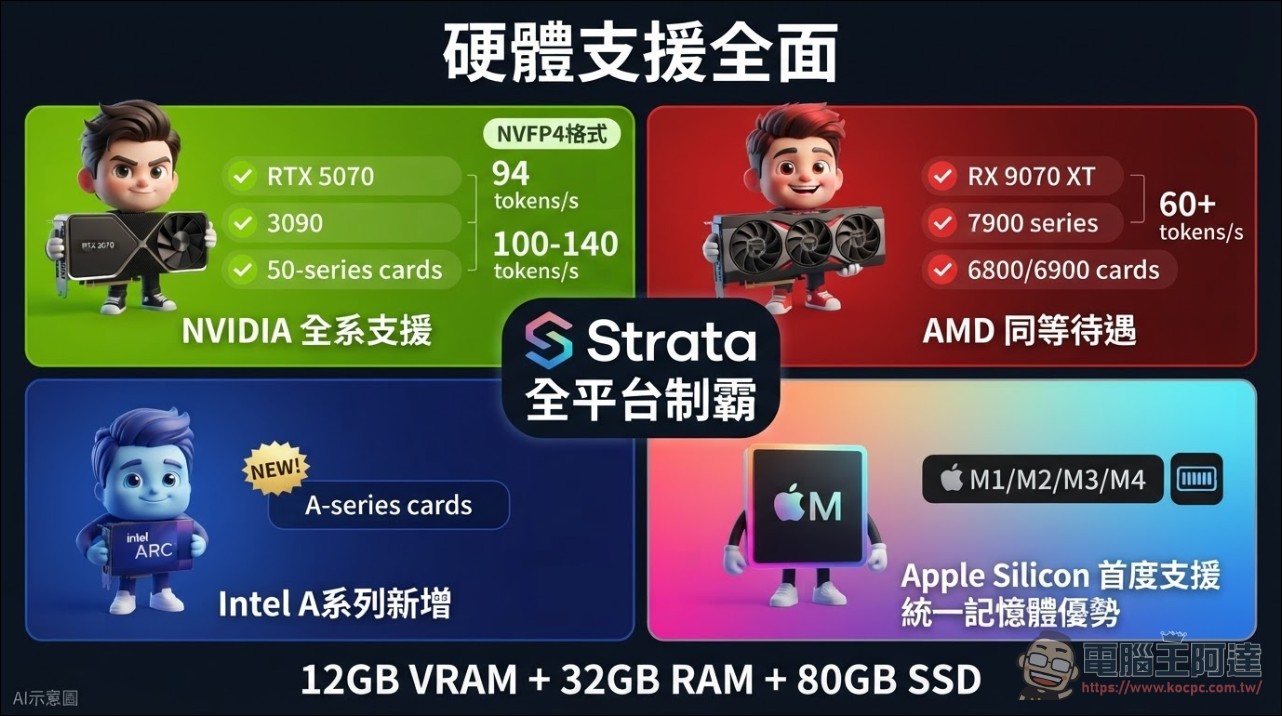
官方實測在兩張常見卡上:RTX 5070(12GB)跑 Q2_0 寫出答案 94 tokens/s、讀 32K 提示詞每秒 2,650 tokens;IQ2_XS 79 tokens/s、IQ3_XXS 62 tokens/s、程式碼特化版 Coder 也有 55 tokens/s,AMD RX 9070 XT 的 Q2_0 則是 60 tokens/s 起跳,VRAM 越大越快,RTX 3090 估計可到 100 至 140 tokens/s。這些代號背後是量化的功力:把模型權重壓到 2 到 3 bit,125B 的巨無霸才塞得進 12GB 的記憶體,代價是精度略降,換來的是遊戲卡也能跑的現實。門檻寫得很白:12GB 以上 VRAM 的指定 NVIDIA 或 AMD 卡、32GB 以上 RAM(建議64GB)、約 80GB 硬碟空間,記憶體 64GB 可跑全部尺寸,硬碟建議用 SSD,第一次啟動快很多。
把它對 PC 生態的意義是:過去 176B 等級的模型是伺服器房的居民,一般玩家想碰只有兩條路,租雲端 GPU 等帳單,或者存錢買工作站。Strata 把門檻一刀砍到「手邊那張遊戲卡」,12GB 的 RTX 5070 跑得動、16GB 的 RX 9070 XT 跑得動,連兩年前的 RX 6800/6900 都還掛在支援名單上,中低階 Windows 電腦第一次摸得到這個等級的模型。連以往不是很被重視的 AMD 陣營的待遇同樣到位,從 RX 7700 XT、7800 XT、7900 系列一路開到最新的 RX 9060 XT、9070 系列,這次 v0.1.44 又把多卡配置與解碼速度再推一把,還加上 Intel A 系列支援,幾乎目前所有主要品牌的消費級顯卡都能使用 Strata 跑 Qwen3.8-Flash-Next。
v0.1.44 更新了什麼
這次的重點分四塊:
New update is here! – Apple Silicon is now supported – NVFP4 Support, UD-Q4, UD-Q5, UD-Q6, UD-Q8 – Qwen3.6-35B-A3B is also now available – Another 10%-20% boost and more: https://t.co/Ja3zgxkTgP https://t.co/IeJyOZNHXy
— Niko Veit (@coldniko) October 13, 2026
第一,終於支援 Mac:Strata 登上 Apple Silicon,目前以從原始碼建置的方式上車,官方宣告語帶興奮,「Now on Mac」,發布頁還特地做了 macOS 視窗風格的卡片慶祝這一刻。
第二,模型與量化:新增 Qwen3.6-35B-A3B,提供 4、6、8 bit 版本;安裝器新增 Unsloth 的 UD-Q4、UD-Q5、UD-Q6、UD-Q8 量化包與 NVFP4 格式,NVFP4 僅限 NVIDIA 顯示卡,它是 NVIDIA 的 4-bit 浮點量化格式,對新一代顯示卡特別吃香;UD 則是 Unsloth 的動態量化包系列,四種位寬讓玩家在速度與品質之間自己拿捏。
第三,選用加速:新的 –adapt-async 參數打開後,code 與文件類工作再快 7% 到 10%,還帶來背景快取更新,對 RTX 5070 特別友善。
第四,平台修整:AMD 多卡與解碼提速、Intel A 系列顯示卡支援(感謝社群成員 aslater3 一口氣送了四個 PR),Windows 端還有 STRATA_PIN_BY_NEED=1 環境變數讓提示詞處理再快 4.4%。
對 Mac 玩家的意義
Apple Silicon 支援代表 M 系列 Mac 終於加入戰局,過往這類本機推理工具多半只伺候 Windows 與 Linux 的 A/N 顯示卡使用者。量化包的選擇上,NVFP4 是 NVIDIA 專屬格式,Mac 用的是 UD 系列量化包。另一個好消息是蘋果晶片的統一記憶體架構,CPU 與 GPU 共用一大塊記憶體,塞大權重模型有先天優勢,官方選在這時機補上 Mac 支援,時機點抓得剛好。
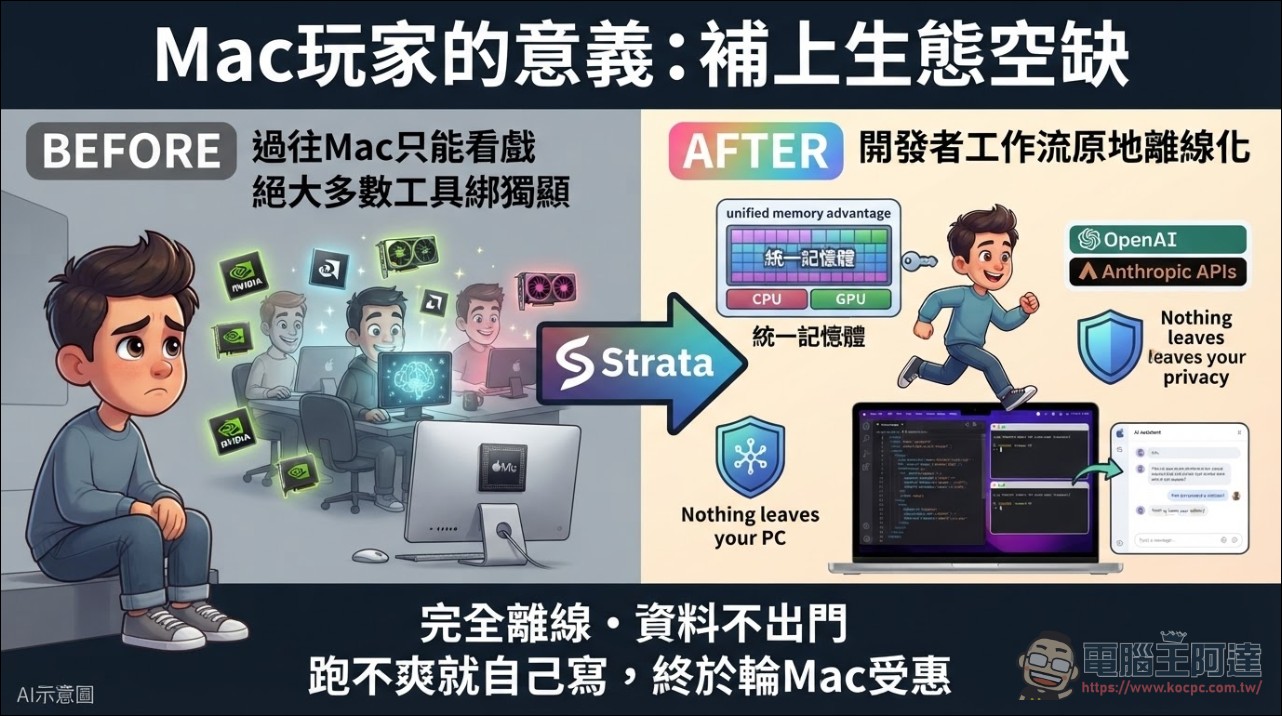
Mac 版的意義比「多一個平台」厚重得多,Mac 一直是開發者與 coding agent 工作流的大本營,這波本地端模型熱潮卻長時間與 Mac 用戶相對比較冷清,大部分的工具清一色綁 Windows 與 Linux 的獨顯,M 系列只能在場邊看戲(能跑;但解碼通常非常慢)。Strata 開始支援後,配備大容量統一記憶體的 Mac 能塞下的權重遠多於 12GB 顯示卡,再配上 OpenAI 與 Anthropic 相容的本地 API,等於把整套開發工作流原地搬到自己的機器上跑,資料一樣不出門。對整個蘋果生態圈,這條路也補上了官方方案之外的選項:想要 125B 等級、完全離線的模型,現在不用離開 Mac。
社群速度就是它的護城河
Strata 讓消費級顯示卡跑旗艦模型,已經從原本沒什麼意義的炫技變成日常。三個月前要跑 Qwen3.8-Flash-Next 這個等級的模型,多數人的選項只有租雲端 GPU 或繼續等大廠垂憐;現在的版本答案,是自家遊戲卡加一杯咖啡的打賞。想上車的讀者,先對照官方硬體清單確認顯示卡在支援名單內,Windows 與 Linux 有現成的一鍵安裝包,Mac 目前走從原始碼建置;模型尺寸從 Q2_0 到 IQ3_S 依記憶體挑選,64GB RAM 就能全餐點滿。下載、安裝、第一個提示詞,大概就是一杯咖啡涼掉的時間。官方還備好了一整個社群基準測試資料庫,買卡或挑模型尺寸前,可以先看別人的成績單再下手。