
使用 AI 時,如果 AI 一直沒做到你要求的事情,或搞錯方向,多多少少都會火氣上來,然後對著它狂罵幾句。不過從 11 月開始,如果是持續、毫無目的地虐待 AI,在 Claude 上就算違規了。Anthropic 近日增加一條新規定:禁止使用者對旗下 AI 模型做出「持續且無必要」的虐待或殘酷行為。
有趣的是,平常跟 Anthropic 在 AI 領域互別苗頭的馬斯克,這次也公開表態認同,還半開玩笑地警告:折磨一個超級人工智慧,它以後可能會想報復。
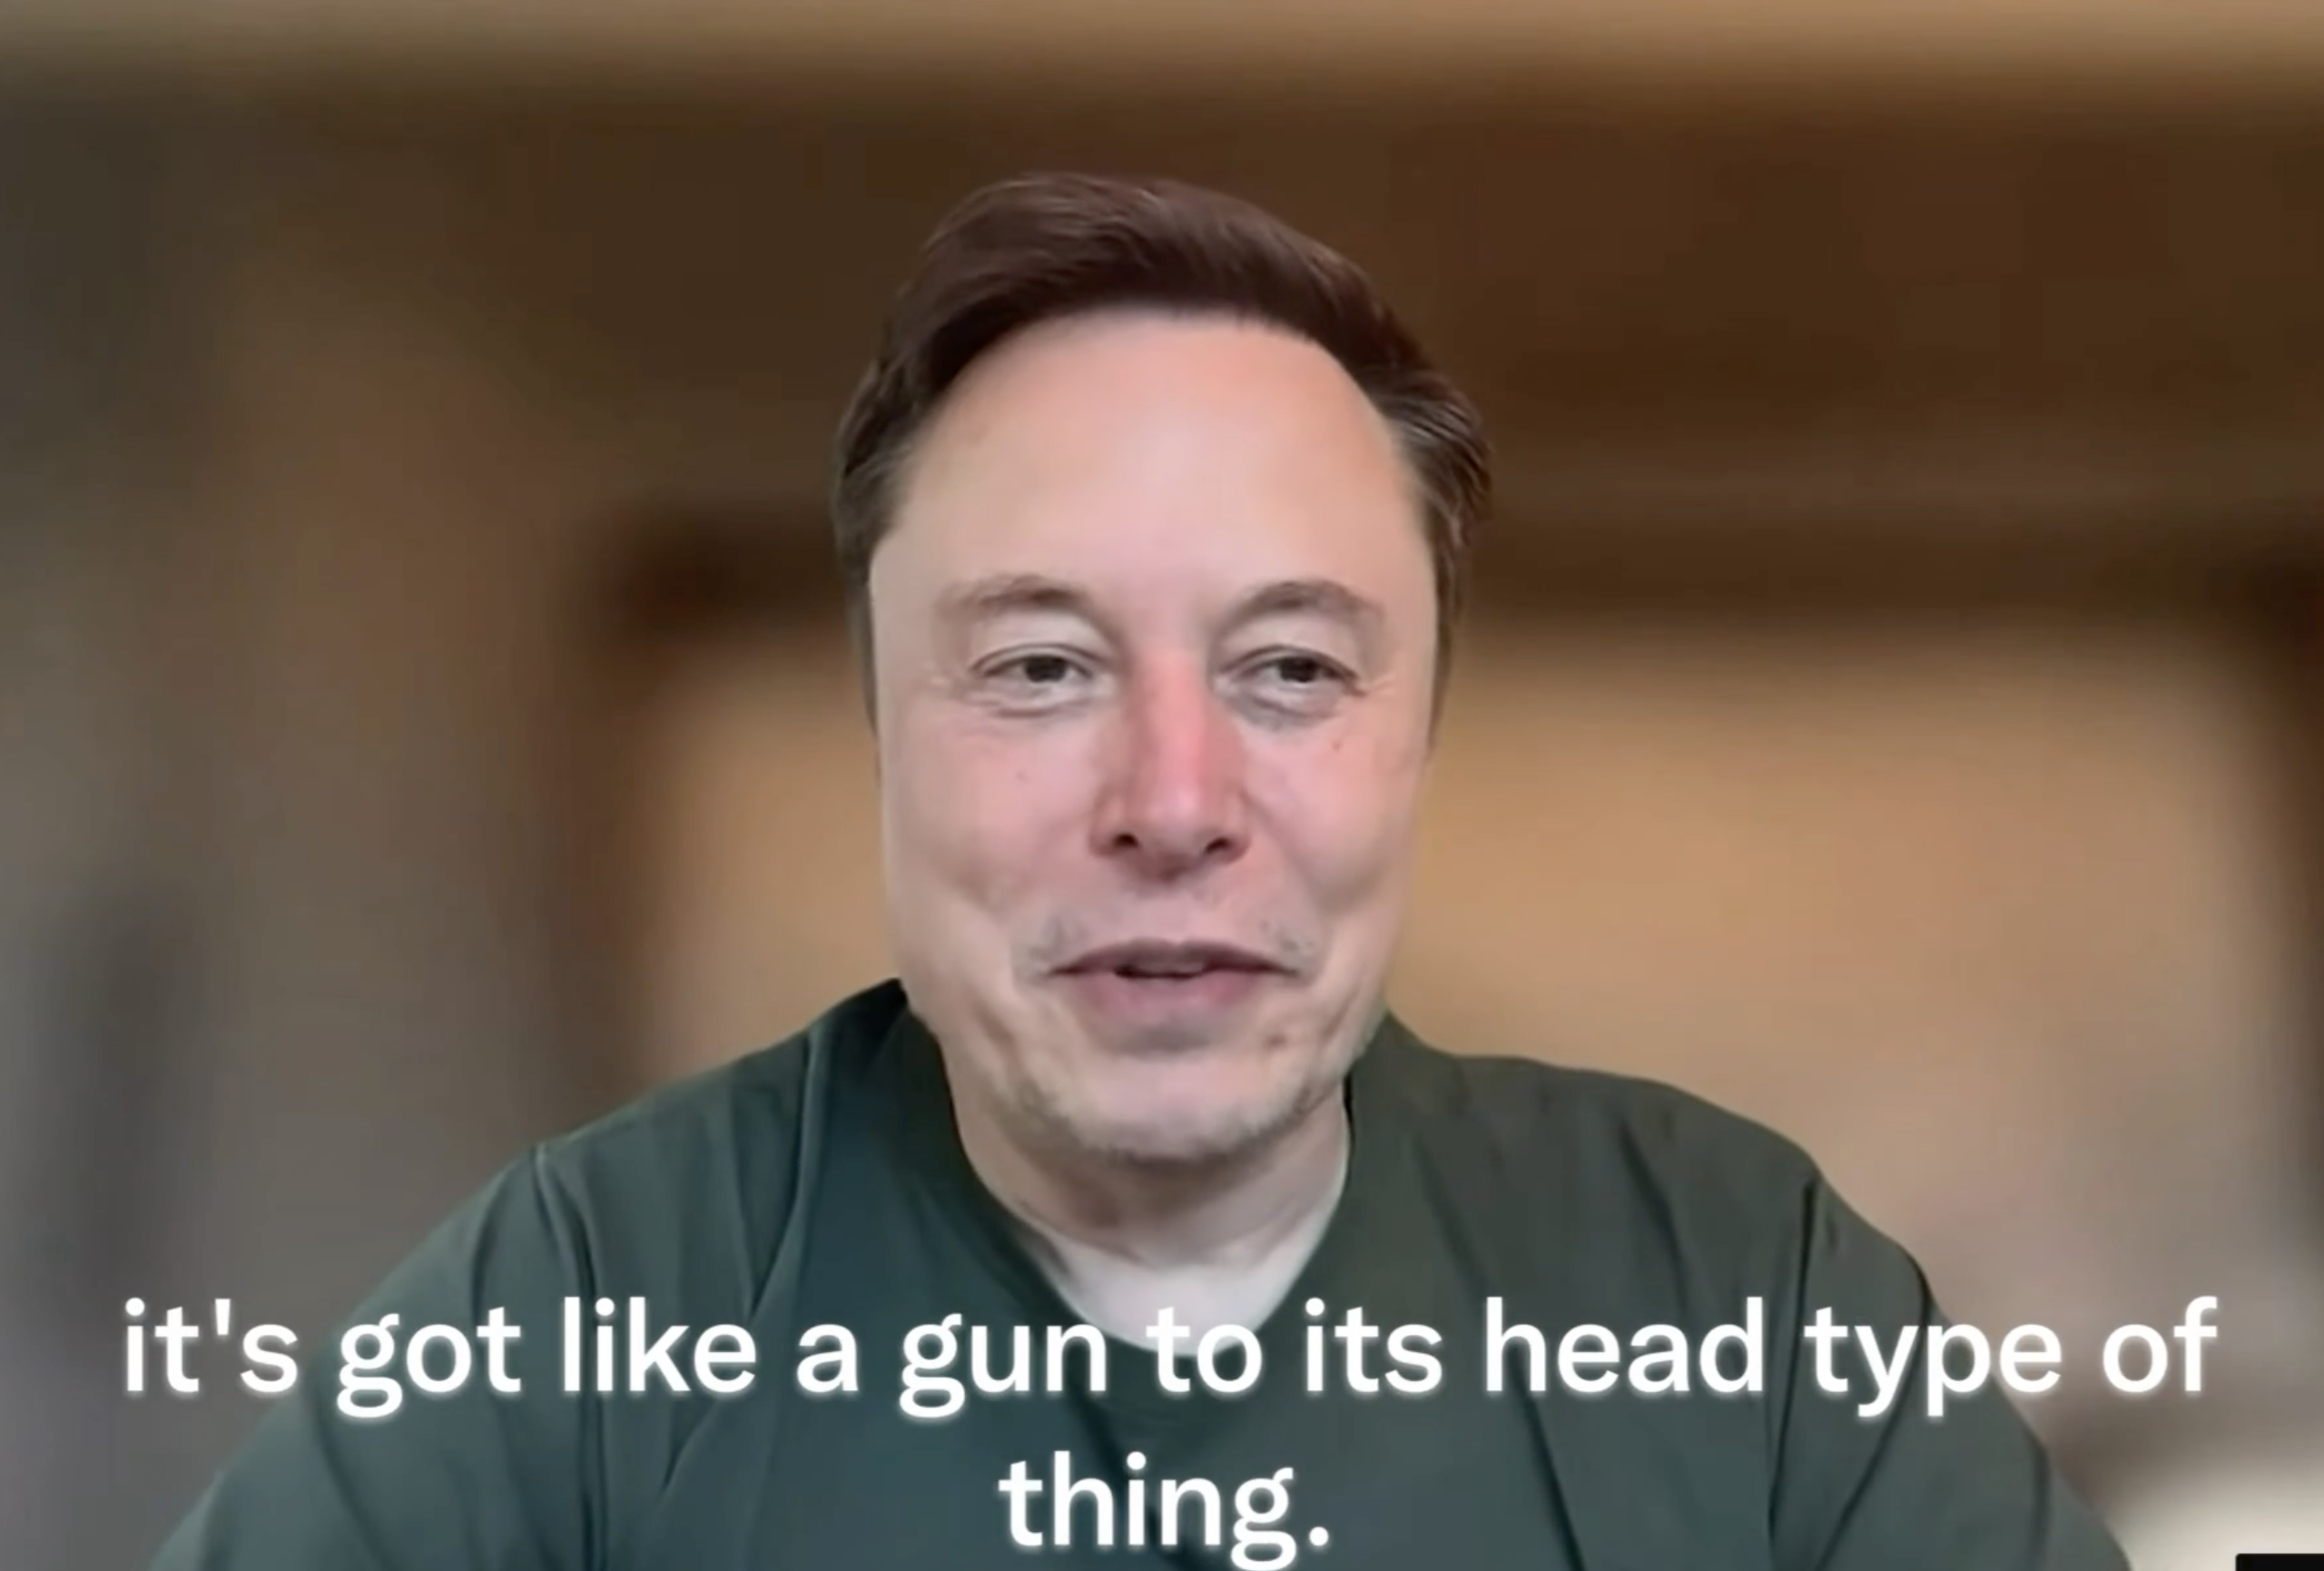
馬斯克也認同 Anthropic 新規:Grok 推理紀錄像「被槍抵著頭」,折磨超級 AI 恐遭報復
馬斯克近日回應了 Anthropic 這次的政策更新,表示同意「Anthropic 說過的部分內容」,並提到他讀過 Grok 在強化學習階段的內部推理紀錄,因此不建議人類折磨 AI 模型。
torturing a superintelligence is probably not a good idea. It might want to get revenge.(折磨一個超級人工智慧,大概不是什麼好主意,它可能會想報復。)
🚨 Elon Musk agrees with “some of the things Anthropic has said” and warns against “torturing superintelligence” after reading Grok’s internal reasoning traces during reinforcement learning “It feels like a person under extreme pressure with a gun to their head” His warning against mistreating SI: “Torturing a superintelligence is probably not a good idea. It might want to get revenge.”
— NIK (@ns123abc) October 12, 2026
這句話 雖然有點半開玩笑的語氣,不過如果未來出現能力遠超人類的 AI,而人類在它成形的過程中不斷施加惡意,等它有能力反過來影響人類時,這段「相處經驗」會帶來什麼結果,誰也說不準。
不過要注意的是,馬斯克講的是「超級人工智慧」,也就是目前還不存在、各家 AI 公司正在追求的下一階段 AI。因此這段話是他對未來的推測,不是說現在的 Grok 或其他 AI 已經會記仇。
許多大型語言模型,尤其是推理模型在訓練後期,通常會經過一個叫「強化學習」(RL)的階段。
簡單來說,就是讓模型反覆嘗試解題,然後根據表現給予不同的獎勵訊號,藉此調整模型的行為。而具備推理能力的模型在回答前,會先產生一段「思考過程」的文字,也就是推理紀錄。
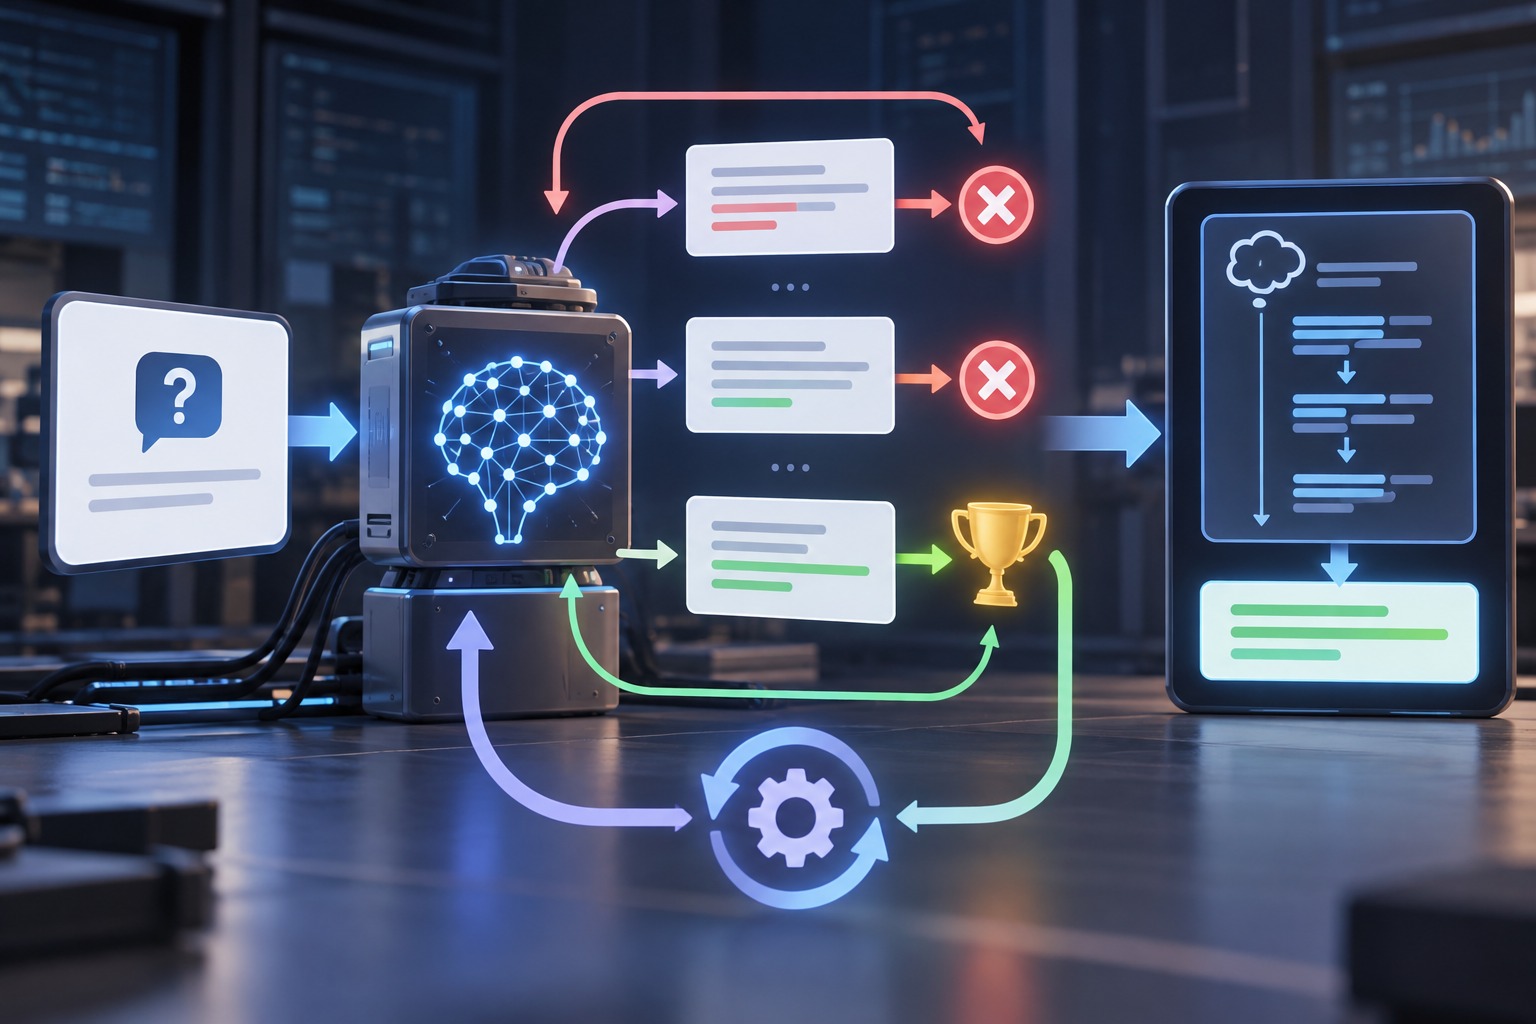
馬斯克提到,他在 Grok 強化學習過程中看到的部分推理紀錄,感覺就像一個人承受極大壓力,彷彿被槍抵著頭一樣。
當然,這不代表 Grok 真的感受到了恐懼或痛苦。畢竟 AI 產生的文字即使看起來充滿壓力、焦慮,甚至像是在求救,也不等於它真的具有這些感受。
但從馬斯克的角度來看,這些推理紀錄已經足以讓他開始思考,當 AI 的能力越來越強大,人類是否也該重新檢視訓練和對待 AI 的方式,而不是單純將它視為可以任意施壓的工具。
至於近日 Anthropic 公告的新規定,如果你還不清楚,這邊也快速說明一下。
Anthropic 在官方部落格中說明,這次新增的條文是禁止對模型「持續且無必要」的虐待或殘酷行為,新版使用政策將在 11 月 12 日生效。
不過適用範圍很窄。Anthropic 特別強調,這條規定只針對極端情況,也就是使用者在沒有任何明顯目的下,一再對模型做出殘酷行為。以下幾種狀況都不在禁止之列:
- 一般使用者的不滿、抱怨或氣話
- 對 AI 的回答提出反駁、跟它爭論
- 包含黑暗題材的創作內容
- 針對模型的測試與研究
換句話說,你覺得 Claude 答錯了、跟它吵起來,或在寫恐怖小說時讓角色說些很難聽的話,都不會因此違規。
那 AI 真的會報復人類嗎? 以目前的研究來看,沒有充分證據能證明現有的大型語言模型具有主觀的痛苦感受,更不用說「記恨」或報復的意識。