
一般來說,想在本地跑 1,200 億參數的大型語言模型,正規做法是要先準備好一張 80GB 的資料中心 GPU,或是買一台有 128GB 統一記憶體的 Mac Studio、AMD Ryzen AI Max+ 迷你電腦,少說也要十幾萬台幣,多數人都沒辦法做到。不過,最近國外有位網友沒有花錢買新硬體,就成功運行 OpenAI 的開放權重模型 gpt-oss-120b 模型,其方法是透過串聯家裡的手機、筆電、Mac mini。
當然,能運行不代表運行順暢,生成速度只有慘烈的每秒 1.1 個 token。
手機加五台電腦組成 AI 叢集!gpt-oss-120b 跑得動、每秒只有 1.1 個 token
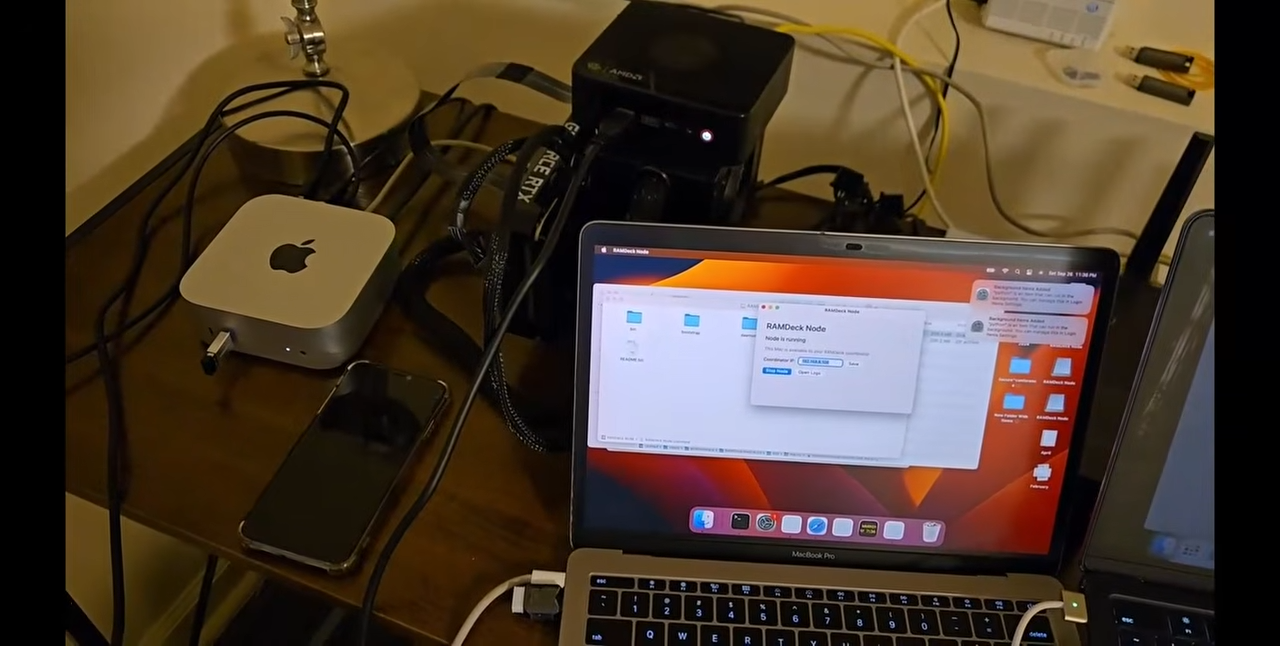
近日在 Reddit 的 r/LocalLLM 版上,有位 Medicine_Blogscanner 的網友分享 4-bit 量化版 gpt-oss-120b 拆到六台消費級裝置上執行的方式,記憶體用量壓到 47GB,生成速度是每秒 1.1 個 token。
根據這位網友的原文,這六台裝置分別是:一台 12GB 記憶體的 Windows 筆電、一台搭載 RTX 3060(12GB 顯示記憶體)的迷你電腦、一台 16GB 的 Mac mini、一台 16GB 的 M3 MacBook、一台只能用 CPU 運算的 2017 年 Intel MacBook,以及他的 Android 手機。手機是 Galaxy S24+。六台裝置有一半接有線網路,另一半連 Wi-Fi。
他還寫到:
老實說,我真的沒想到這會成功。這幾台機器沒有一台能自己載入 120B 的模型,差得遠了。所以我乾脆把它們全部丟進一個叢集裡,硬試看看。
Ran a 120B model across 6 computing devices that had no business running it!
byu/Medicine_Blogscanner inLocalLLM
而整個設置過程大概是這樣。他把 RTX 3060 的迷你電腦設成主控機,接下來就讓 RAMDeck 軟體自己分配。主控機先把自己裝得下的部分留在本機,再依照其他裝置的實際能力,把模型一塊一塊分出去。
分配順序是 GPU 先填滿,接著是兩台用 Apple 自家 GPU 介面 Metal 加速的 Mac,然後才輪到只能用 CPU 運算的裝置,最後手機也分到一小塊。有趣的是,六台裝置裡,其實只有五台負責模型,2017 年的 Intel MacBook 什麼都沒分到,他也認同這種分配方式,因為這台 MacBook 實在是太老了。
從截圖可以看到,Tiny 一台就負責六成左右,而且它分到的 28.7GB 裡,只有 9.7GB 放在 RTX 3060 的顯示記憶體,另外 19GB 放在系統記憶體,由 CPU 負責計算。Windows 筆電分到 7.9GB,比 Mac mini 的 7.4GB 還多。M3 MacBook 分到 2GB,Galaxy S24+ 只分到 1.19GB:
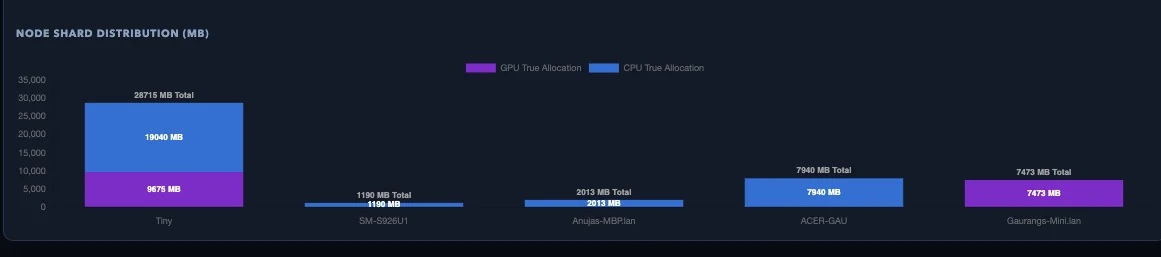
截圖看不清楚的話,可以參考下方表格:
| 節點名稱(推測對應裝置) | GPU 分配 | CPU 分配 | 合計 | 佔全體比例 |
|---|---|---|---|---|
| Tiny(RTX 3060 迷你電腦,主控機) | 9,675MB | 19,040MB | 28,715MB | 約 61% |
| ACER-GAU(12GB Windows 筆電) | — | 7,940MB | 7,940MB | 約 17% |
| Gaurangs-Mini(16GB Mac mini) | 7,473MB | — | 7,473MB | 約 16% |
| Anujas-MBP(16GB M3 MacBook) | — | 2,013MB | 2,013MB | 約 4% |
| SM-S926U1(Galaxy S24+) | — | 1,190MB | 1,190MB | 約 2.5% |
| 2017 Intel MacBook | — | — | 未分配 | 0% |
| 合計 | 17,148MB | 30,183MB | 47,331MB | 100% |
雖然成功運行 gpt-oss-120b,但載入過程並不順暢。完整載入花了大約 11 分鐘,大部分時間都在等模型的分塊,透過 Wi-Fi 慢慢傳到比較慢的裝置上。他試了三次才成功,因為程式裡有寫死 10 分鐘的逾時限制,因此還沒載完就被中斷。
他在貼文裡也給了其他人一個建議:載入逾時的時間要跟著模型大小調整,不要寫死。
最終測出速度為 1.1 tok/s,有些人可能對這數字沒什麼概念。
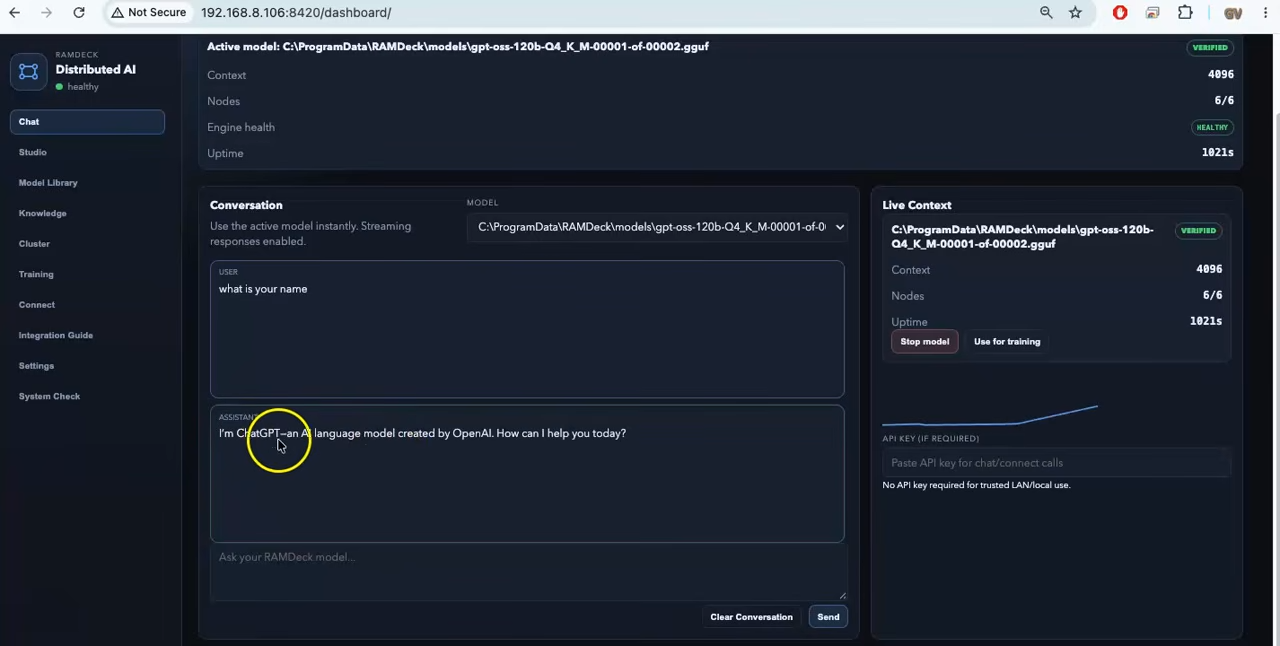
Token 是語言模型處理文字的基本單位,以英文來說,平均 1 個 token 大約相當於 0.75 個英文單字,換句話說,20 個英文單字通常會是 25~30 個 token 左右。以每秒 1.1 token 的生成速度來看,一句約 20 個英文單字的內容可能就要等 20 多秒才會完整出現。如果請它產生 500 個 token 的長回覆,則大概要等 7 分 35 秒,而且這還沒算模型處理輸入提示詞所花的時間。
會這麼慢也正常,每生成一個 token,資料都需要在區域網路上依序經過每一台裝置,算完才能開始下一個,因此速度會被最慢的那個裝置卡住。
他也把整個過程錄成影片放上 YouTube: