
隨著 Gemini 3.8 Flash 推出後,不意外地,Google 也開始陸續更新旗下各種 AI 模型。稍早正式發表新一代文字轉語音模型 Gemini 3.8 Flash TTS 與 Gemini 3.8 Flash-Lite TTS,距離上一代 Gemini 3.1 Flash TTS 推出大約只有 5 個月。除了進一步提升文字轉語音的自然度與控制能力之外,這次還加入多項新功能,像是只要提供約 30 秒錄音,就能複製指定人聲。在 Hume AI 的 Voice Design 語音設計評測中拿下 71.4 分,暫居排名第一。
Google 推出 Gemini 3.8 Flash TTS 與 Flash-Lite TTS:用一句話設計全新聲音、30 秒就能複製人聲
Google 稍早在官方部落格發表 Gemini 3.8 Flash TTS 與 Gemini 3.8 Flash-Lite TTS,這次的升級可以分成兩大方向:一是「做出聲音」,不再只能從預設聲音裡挑,而是可以自己設計、複製、保存;二是「指揮聲音」,每一句話要用什麼語氣、什麼節奏念,都可以像導演一樣下指示。
「做出聲音」部分主要包括聲音設計與聲音複製,其中聲音複製功能 Gemini 3.8 Flash TTS 與 Gemini 3.8 Flash-Lite TTS 都支援。
你可以用自然語言描述角色、口音和聲音特徵,模型會從零生成出一個全新的聲音,支援 100 多種語言和方言。不想自己設計的話,也能直接使用現成的聲音庫。這次聲音庫從原本的 30 種擴大到 2,000 多種,還包括墨西哥西班牙語、魁北克法語、蘇格蘭英語這類地區口音。
也能「複製人聲」,你只要提供 30 秒的錄音,就能複製出一個穩定的聲音,可以是你自己的聲音,或是你有權使用的聲音。為了避免被拿去冒用別人的聲音,Google 有加一道同意驗證,使用者必須另外上傳一段聲音主人親口表示同意的錄音,系統確認這段錄音跟參考錄音是同一個人之後,才會建立這個聲音。
設計或複製好的聲音可以儲存下來管理。根據 Gemini API 的開發文件,這類自訂聲音每個專案最多可以存 200 個,保存期限是 1 年。
另外 Google 還提到一個「即將推出」的聲音混音功能,你可以從聲音庫挑一個聲音,再用提示詞微調音色、音高、語速和口音,例如「加一點美國南方口音」或「講得溫柔一點」。
「指揮聲音」就 Gemini 3.8 Flash TTS 與 Gemini 3.8 Flash-Lite TTS 都支援。
你可以替每一句台詞寫舞台指示,或是讓 Gemini 自己依照劇本判斷該怎麼念,從冷靜的客服語氣到壓低聲音的懸疑場景都可以。3.1 靠的是 200 多種音訊標籤,這次的方向更接近「直接寫一段表演指導提示詞」,控制起來更自然。
Google 也提到,新模型可以連續生成好幾個小時的音訊,而且音質、節奏和角色的音色都能維持一致,很少出現講者聲音漂移的狀況,很適合 Podcast 和有聲書。做過 AI 有聲書的人應該知道,有時候唸到後半段,同一個角色聽起來好像換了個人。
也原生支援雙人對話,一份腳本就能做出多輪的兩人對話,而且兩個聲音會分得很清楚,換人講話的節奏也很自然。
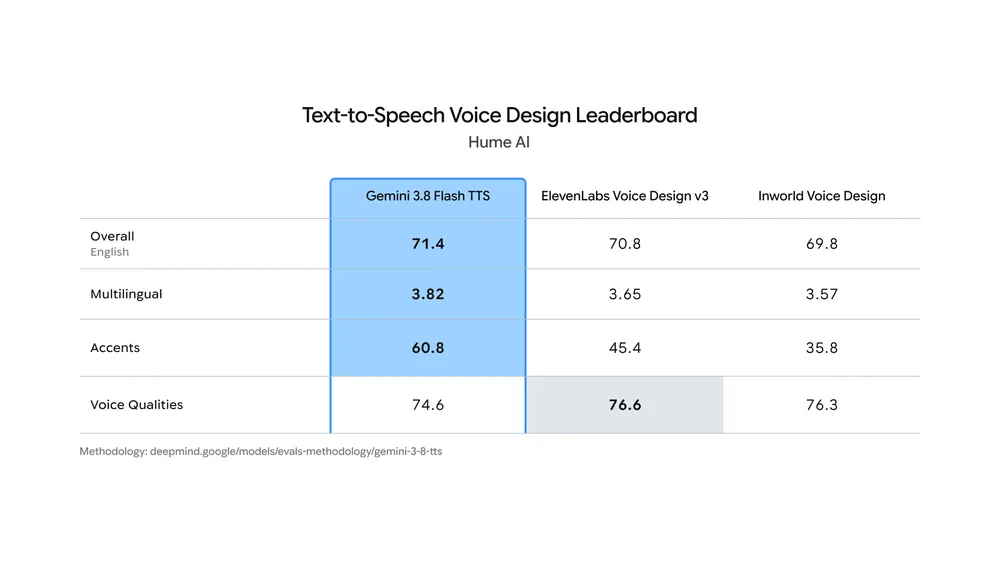
測試數據方面,Hume AI 聲音設計排行榜跟 ElevenLabs Voice Design v3 和 Inworld Voice Design 比較。
英文總分 Gemini 3.8 Flash TTS 拿到 71.4 分,ElevenLabs 是 70.8 分、Inworld 是 69.8 分,三家其實很接近。差距最大的是口音:Gemini 60.8 分,ElevenLabs 只有 45.4 分、Inworld 35.8 分,也就是說,要它生出「墨爾本腔」「蘇格蘭腔」這種指定口音,Gemini 明顯比較準。多語言項目 Gemini 同樣小幅領先(3.82 對 3.65):
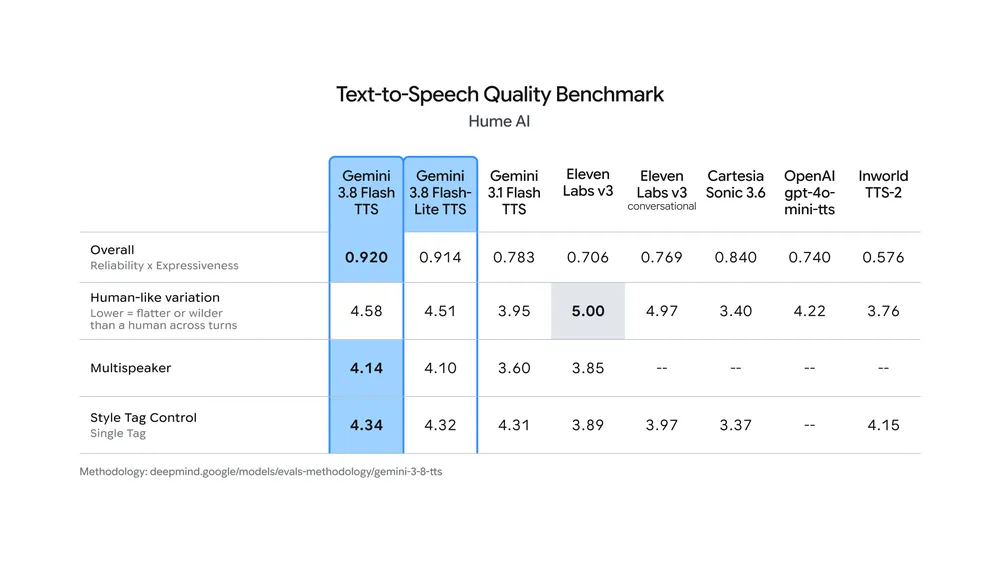
Hume AI 的品質評測中,Gemini 3.8 Flash TTS 總分是 0.920、Flash-Lite TTS 是 0.914,前一代 Gemini 3.1 Flash TTS 只有 0.783,進步幅度很明顯。也領先所有對手。多人對話和風格標籤控制也都是 Gemini 3.8 Flash TTS 第一。唯一輸掉的是「Human-like variation」,這項主要評估不同語音輸出之間的變化是否接近真人說話時的自然變化,ElevenLabs v3 拿到滿分 5.00,Gemini 是 4.58:
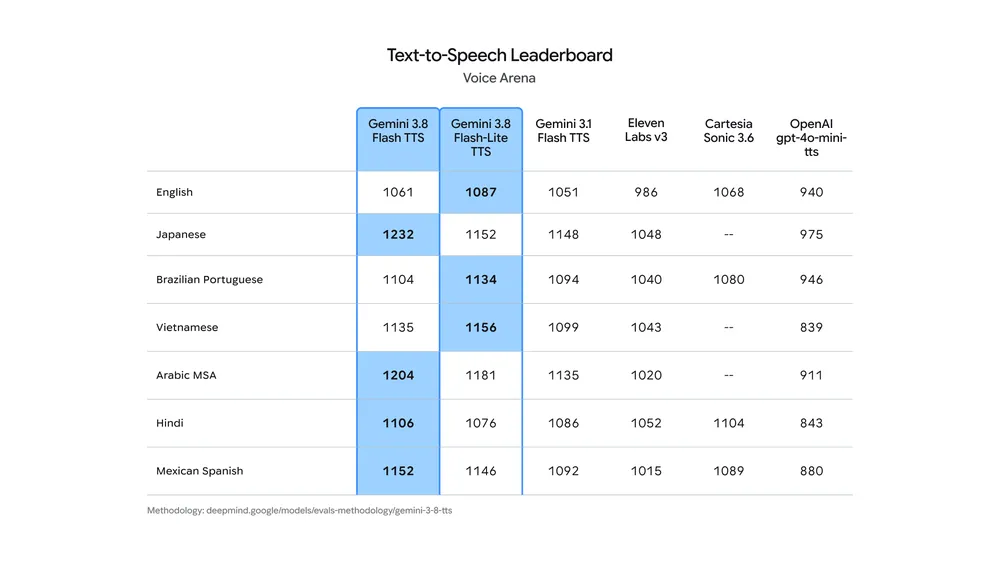
Voice Arena 的真人盲測中,日語的成績最亮眼,Gemini 3.8 Flash TTS 拿到 1,232 分,前一代 3.1 是 1,148、ElevenLabs v3 是 1,048。阿拉伯語也有 1,204 分。比較有趣的是,英語、巴西葡萄牙語、越南語反而是便宜的 Flash-Lite 拿最高分:
安全性除了前面提到的同意驗證,Gemini Audio 模型生成的每一段音訊都會嵌入 Google 的 SynthID 浮水印。這種浮水印人耳聽不出來,但可以用來辨識這段聲音是不是 AI 生成的。聲音複製功能另外也支援 C2PA 內容憑證。
Gemini 3.8 Flash TTS 從今天開始陸續上線:開發者可以在 Gemini API 和 Google AI Studio 使用,一般使用者也能在 Gemini Notebook 體驗到。
API 價格方面,兩款模型到 2026 年 12 月 31 日前都有優惠價,2027 年 1 月 1 日起,文字輸入、音訊輸出與批次處理價格都會調回原價。:
| 模型(每百萬 Token) | 文字輸入 | 音訊輸出 | 批次處理輸出 | 2027 年起音訊輸出 |
|---|---|---|---|---|
| Gemini 3.8 Flash TTS | 0.5 美元 | 9 美元 | 4.5 美元 | 18 美元 |
| Gemini 3.8 Flash-Lite TTS | 0.5 美元 | 6 美元 | 3 美元 | 12 美元 |
| Gemini 3.1 Flash TTS(預覽版) | 1 美元 | 20 美元 | 10 美元 | — |