蘋果 8 月發表搭載 M5 Ultra 的新款 Mac Studio,號稱本地 AI 效能最高提升 4.3 倍、儲存速度 2 倍、CPU 速度 1.3 倍,統一記憶體頻寬來到每秒 1.2TB。國外知名科技 YouTuber 亞歷克斯・齊斯金德(Alex Ziskind)把 M5 Ultra 與前代 M3 Ultra 並排正面對決,標題下的結論很直白:「Apple Wasn’t Messing Around」(蘋果沒在開玩笑)。他這次實測的是 M5 Ultra 滿配版本:80 核 GPU、256GB 統一記憶體(512GB 版本隔月開賣)、8TB SSD,整機售價 14,299 美元(約新台幣 46.5 萬元),M5 Ultra 版 Mac Studio 起價則為 5,499 美元(約新台幣 17.9 萬元)。他笑說這代「效能升級,價格也升級不少」,測試機由蘋果出借,對照組 M3 Ultra 則是自掏腰包購買。
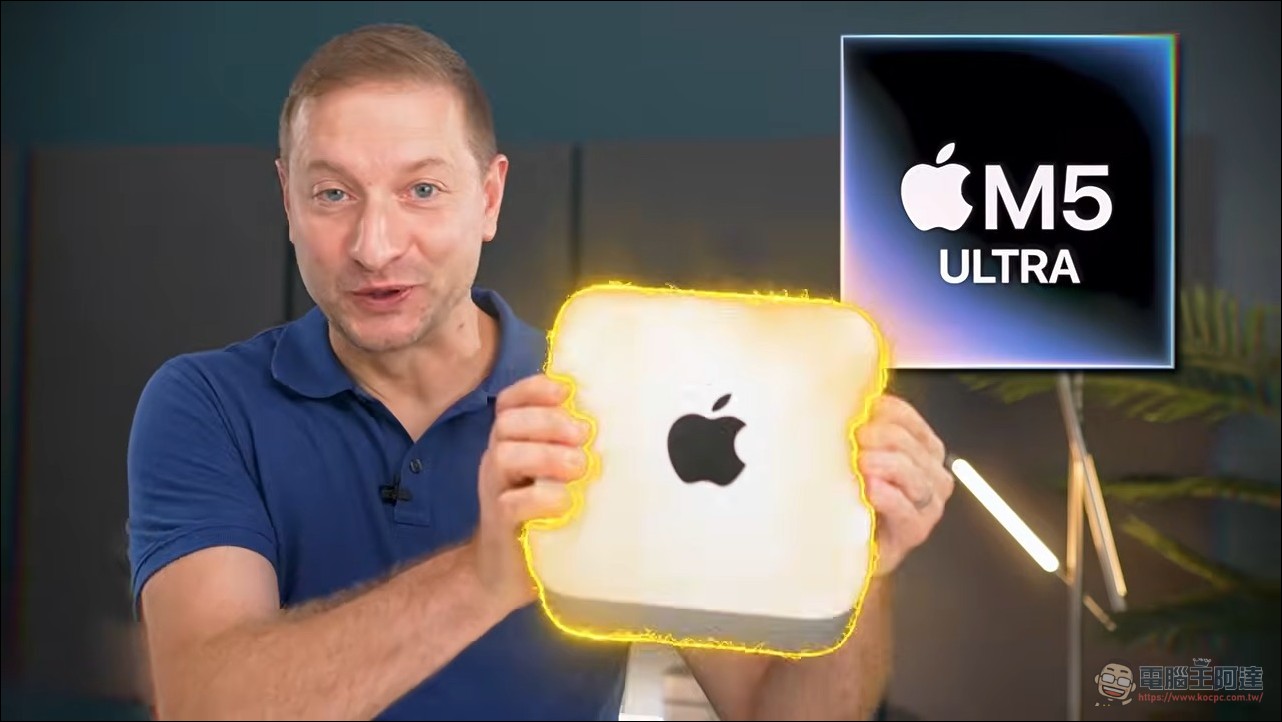
M5 Ultra AI 效能實測:本地 AI 性能提升幅度與宣傳文案相符
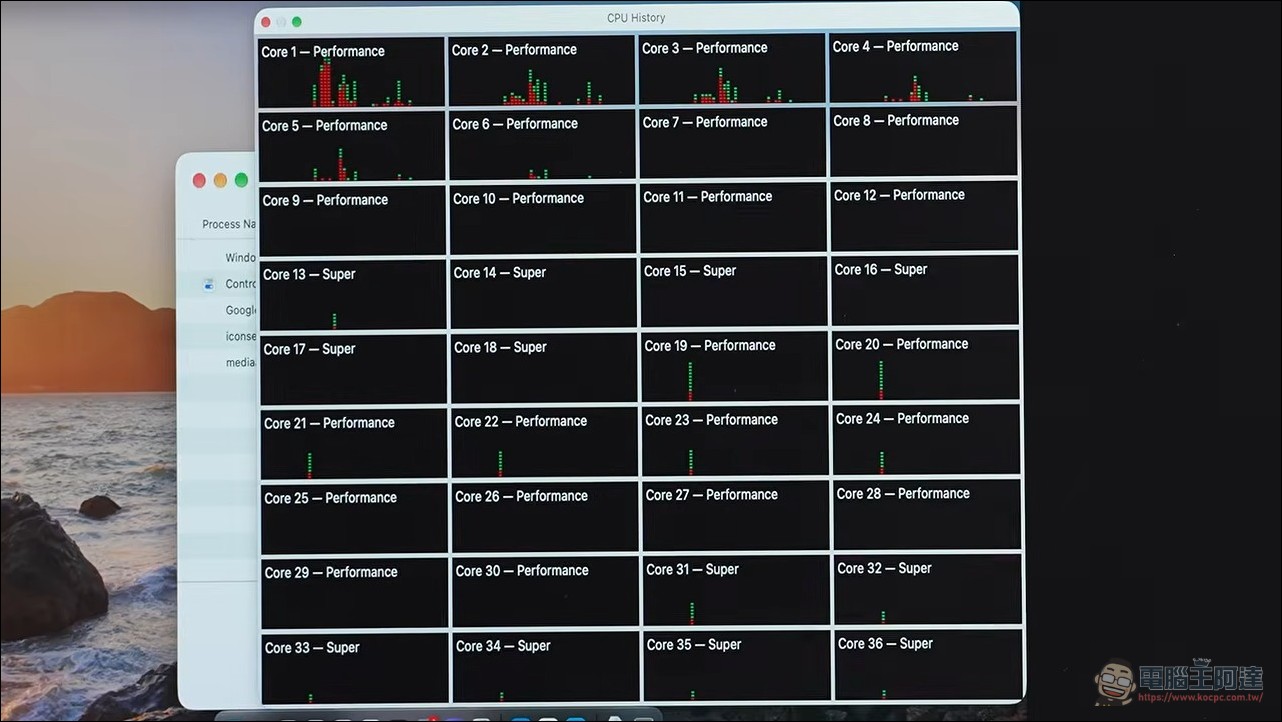
測試配置:36 核心、無能效核
M5 Ultra 的 CPU 共 36 核心,由 24 個效能核心與 12 個超級核心組成,Mac Studio 內完全沒有能效核心。為求公平,兩台機器跑的是同一版 llama.cpp 與 MLX 編譯、載入完全相同的模型檔。影像處理方面,M5 Ultra 的媒體引擎編解碼區塊是 M5 Max 的兩倍,官方宣稱可同時播放多達 33 條 8K ProRes 422 30fps 影片流。Geekbench 7 跑分也顯示,36 核 M5 Ultra 單核 3,774 分、多核 52,516 分,比 32 核 M3 Ultra 的平均值高出約 30% 與 35%,與官方「單執行緒 1.25 倍、多執行緒 1.3 倍」的說法大致吻合。
開發者工作負載:編譯與儲存起飛
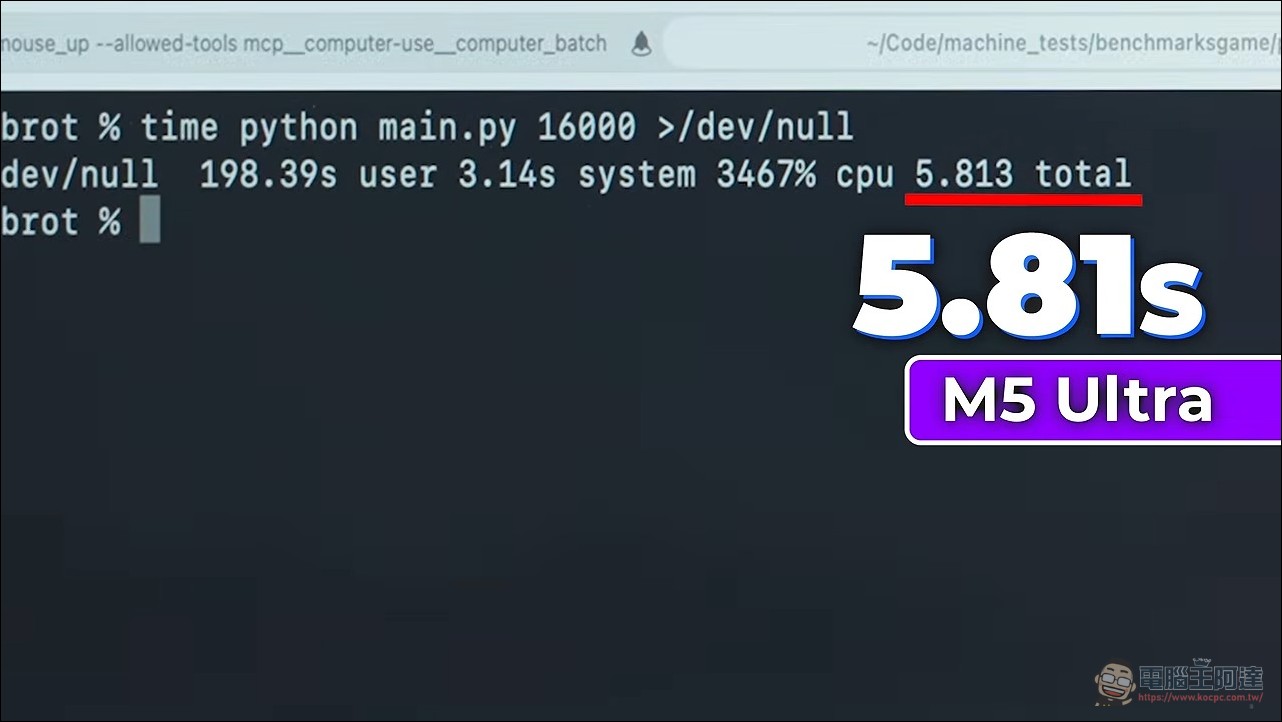
對開發者而言,這台機器「效能過剩」。Speedometer 網頁效能測試從 M3 Ultra 的 47 分來到 60.2 分。實際編譯測試更明顯:一個含 10 萬個命名空間與類別的大型 .NET 專案,編譯時間從 71.7 秒縮到 52.4 秒;純 Python 的曼德博(Mandelbrot)演算法測試從 10.25 秒縮到 5.8 秒,足足快兩倍,主持人直呼「從沒看過這麼快」。
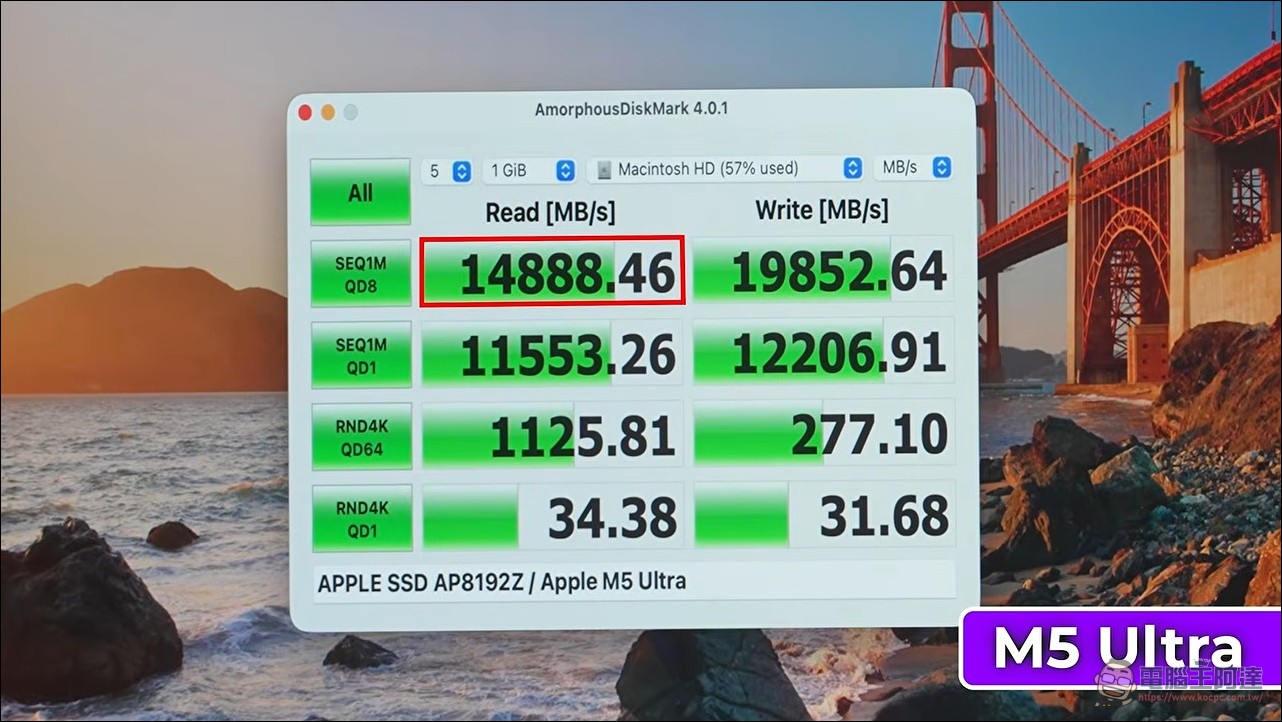
官方說儲存快 2 倍,實測還超過。AmorphousDiskMark 順序讀寫:M3 Ultra 讀 5930MB/s、寫 7788MB/s;M5 Ultra 讀 14,888MB/s、寫逼近 20,000MB/s。編譯更依賴的隨機讀寫同樣快兩倍以上,他的評語是「行銷部門標 2 倍的寫法太保守」。這對 AI 也有直接影響:載入一個 140GB 的模型檔時,讀取速度快上一大截。
本地 LLM 的兩個關鍵數字
測本地大模型只看兩個數字:提示處理(Prompt Processing,PP)與 token 生成(Token Generation,TG)。PP 是模型「讀」提示詞的過程,吃的是 GPU 算力;TG 是模型「寫」答案的過程,吃的是記憶體頻寬。
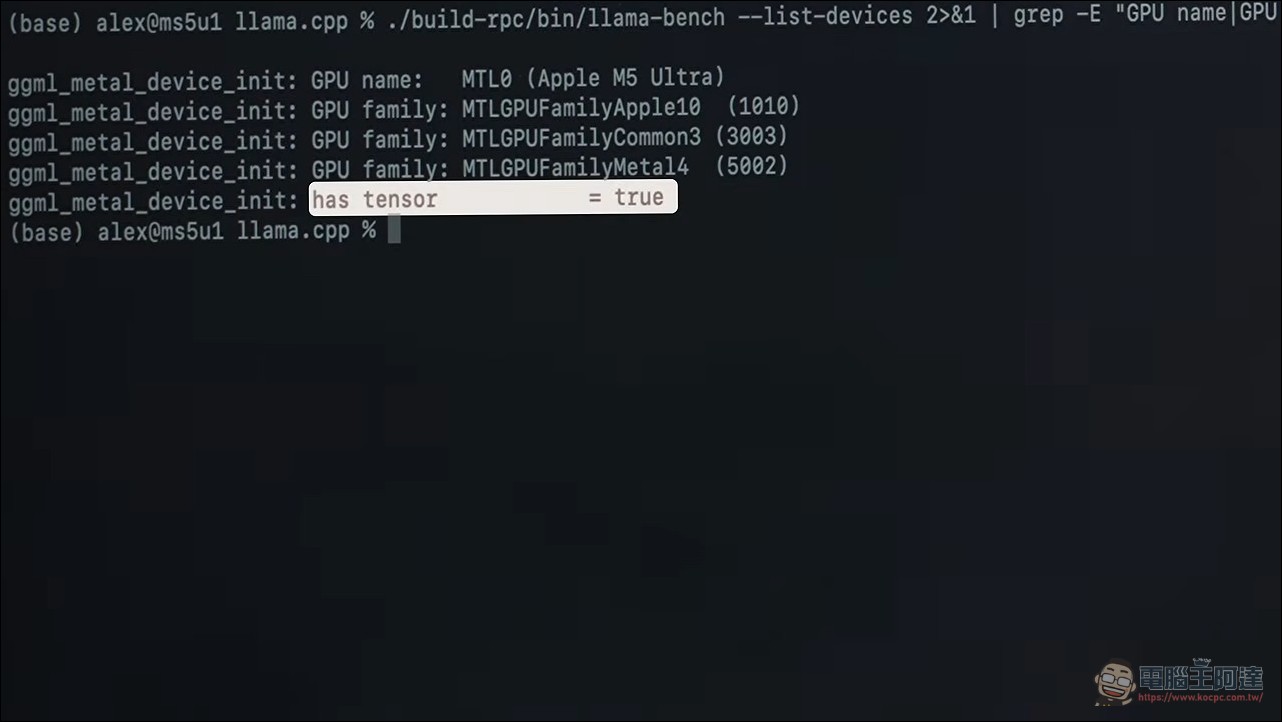
M5 Ultra 的架構升級正對症下藥:M3 世代的 GPU 核心只是普通顯示核心,M5 世代的每個 GPU 核心內建一顆神經加速器(Neural Accelerator),等於每顆核心都有一塊專用矩陣乘法 AI 硬體。llama.cpp 啟動時的「has tensor」旗標在 M3 Ultra 顯示 false、M5 Ultra 顯示 true,代表軟體已針對 M5 家族啟用神經加速器路徑。蘋果官方也強調這是神經加速器首次進入 Ultra 等級晶片,對比 M3 Ultra 最高可達 4.3 倍峰值 AI 運算。
記憶體頻寬實測:1.2TB/s 達陣約 86%
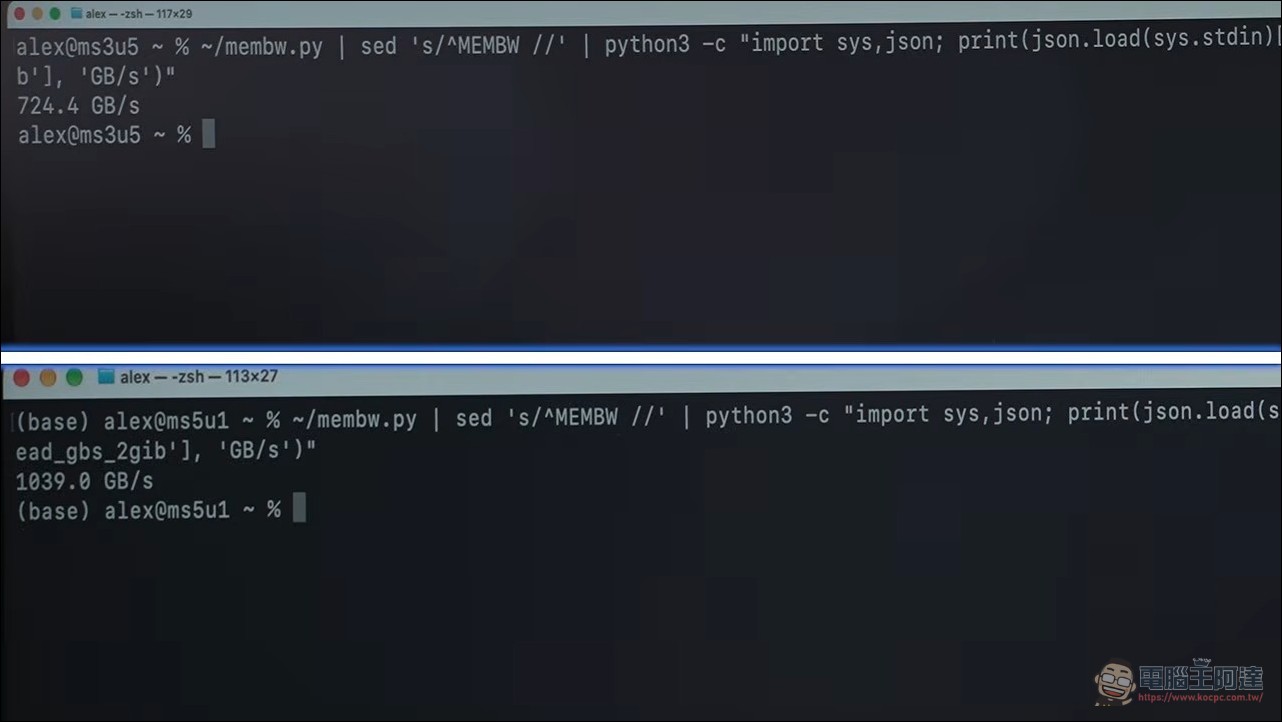
官方標稱 1.2TB/s。先跑老牌的 STREAM 基準測試(屬 CPU 端測試):M3 Ultra 312.9GB/s 對上 M5 Ultra 583.6GB/s。改用 GPU 端微基準測試(對 AI 才有意義):M3 Ultra 實測 724GB/s(官方標 819GB/s,達陣約九成),M5 Ultra 實測 1,039GB/s(官方標 1.2TB/s,達陣約 85% 到 86%),實測頻寬是 M3 Ultra 的 1.4 倍。
三種模型實測:MoE 與稠密模型都驗證
- DeepSeek V4 Flash(2,840 億參數,MoE):token 生成從 37 提升到 53 tokens/s(約 1.5 倍),與頻寬增幅一致;提示處理從 483 提升到 1,485 tokens/s(3 倍)。
- GPT-OSS 120B(1,200 億參數,MoE):token 生成 90 對 130 tokens/s;提示處理 1,300 對約 3,200 tokens/s。長上下文測試中,已在 6 萬 4,000 tokens 上下文的情況下再餵 3 萬 2,000 tokens,M3 Ultra 要 80 秒、M5 Ultra 只要 56 秒。
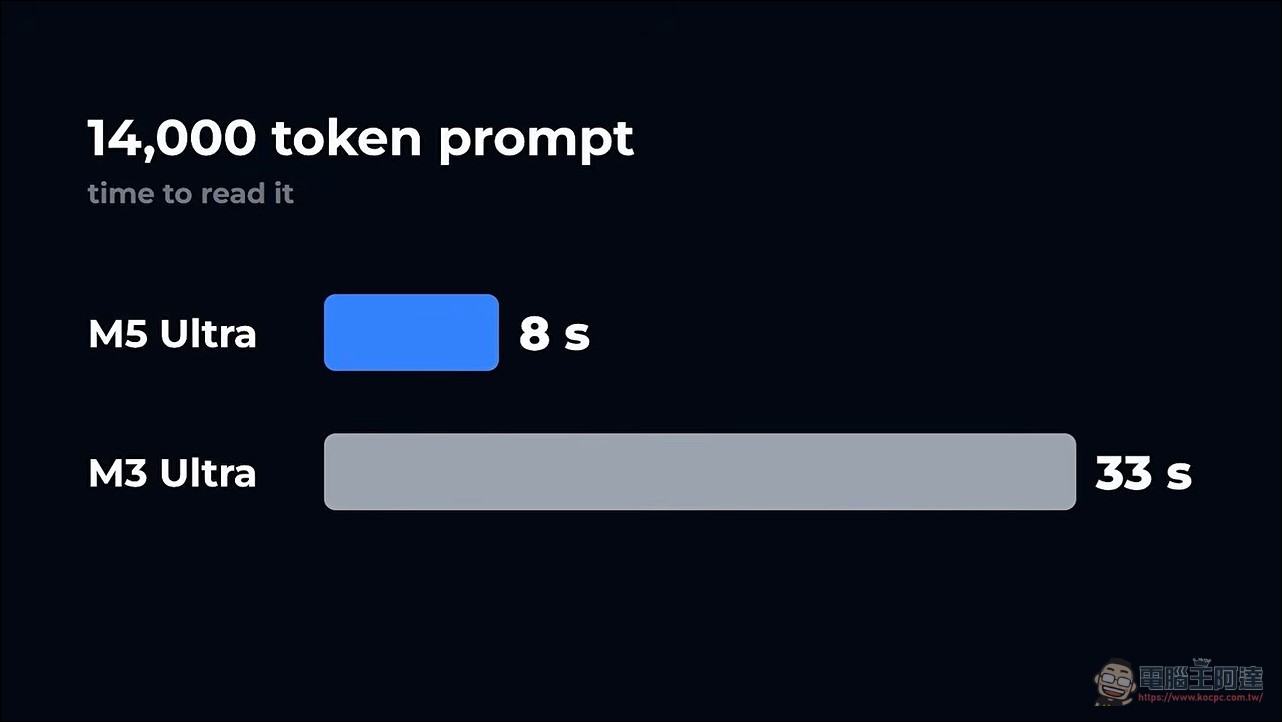
- Qwen 3 8.27B(稠密模型):token 生成 37 對 54 tokens/s(1.47 倍);提示處理 430 對 1,800 tokens/s,超過 4 倍。另以 1 萬 4,000 tokens 的真實程式碼檔案測試,提示處理從 33 秒縮到 8 秒,實測 4.2 倍,兌現官方「最高 4 倍」的承諾。
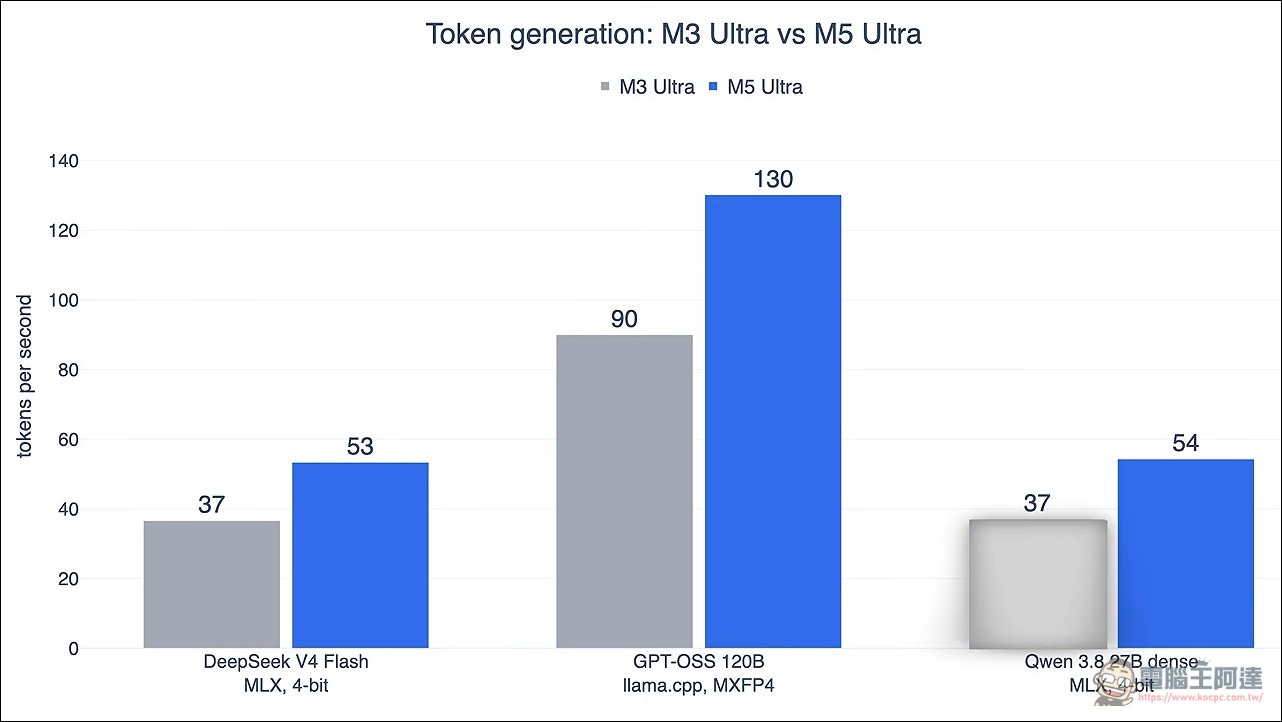
MoE(專家混合)與稠密模型的 token 生成都落在 1.4 到 1.5 倍,跟實測記憶體頻寬的 1.4 倍完全對上,驗證了 TG (token 生成)吃記憶體頻寬的理論。最大的世代差落在提示處理,這正是 M3、M4 世代一直的短板,神經加速器把它一次補到位。
四倍的前提與功耗代價
看到這先別急著刷卡,4 倍提示處理有前提:提示詞要夠長。要到約 14,000 tokens 才摸到 4 倍門檻;純聊天等級的 350 tokens 短提示只有 1.6 倍。「主要是聊天的用戶感受不大,但餵它幾個原始碼檔就會有感。」
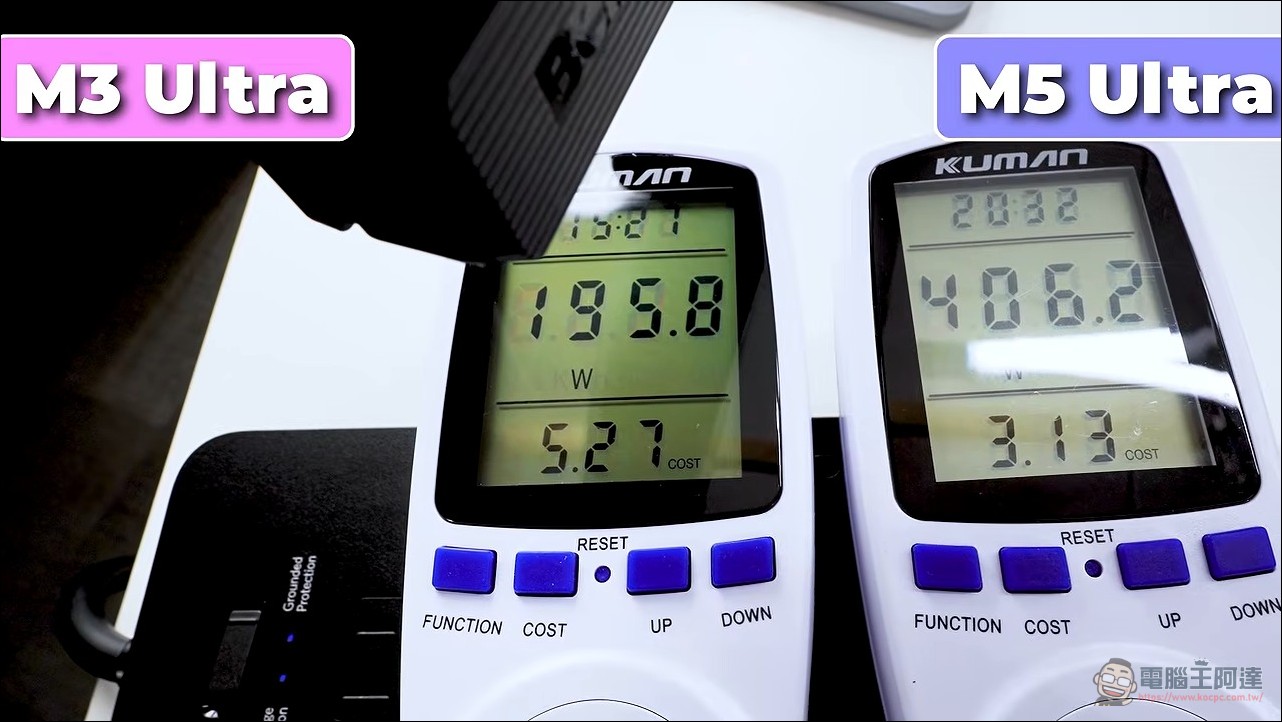
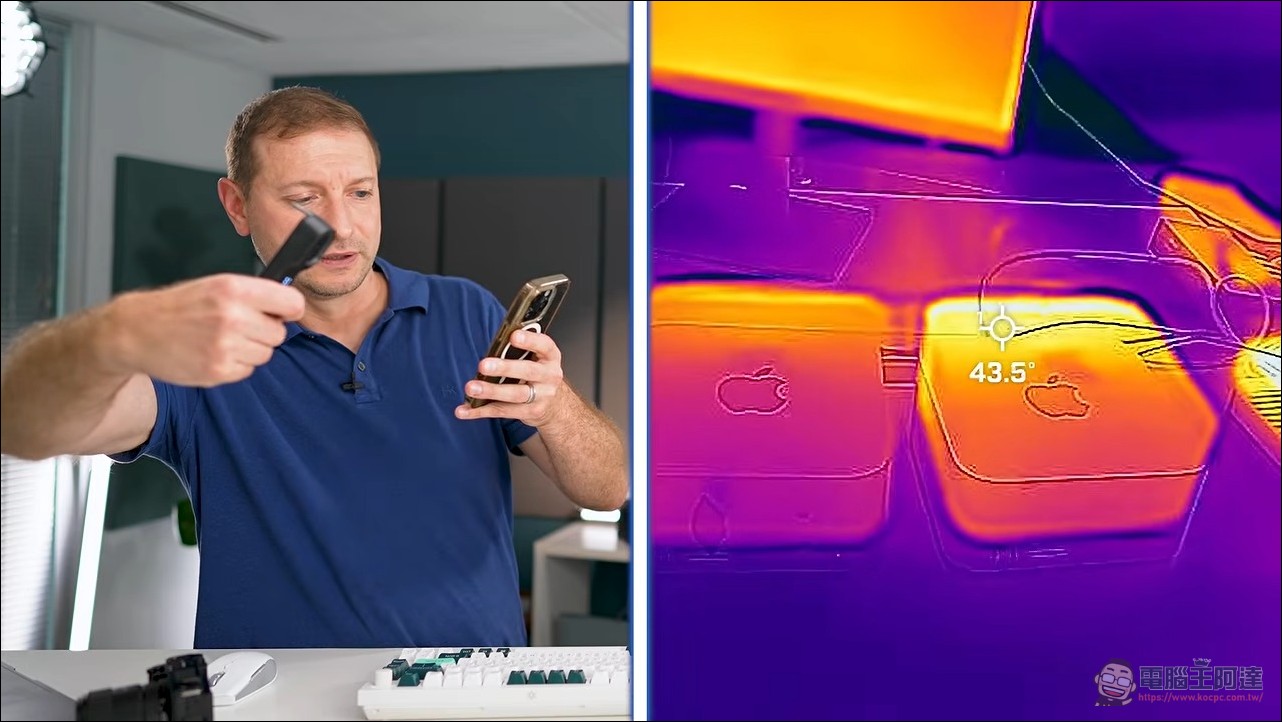
能效提升有限:生成期間晶片功耗約 45 瓦,M3 Ultra 為 36 瓦(均為 GPU 加 CPU,非插座功耗),每瓦 token 效率只提升約 12%。待機功耗倒是更低,M5 Ultra 約 8 到 10 瓦,M3 Ultra 為 11 到 12 瓦。但 GPU 滿載時差距懸殊:M3 Ultra 接近 200 瓦,M5 Ultra 超過 400 瓦,風扇聲明顯更大,機身溫度約 43、44 度,「比 M3 那代燙手不少」。
總結:token 生成 1.5 倍,提示處理 2 到 4 倍
主持人的結論:token 生成 1.5 倍是「不錯的升級」,提示處理 2 到 4 倍對程式碼代理(coding agent)用戶「絕對有感」。預告的多工測試中,同時處理 8 個請求時 M5 Ultra 輸出 134 tokens/s,M3 Ultra 為 75 tokens/s。他也預告後續將深入比較 MLX 與 llama.cpp、8-bit 模型,並用 512GB 機型與 Mac Studio 叢集測更大模型。
更多細節大家可以看影片內容,可以自行開啟 cc 字幕: