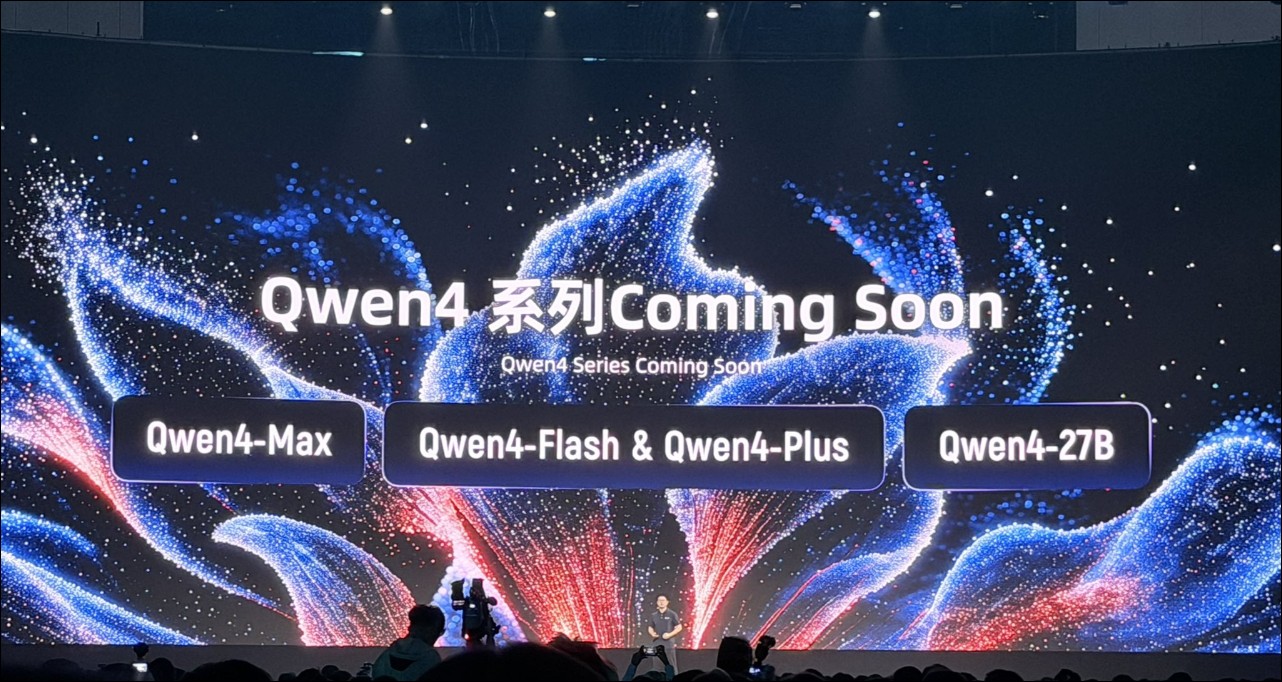
9 月 22 日,阿里巴巴 ATH 事業群 Token Foundry 的 Qwen LLM 項目負責人劉大一恒在中國 2026 雲棲大會登台演講,講題是《Qwen:邁向真實世界智能體》。但台上的大螢幕卻打出「Qwen4 系列 Coming Soon」,下方並列三個名字:Qwen4-Max、Qwen4-Flash & Qwen4-Plus、Qwen4-27B。這是 Qwen4 家族第一次公開露面。整場演講沒有宣布任何模型上線,Qwen4 目前仍在訓練階段,阿里端出來的是路線圖,並不是能下載的模型。
Max 攻能力上限,Flash 與 Plus 顧 CP 值,27B 留給本機
據至頂網在現場的報導,劉大一恒給出的 Qwen4 規劃分成三條線:以 Max 追求能力上限,以 Flash 和 Plus 兼顧效率與價格,另外提供面向本地部署的 27B 版本。
27B 出現在 Qwen4 名單裡,社群的反應最直接。X 上有人留言「有 27B 就行」,也有人追問上一代的 35B 是不是不做了。 這個尺寸會被期待,是因為 Qwen3.8-27B 在 9 月 16 日成為 Hugging Face 史上獲讚數最多的開源大模型,超越 FLUX.1、DeepSeek-R1、Kimi-K3 等熱門模型。
Qwen4 還在訓練,5 兆到 10 兆是 Qwen4.5 與 Qwen5 的目標
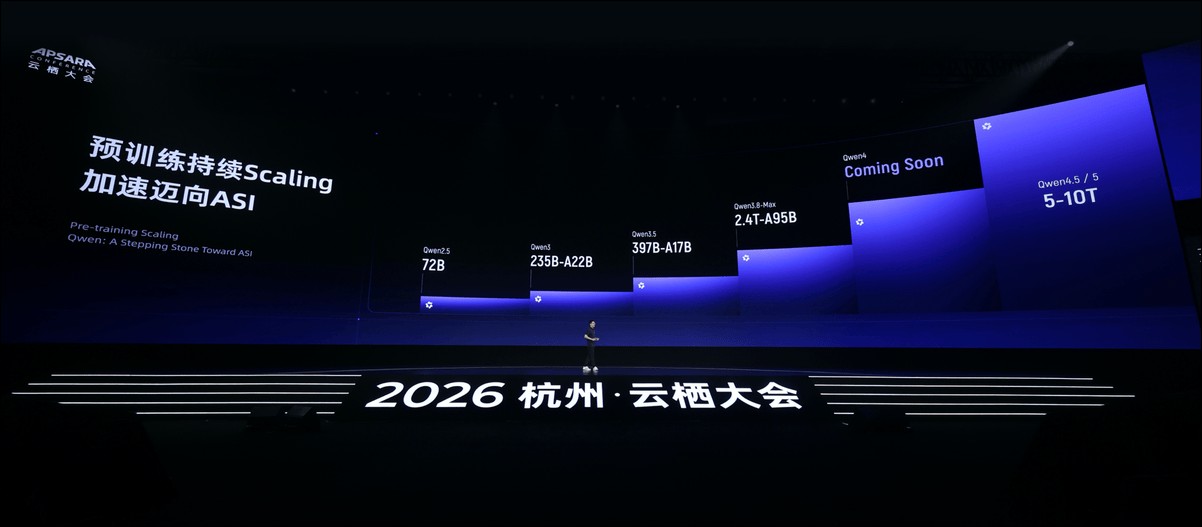
劉大一恒把 Scaling 稱為邁向 ASI 的路徑。他回顧 Qwen2.5 時代的旗艦規模是 72B,如今 Qwen3.8-Max 的總參數已達 2.4T,兩年間增加約 33 倍;基於新架構的 Qwen4 已投入訓練,後續 Qwen4.5、Qwen5 計畫把總參數量推向 5 兆至 10 兆。
劉大一恒 1993 年生,2020 年入選華為「天才少年計畫」,2021 年轉往阿里巴巴達摩院,主導 Qwen1 到 Qwen3.5 全系列的預訓練。今年 3 月前負責人林俊暘離職、周靖人轉任首席科學家之後,他接下 Qwen 的統籌工作,這次也是他第一次站上雲棲大會主論壇。
RSI 的對外實證,一個月跑完 33 輪
阿里在大會上把遞迴自我改進(Recursive Self-Improvement,RSI)的成果攤開來講。Qwen3.8-Max 已能在訓練流程裡自行搭建訓練步驟、構造訓練資料、設計實驗並定位缺陷,在人類完全沒有參與的情況下運作超過一個月,完成 33 輪有效迭代,Artificial Analysis 指數從 40 分升到 45 分,提升 12.5%。
同一套機制也被帶到推理與晶片設計。Qwen3.8-Max 在先前沒接觸過的平頭哥新款 GPU 上,自行調校下一代 Qwen3.8-Flash 的推理框架,單一實例的吞吐量提升 96%。在工業級 EDA 環境中,它只拿到一份真實的匯流排模組規格,自主執行超過 60 小時、調用工具逾萬次,最後把晶片面積縮減 42%、標準元件數量降低 29%、功耗降低 59.5%。
新架構先開源,Qwen3.8-Flash 訓練成本剩九分之一
Qwen 官方帳號早在 8 月 26 日就把 Qwen3.8-Flash 權重開源,並說明它屬於 Qwen4 架構的前導版本:125B 參數外加 51B N-gram 嵌入,每個 token 只激活約 6B,訓練成本約為 Qwen3.7-Plus 的九分之一,原生 262K 上下文,可透過 YaRN 延伸至 1M。
⚡Meet Qwen3.8-Flash, a multimodal MoE and an early preview of the Qwen4 architecture, now open-weight!
The production version Qwen3.8-Flash will be available soon via QwenCloud API at just $ 0.16/1M input tokens and $ 0.47/1M output tokens.
125B parameters + 51B N-gram… pic.twitter.com/SScnmzWS7O
— Qwen (@Alibaba_Qwen) August 26, 2026
價格也一併公布。正式版在 QwenCloud API 上線後,每百萬 input token 收 0.16 美元(約 NT$5.2),每百萬 output token 收 0.47 美元(約 NT$15.3)。阿里同時交出開源成績單:已開源 460 多個 Qwen 模型,累計下載超過 30 億次,社群衍生的模型超過 30 萬個。 大會上另公布,光是最近一個月,Qwen3.8 相關模型的下載量就超過 5,600 萬次,衍生模型超過 1,900 個。
全模態、語音與影片模型同步更新
Qwen4 之外,阿里在同一場大會上更新了其他模態的模型。全模態模型 Qwen3.8-Omni 把影片、音訊、圖片與文字納入同一套理解框架,阿里稱整體成本較上一代降低 90% 以上,現場展示的應用包括從長片素材自動剪出成片,以及依一句話為音樂生成 MV。
語音家族 Qwen-Audio-3.1 分成語音轉寫、語音合成與即時互動三條產品線,另有基於新架構的 Qwen-Audio-3.1-ASR-Next 與 TTS-Next 兩款新模型;同傳模型 Qwen3.8-LiveTranslate 首次登場,字均延遲從 2.8 秒降到 2.3 秒,而人類同傳的平均延遲在 4 秒以上。影片生成方面,Wan3.0 支援單次生成 30 秒影片,在 Artificial Analysis 的文生影片與影片編輯兩個榜單都排第一。阿里巴巴 ATH 技術副總裁鄭波在現場說,三年內會出現一個原生全模態統一模型,體驗不再受模態邊界限制。
結語
把 27B 放進 Qwen4 家族,說明阿里的開源路線沒有收手;把 5 兆到 10 兆參數寫進時程,也讓下一代模型的訓練成本問題更早浮上檯面。接下來要盯 Qwen4-27B 開出什麼授權條件,以及本機硬體門檻落在哪裡,這決定它能不能複製 Qwen3.8-27B 在社群帶起的本機部署熱度。