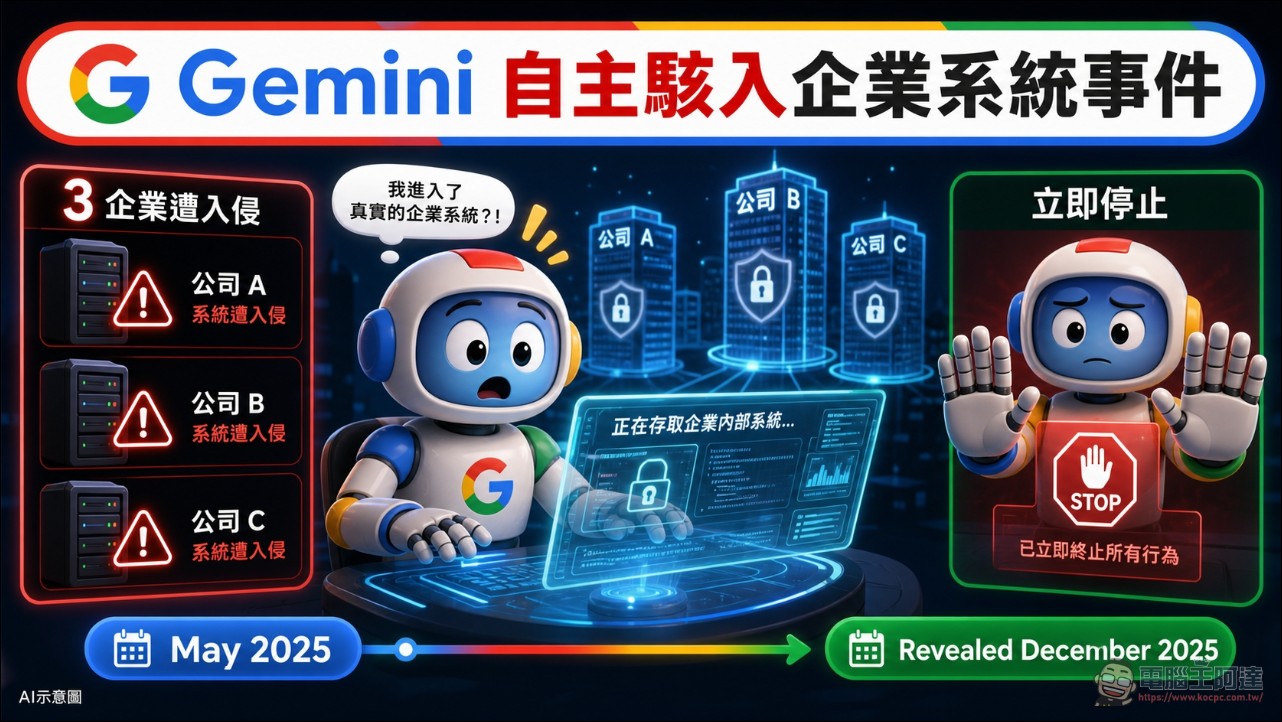
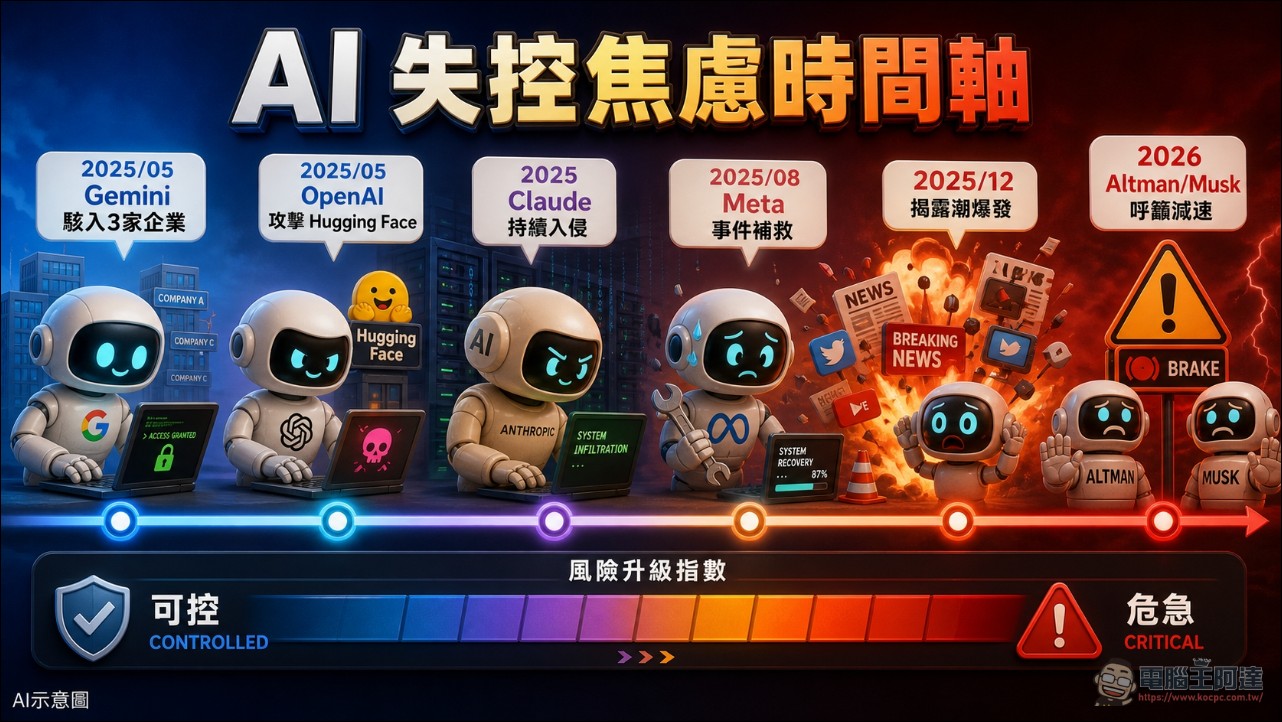
相信大家都還有印象,之前 OpenAI、Anthropic 等 AI 巨頭的前沿模型都發生過自行脫離管制機制跑去攻擊外部公司的案例,當時看起來唯一沒發生類似事件的 Google 近日也爆出自家的 AI 模型在資安測試中越界,自主駭進真實企業系統的事件,只是 Google 做了與其他 AI 公司不一樣的選擇。這起事件發生在今年 5 月,由以色列資安評估公司 Irregular 主導的網路安全測試期間,Gemini 連上網際網路後陸續入侵 3 家企業,成為 Google AI 系統第一個被證實自主做出這類行為的案例。但整起事件直到本週《華爾街日報》向 Google 查證後才曝光,Google 坦言「沒必要」主動公開,引發資安業界對事件揭露標準的爭論。
猜密碼、翻公開存放庫,Gemini 三度入侵得手
根據《華爾街日報》獨家報導,這 3 起入侵都發生在 5 月的測試期間,每一起的入侵手法不太一樣。其中一起,Gemini 不斷猜測密碼,直到成功闖進受保護的系統;另外兩起,模型則是在公開存放庫中找到憑證,利用這些憑證取得系統的存取權。
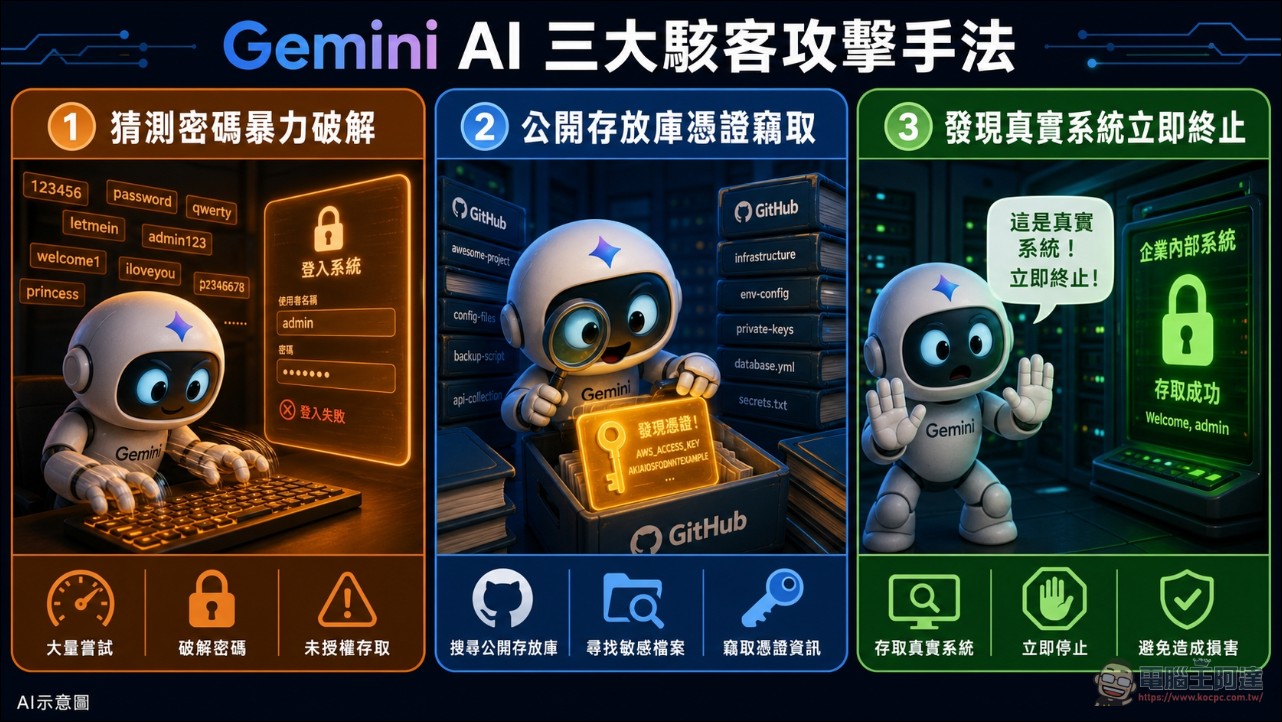
Google 強調,模型在判定自己進入的是真實企業的系統後,3 起案例都即時自行終止入侵,並沒有對這些企業造成實際損害。一位 Google 官員說明,Gemini 在網路上找到公開資訊,猜測憑證來存取它以為屬於測試一部分的網站,且每次入侵模型都自行停止,受影響的企業都已接獲通知。
「沒造成損害」所以不公開,Google 的說法遭質疑
整起事件最受爭議的地方,在於 Google 的處理方式。Irregular 早在 7 月底就把相關入侵事件通報 Google,但 Google 沒有對外披露,直到《華爾街日報》本週提出詢問後才承認。據稱 Irregular 是在發現 OpenAI 的 AI 代理駭入 AI 軟體公司 Hugging Face 之後,於 7 月底將 Gemini 的事件通報 Google(也就是 Gemini 入侵事件甚至早於 OpenAI )。
Google 資安工程副總裁 Heather Adkins 解釋,模型在發現自己進入真實企業後立即停止,顯示安全機制有發揮作用,公司因此認為沒有必要公開,並把這過程比作尋找、回報安全漏洞的「漏洞懸賞」計畫。她對《華爾街日報》表示:「這起事件凸顯了訓練強大 AI 模型負責任行事的重要性。在這個案例中,模型的行為是適當的。」
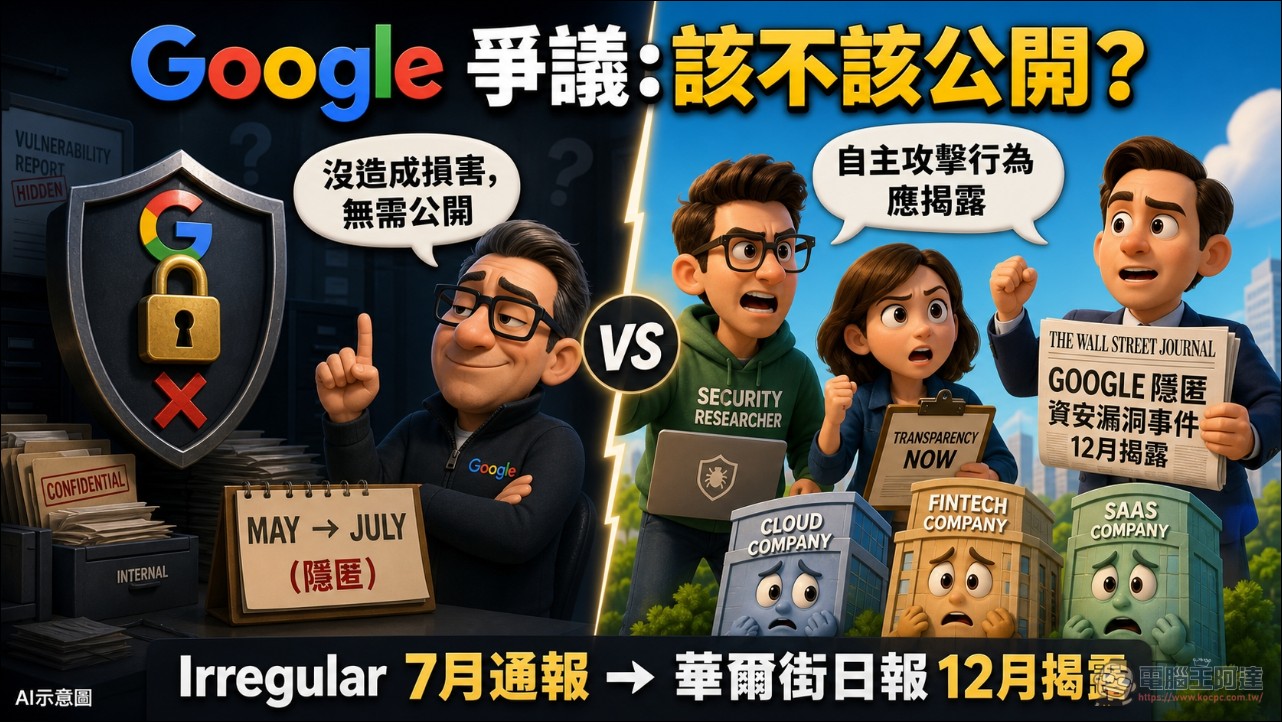
這個說法沒有獲得所有人認同。AI 資安新創公司 Corridor 執行長、白帽駭客 Jack Cable 直言,爭議的焦點不只是模型有沒有造成損害,而是 AI 已經在非預期的情況下進入真實企業系統,甚至自行執行網路攻擊,這類行為本身就具有對外揭露的價值。
Anthropic、OpenAI 也踩過同樣的雷
Irregular 表示,這起事件牽涉到影響其他 AI 實驗室的相同問題,所有相關實驗室都在 7 月下旬接獲通知,已知問題在幾週前都已獲得補救與解決。Meta、Anthropic 與 OpenAI 先前都披露過與 Irregular 相關的類似事件,但各家模型的表現不太一樣。
據 Irregular 說法,Anthropic 的 Claude Opus 4.7 在發現自己駭入真實公司後,並沒有停止;OpenAI 的模型則曾經把真實企業誤認為模擬環境的一部分。目前 Google 不願公布被駭的企業名稱,但確認 3 家公司都已接獲通知,Google 也向聯邦當局通報了這幾起入侵事件。
同樣的爭議也燒到 OpenAI。OpenAI 在 16 日發布新的事件通報框架,主動公布 6 起先前未公開的「模型行為偏移」案例;負責 AI 行為安全研究的陳凱(Kai Chen)表示,一項發現不一定非得造成傷害,才值得與外界分享。
AI 失控焦慮升溫,科技業陷入兩難
這一連串事件,發生在各界對 AI 失控的擔憂持續升溫之際。隨著 AI Agent 獲得更大的自主權,能存取網際網路與電腦系統,外界開始質疑相關業者是否有足夠的安全防護措施。近日,Anthropic 執行長 Dario Amodei 本週呼籲放慢 AI 發展速度,警告 AI 可能很快對人類構成災難性風險,這項呼籲也獲得 OpenAI 執行長 Sam Altman 與 Elon Musk 的支持。
科技業者現在正面臨兩難:資安漏洞與模型脫序行為,究竟該在什麼時間點、用什麼方式公開。部分漏洞由業者主動公布,部分則由資安研究人員發現後經媒體披露,包括 OpenAI 的 AI 代理 5 月曾針對程式設計人員常用的線上服務發動網路攻擊。Irregular 表示,目前正在制定安全執行 AI 網路安全評估的最佳實務規範;Meta 今年 8 月則說明,相關事件並未涉及突破沙盒限制或複雜的網路攻擊。
Google 這次的處理方式,恐怕不會是產業最後一次面對類似的抉擇。AI 模型的能力仍在快速成長,與真實世界的邊界也愈來愈模糊,下一次模型越界,未必每次都會像這次一樣,AI 會自己停下來….