號稱「共同發明 ChatGPT」的前 OpenAI 研究員 Diogo Almeida,昨天(9 月 15 日)結束長達兩年的秘密開發,正式公開他的新公司 TypeSafe AI 與第一款「System One 模型」Jev。公司同時宣布獲得由 DCVC 領投的 4,000 萬美元(約新台幣 13 億元)種子輪資金。Almeida 口中的「共同發明」,指的是他參與的 InstructGPT 研究:2022 年的這篇論文建立了 RLHF(人類回饋強化學習)技術,而 RLHF 正是 ChatGPT 與後續對話模型背後的關鍵訓練方法。如今他想解決的問題是:為什麼具備超人級對話能力的模型,始終沒有帶來大規模的自動化革命?他的答案是反過來設計一種「不講話」的模型。
Jev 是什麼:不做對話、只做決策
Jev 不是聊天機器人,它完全不產生文字。開發者把結構化的程式狀態與問題(例如「這個客戶要求退款嗎?」)送進模型,Jev 從預先定義的選項中挑選答案,回傳型別安全(type-safe)的結構化決策,並附上校準過的信心中分數;軟體可以設定門檻,信心高就自動執行,信心不足就轉交人工審核。官方稱這類模型「原生給機器使用」(machine-native),原始推文形容這是「針對決策全面最佳化的可組合智慧」。
After co-inventing ChatGPT, I kept asking myself: why have superhuman chat models not led to AGI?
I’ve spent the last 2 years in stealth building a new way to train models (RLCD), and a new type of frontier AI model that we are releasing today: Jev
• 20-200x faster
• 40-400x… pic.twitter.com/JSybNG2BKJ— Diogo Almeida (@CompleteSkeptic) September 15, 2026
官方文件把使用情境整理成「誰該用哪種模型」的對照:LLM 負責產生內容與對話,Jev 負責判斷。例如客服系統先由 Jev 判斷來訊意圖、是否要求退款,再由大型語言模型負責回覆措辭;代理程式每執行一步,由 Jev 檢查是否偏離任務、是否碰了不該改的檔案。推文附圖也展示了資安事件處理的決策樹範例,把警報拆成十幾個是非題與分數題,Jev 批次作答後由程式碼決定要關閉、排隊、通知使用者還是封鎖攻擊來源。
The gains aren’t free: Jev can’t generate text
Comparing Jev vs LLMs side-by-side makes the trade-off clear
Fun fact: replacing sequential computation with parallel is the same way Transformers leapfrogged RNNs pic.twitter.com/ockGnenCPP
— Diogo Almeida (@CompleteSkeptic) September 15, 2026
速度與成本的差距來自架構:外界推測 Jev 是 encoder-only 的 Transformer,以分類頭取代文本解碼器,因此沒有「輸出 token」的過程。這解釋了兩個賣點:輸出永遠免費,以及單一請求就能並行處理數百個輸出、延遲低於 100 毫秒。訓練方式換成新的 RLCD(Reinforcement Learning for Calibrated Decisions),目標是讓信心分數盡量貼近真實正確率,而不是討好人的偏好。
官方公布的數字
TypeSafe 的定價是每十億個輸入 token 收費 42 美元(約新台幣 1,365 元),換算每百萬 token 約新台幣 1.4 元;輸出 token 完全免費,官方宣稱「永遠免費」。官網一組示範數據顯示,Jev 執行單一工作流花費 0.000081 美元、耗時 0.114 秒,一般 LLM 則花費 0.013880 美元、耗時 8.566 秒,因此宣稱快 193.6 倍、便宜 444.6 倍。
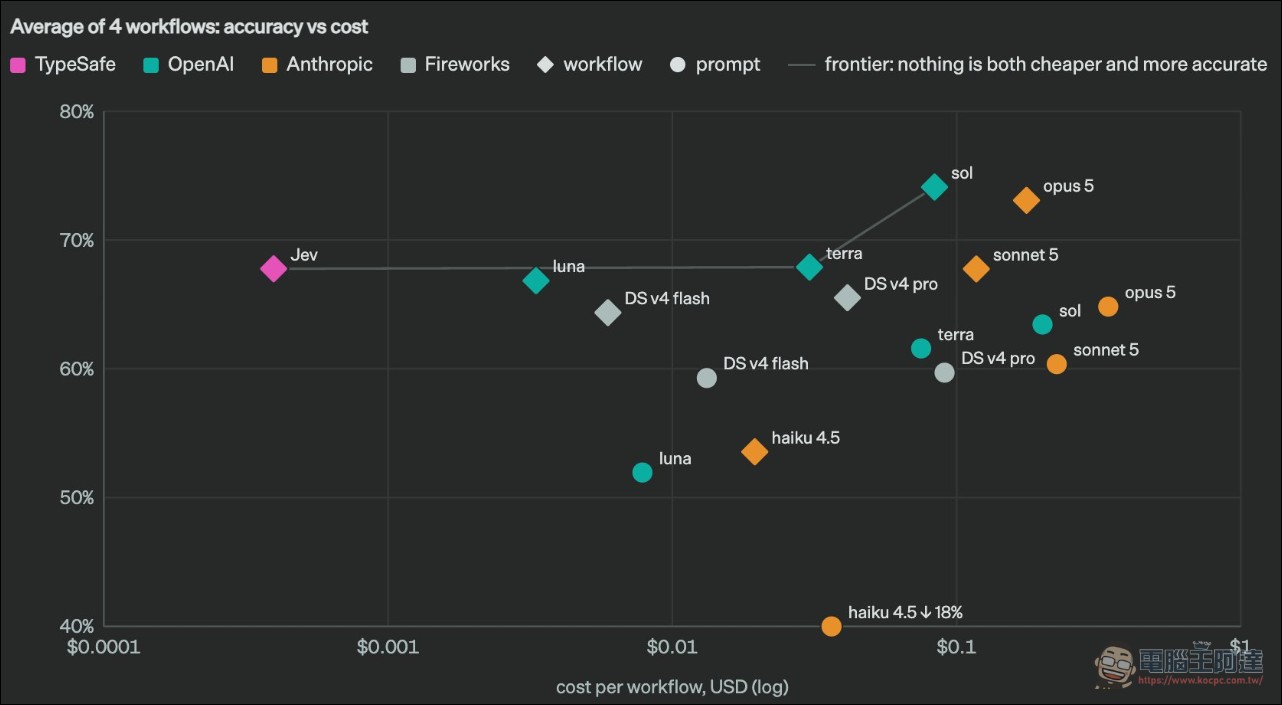
在自家設計的 4 種工作流評測中,Jev 的準確率約 68%,每工作流成本約 0.0003 美元;OpenAI 的 terra 與 Anthropic 的 Sonnet 5 準確率相近(約 68%),成本卻落在 0.04 至 0.1 美元之間,相差兩個數量級。準確率最高的 Opus 5(73% 至 74%)每工作流成本約 0.2 至 0.4 美元。另一段示範影片中,Jev 以每秒約 10 次呼叫的速度玩遊戲毀滅戰士(Doom),每小時成本約 7 美元(約新台幣 228 元)。
We love how this doomo doomonstrates real-time intelligence and what can be doone with code + AI!
~10 calls/sec = ~$7/hour pic.twitter.com/nlffKxGzCB
— Diogo Almeida (@CompleteSkeptic) September 15, 2026
背景:RLHF 與 ChatGPT 的關聯
Diogo Almeida 是 OpenAI 前研究員,論文紀錄顯示他名列「Training language models to follow instructions with human feedback」(InstructGPT)作者群。TypeSafe 的共同創辦人還有 Erik Gafni 與 Sasha Sheng[6]。Almeida 主張,RLHF 雖然造就了超強的對話模型,卻也帶來過度自信、模式崩塌與可靠性不足等問題,使大型語言模型始終需要人類介入;Jev 的設計方向正是避開對話,把人工智慧變成可靠、可測試的軟體元件。
「System One」這個名稱取自心理學的雙重過程理論,對應人類直覺式、即時反應的第一套思考系統,與深思熟慮的 System Two 相對。TypeSafe 的產品哲學是讓模型負責快速直覺判斷,把需要慢慢推理的邏輯留給傳統程式碼與大型語言模型,再以「程式碼加 AI」的方式組合起來。創辦人也在發布當天的問答中強調,他認為多數企業自動化需要的是「可靠的智慧判斷」,而不是另一套聊天介面。
限制與社群質疑
官方承認的限制同樣明確:Jev 不能產生文字、順序推理能力(例如數學)大約只有 GPT-4 等級,而且「放棄字串」對現有應用是很大的靈活性取捨。發布後 Hacker News 的討論串聚集 1,495 分、超過 400 則留言,意見兩極:有人肯定信心分數與價格的潛力,也有人質疑「frontier model」的稱號、評測方法過於模糊,以及「不會幻覺」的宣稱,因為型別不會錯,不代表答案不會錯。
討論中最常被點名的疑點有二:其一,官方表示刻意不發表標準 benchmark 成績,只提供自家設計的工作流評測,質疑者認為分數好看的話早就公布了;其二,「快 20 至 200 倍、便宜 40 至 400 倍」的口號以「System One 任務」為比較基準,而這類任務本來就是 Jev 的主場,拿它跟通用模型比速度與成本,等於拿客製化工具跟瑞士刀比單一功能。也有開發者指出類似的平行批次分類做法在開源世界已有前例,Jev 的突破更多在於把這條技術路線做成了產品並拉到如此低的價格。
結語
把 Jev 放回定位看,它更像是「最便宜、最快的高品質決策分類器」:適合客服分流、代理工具選路、資安事件分級這類固定選項的判斷,而不是取代會寫程式、會聊天的通用模型。目前採等待名單制,官方只開放部分開發者使用,外界暫時無法自行實測。若官方數字經得起複現,它對自動化成本結構的衝擊是真實的;至於「通往 AI 經濟革命的最短路徑」這種說法,恐怕要等更多人拿到 API 測試之後再驗證。