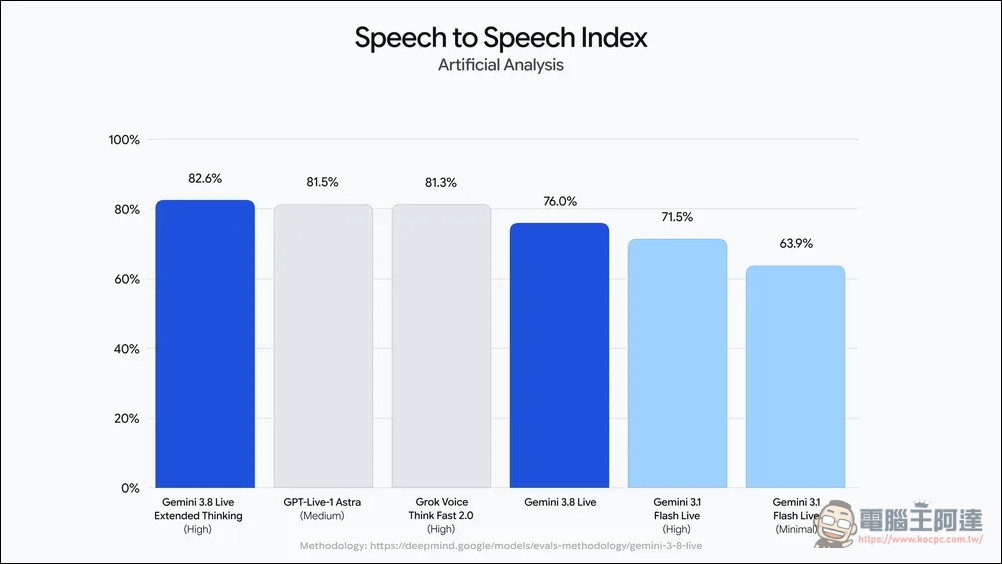
Google 於 9 月 15 日發表兩款全新語音模型 Gemini 3.8 Live 與 Gemini 3.8 Live Extended Thinking,鎖定即時語音代理(Voice Agent)應用。Extended Thinking 版本在 Artificial Analysis 的語音對語音品質指數(Speech-to-Speech Quality Index)拿下82.6 分,名列第一。這兩款模型透過 Gemini API 與 Google AI Studio 開放開發者使用,主打「對話過程中同時執行任務」,模型能在背景呼叫 API 或工具,同時持續對使用者輸出語音回應,不會中斷對話流程。
Gemini 3.8 Live 兩款模型的定位差異
Gemini 3.8 Live 定位為「大規模部署、成本效率優先」的語音對語音模型,在 Speech Agent Arena 中獲得使用者偏好度第二名。核心能力包括:
- 非同步函式呼叫:在背景執行 API 與工具呼叫,同時持續串流語音回應給使用者
- 即時視覺上下文:將即時視覺輸入納入對話脈絡,讓語音代理能理解使用者「說了什麼」和「看到了什麼」
- 英數字精確度:準確解析確認碼、理賠編號、技術規格等英數混合資訊
- 97+ 語言支援:對話中自動偵測並切換語言,無需手動設定
Gemini 3.8 Live Extended Thinking 則針對高複雜度任務設計,具備更深層的推理能力。它支援「可配置思考」(configurable thinking),能在背景處理多步驟推理,同時用口語提示(如「讓我確認一下⋯⋯」)維持對話不中斷,並即時播報任務進度。
Gemini 3.8 Live 跑分成績
Google 公佈的基準測試數據顯示:
- Artificial Analysis 語音對語音品質指數:Extended Thinking 以 82.6 分居冠,標準版 3.8 Live 獲第二名
- τ-Voice 代理任務完成率:Extended Thinking 達 68.6%
- Sierra τ-Voice-banking:35.1%
- Big Bench Audio 推理能力:97.7%
- ServiceNow EVA-Bench:在準確度與對話品質的平衡上推進了帕累托前緣(Pareto Frontier)
Google DeepMind 首席工程師 Tom Ouyang 在部落格文章中表示,這兩款模型相較前代 Live 模型帶來「階躍式的提升」(step change),也提供比串接式架構(cascaded architectures)更精簡的替代方案。
Gemini 3.5 Transcribe:語音轉文字模型同步整合
Google 也一併將上月推出的 Gemini 3.5 Transcribe 整合至同一套開發者工具組。這款語音轉文字模型支援 85+ 種語言,串流模式下詞錯率(WER)為 4.0%,非串流模式則為 2.6%。
Google 推出全新 Gemini 3.5 Transcribe 語音轉文字模型:不僅更精準、更快,還會自動去贅詞、整理格式
特色功能包括:
- 自動語碼切換:句內與句間的語言切換自動處理,無需手動設定
- 自訂詞彙偏向:可傳入最多 1,000 個專業術語清單,引導語音辨識優先識別特定領域詞彙
- 智慧轉錄模式:自動移除填充詞、修正口誤,輸出結構化、可直接閱讀的轉錄文本
3.5 Transcribe 也可透過 Interactions API 處理最長 1 小時的音訊檔案,支援結構化時間戳與說話者標記。
定價與合作夥伴
Gemini 3.8 Live 系列定價為音訊輸入每分鐘 0.005 美元(約 NT$0.16)、音訊輸出每分鐘 0.018 美元(約 NT$0.59),換算約為輸入每百萬 Tokens 3 美元、輸出每百萬 Tokens 12 美元。
在合作夥伴方面,Agora、Fishjam、LiveKit、LangChain、Pipecat、Vercel 與 Vision Agents 等平台已同步支援 Live API,負責處理即時媒體串流基礎設施。企業端合作夥伴則包括 Salesforce、ServiceNow、Genspark 與 Lumeris 等。
Google 也同步提供完整的語音工具組,包含 Gemini 3.5 Live Translate(70+ 語言語音對語音翻譯)、Gemini 3.1 Flash TTS(語音生成)以及 Lyria 3.5(音樂生成),全部透過 Gemini API 存取。