
本地 AI 模型發展到現在,很多人一定會好奇,究竟已經到什麼程度了?雖然每次新模型發表都會有跑分數據可以參考,但畢竟只是數字,即便高分也不確定是否實際上真的能滿足開發需求。最近在 Reddit 論壇中,就有一個案例很適合展現目前本地 AI 模型的實力。
一位網友分享,他透過一張 RTX 3090 顯示來運行本地的 Qwen3.8-27B,花費約 5 個小時,就做出可遊玩的 3D 場景第一人稱殭屍射擊遊戲。也代表說,一個人、一張老卡、再加一顆開源模型的配置,不用支付任何 API Token 費用,現在已經能做到這樣了。
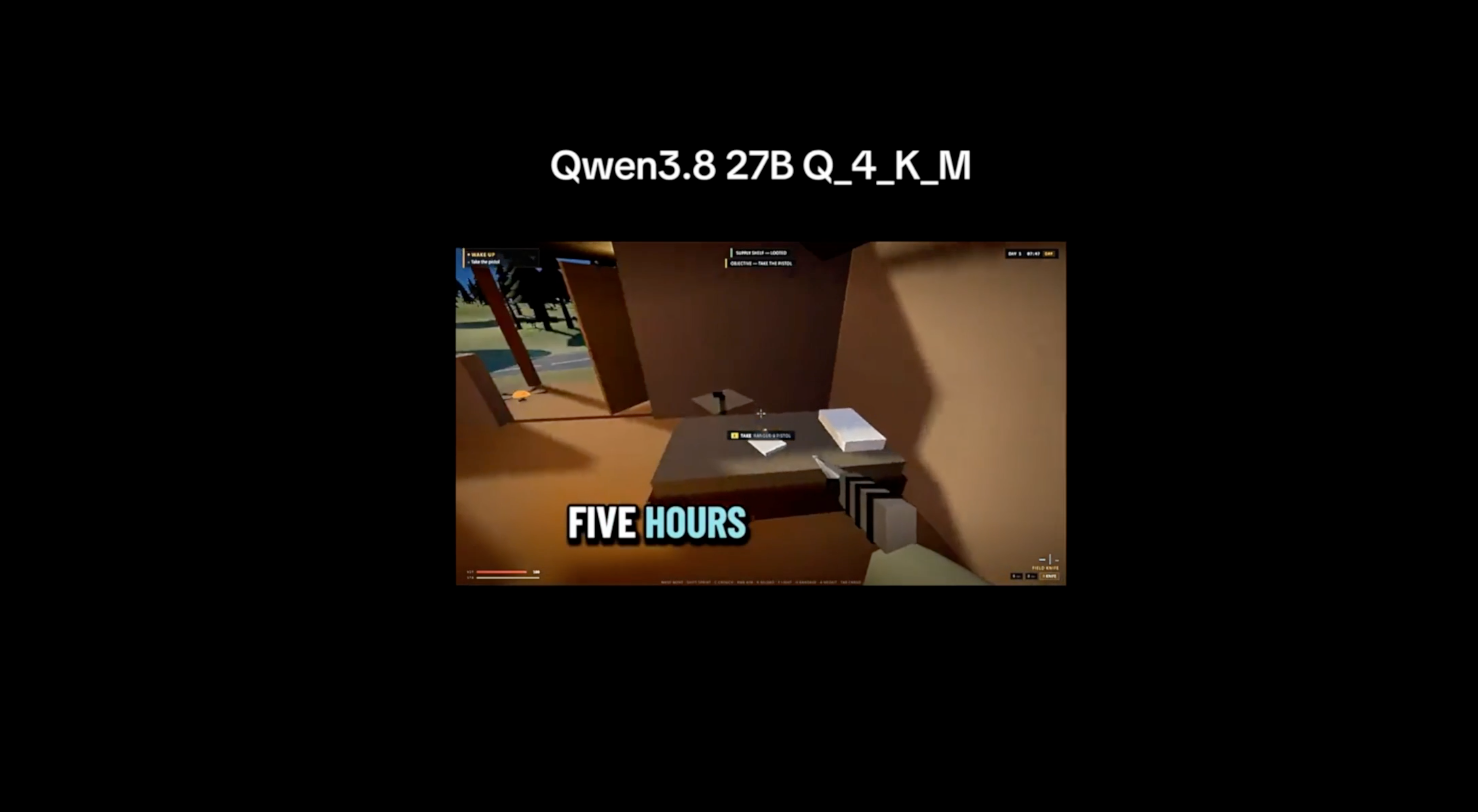
不用雲端、不燒 Token!網友用一張 RTX 3090 跑本機 Qwen3.8-27B,5 小時做出可玩的第一人稱殭屍射擊遊戲
一位 Reddit 網友 EcstaticDentist 近日在 r/LocalLLaMA 分享,他在他的 RTX 3090 舊遊戲 PC 上,運行 Qwen3.8-27B 的 Q4KM 版本,也就是 4-bit 量化、檔案約 16.8GB,大約 5 小時就做出一款第一人稱殭屍射擊遊戲。而且遊戲檔案也非常小,只有 190MB。
整個過程大約 5 小時,用了兩套自行設定的代理式編程工具(agentic coding harness)、同一顆模型,顯卡是 RTX 3090 並且用 MSI Afterburner 超頻拉了約 12% 效能,量化版本是 Q4KM。他說這純粹是做好玩的,目的是讓大家看看「Q4KM 版 Qwen3.8-27B 效能與能力的天花板附近」做出來的專案長什麼樣,之後會把整個專案丟上 GitHub 開源,甚至邀大家「只用本機模型迭代」一起接著改。
Decided to build a game, and test the ceiling of Qwen3.8 27b
byu/EcstaticDentist inLocalLLaMA
當然,他不是靠一個提示詞就完成這款遊戲。他在留言中補充,每一輪 session 大約花一小時,中間會穿插一些手動指引。
第一輪生出來的版本問題很大,直接卡在整張地圖底下動不了。後面幾輪才把玩家碰撞、移動操作、光影這些一個一個修好。他也強調整個遊戲「完全是靠強力提示詞寫出來的」,沒有手動改程式碼。
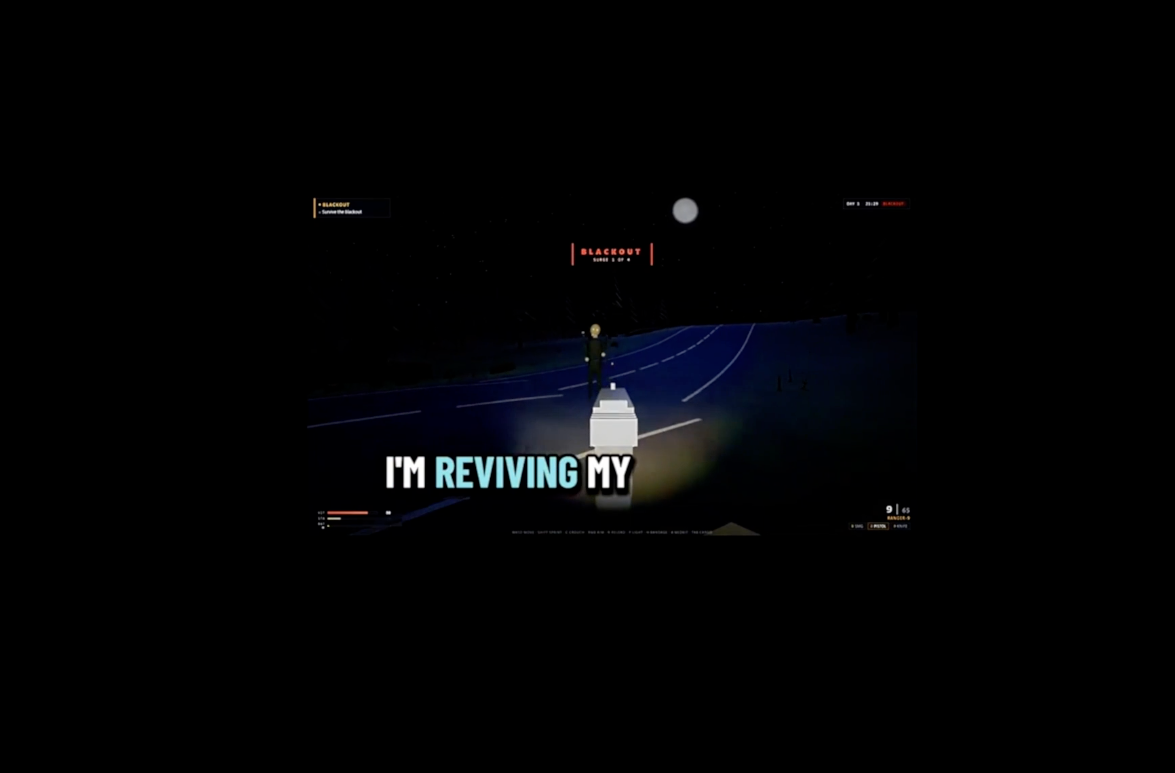
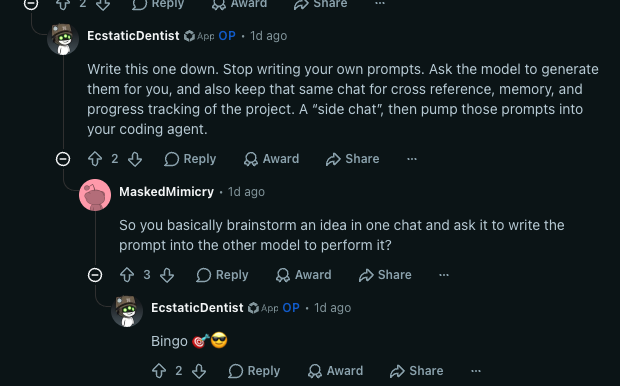
下提示詞部分,他也分享一個技巧:不要自己寫提示詞,而是叫模型幫你寫。
做法是另外開一個「側邊對話」,在那裡跟模型討論想做什麼、請它產出完整的提示詞,同時這對話也能兼任專案的記憶與進度追蹤。然後把產出的提示詞丟給程式代理去執行。也就是「一個對話當導演、另一個模型負責寫程式,你自己當中間人跟測試員」。
至於這款遊戲究竟使用什麼引擎或框架製作,原作者並沒有特別說明。從成品來看,推測可能是以 HTML、JavaScript 等網頁技術打造。也有網友認為很可能是 JavaScript 作品,畢竟目前 LLM 在撰寫網頁程式方面已經相當成熟,相較之下,真正拿來開發 Unity、Godot 或 Unreal Engine 專案的案例非常少。
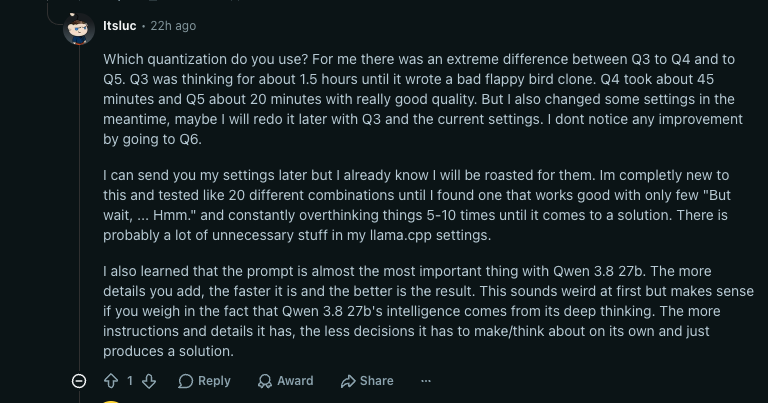
留言裡也有人分享了使用不同量化版本做同一款小遊戲的實測,Q3 版思考大約 1.5 小時才寫出一個很爛的 Flappy Bird 仿作,Q4 大約 45 分鐘,Q5 只要 20 分鐘而且品質明顯好很多,Q6 就沒再看到差異。他也提到 Qwen3.8-27B 對提示詞細節非常敏感,描述越完整跑得越快: