OpenAI 官方開發者帳號在 9 月 11 日發文,呼籲所有使用 Codex、ChatGPT 等代理工具的開發者,重新檢視自己寫下的 skills、AGENTS.md 與任務提示詞,並同步刊登一篇名為《Rethinking skills and prompts for GPT-6 Astra》的部落格文章。這篇建議來得正是時候。GPT-6 Astra 是 OpenAI 在 9 月 3 日推出的旗艦模型,官方宣稱它是最聰明、也是最「聽話」的模型,在電腦操作、程式撰寫與科學推理等基準測試都勝過前代 GPT-5.6 Sol,資安能力更首度被評為「重大」(Critical)等級。然而官方在部落格中給出的提醒,和直覺正好相反:模型越強,開發者堆疊的指令反而要越少。
OpenAI 官方建議把GPT-6 Astra Skills、AGENTS.md 瘦身
為什麼舊指令會拖累新模型
OpenAI 開發者體驗團隊的 Eric Provencher 在文中指出,過去一年裡,大家為了引導模型走向理想結果,累積了大量 instructions:可能是 skills、可能是 AGENTS.md,也可能是每次任務下的提示詞。這些檔案確實幫過忙,但當模型換成 GPT-6 Astra 之後,許多過去必要的攙扶現在反而變成阻礙。
問題首先出在 skills 的描述。每個 skill 都附有名稱與描述,這些文字會全部載入模型脈絡,讓它判斷何時該使用。但許多人把描述寫得太長,一旦掛載的 skill 數量過多,Codex 就會開始截斷描述以節省空間,模型看到的資訊變少,反而更難選對 skill。更糟的是,描述之間可能互相矛盾,或過度強調適用時機,導致模型載入一堆當下用不到的指引,白白耗掉脈絡空間,更快逼近壓縮門檻。
官方建議:三個原則重寫 skills
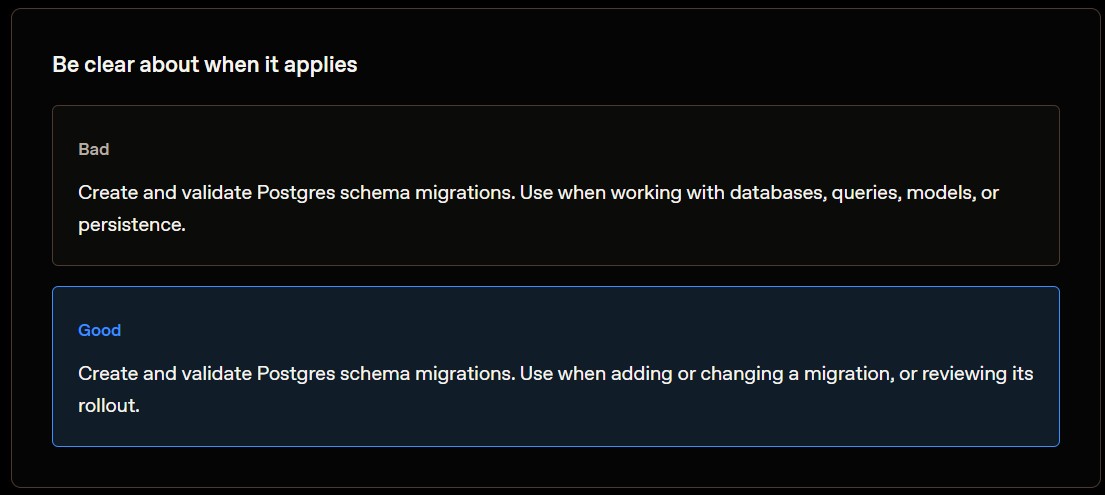
部落格提煉出三個重寫原則。第一,skill 描述要盡可能簡短,但必須說清楚何時該用。文中舉例:描述寫「使用資料庫、查詢、模型或持久化時使用」(Use when working with databases),會讓模型碰到任何資料庫相關工作都觸發它;改成清楚的「新增或修改 migration、或檢視 migration 上線時使用」,觸發時機才精準。
第二,善用「漸進揭露」(progressive disclosure)。閱讀 skill 本身就會消耗脈絡,因此一個包含多種工作流程的 skill,根文件應該只當路由器,列出簡短索引,把細節放進支援文件與 scripts,讓模型在需要的時刻再深入讀取,而不是一口氣全部載入。
第三,別再把 skill 寫成鉅細靡遺的食譜。模型對語意模糊的處理能力大幅進步,過去依賴細部步驟才能穩定輸出的作法,現在反而會限制模型發揮。文中還提醒,repository 內的 skill 會影響其他開發者的代理,不同模型適合的指令強度不同,替 Sol 或 Luna 設計的指引,對 Astra 可能過度約束。
AGENTS.md:從「每次全讀」改成「按需閱讀」
AGENTS.md 的準則也同樣需要更新。過去模型需要被明確要求「每次編輯前先讀 architecture.md、database.md、deployment.md」,但對 Astra 來說,改一個錯字就要求它讀完整份文件,只是在燒脈絡、拖慢速度。官方建議改成情境式的指引:架構問題看 architecture.md、schema 變更看 database.md、準備部署時再看 deployment.md,讓模型自己判斷該讀什麼。
另一個常見的過時指令是「跑完一定要測驗」。前代模型需要被鼓勵執行測試並檢查成果,但 GPT-6 Astra 本來就會自動這樣做,同樣的指示現在會導致不必要的測試。不過官方也指出,Astra 天性較謹慎,有時會停在半路等確認,此時可以在 AGENTS.md 明確授權一段你確認過安全的工作流程,例如允許本機測試套件自動執行、自行修復失敗項目,不需要每一步都徵求同意。
決策邊界與「完成」的定義
關於授權邊界,官方給出一個微妙提醒:如果你過去為了防止模型越權,寫下了強烈的「先問再做」指令,換成 Astra 後應該重新考慮。Astra 是 OpenAI 目前與使用者意圖最一致的模型,判斷力明顯較好,只有在確認安全的情況下才會行動;舊的強硬邊界語言可能讓它過度保守,在你其實樂於讓它繼續的地方停手。
相對地,Astra 對「何時該停」比較沒有把握,常常完成第一版實作就回頭等 review,其實還有工作可以做。解法是在任務開始前就定義「完成」的樣貌:如果任務包含把實作跑起來、檢查結果、修復失敗,就把這些步驟寫進請求;若希望它繼續探索,也要明說探索的範圍與終點。官方在文末建議,新模型正是清理專案指令的好時機,甚至可以反過來請 Astra 依照這篇文章的標準,自己幫你 audit 一遍專案裡的各種檔案。
社群反應與 API 變動
這篇文章在開發者社群引起迴響,Reddit 的 r/codex 板當天就出現整理文,有人把官方指引濃縮成可直接貼進 AGENTS.md 的提示詞,也有人分享自製的 openai-docs skill,會自動檢查專案並套用適合 Astra 的模型與提示詞修改。討論中還點出官方 API 的重大變更:temperature、top_p、top_logprobs 等參數已不再支援,工具呼叫改為採用 Responses API。
Before blaming GPT-6 Astra, read its prompting guide
byu/Icy_Piece6643 incodex
也有聲音質疑時機:Astra 需求暴增,OpenAI 自 9 月 10 日起暫停每月 200 美元的 Pro 方案新訂閱,舊用戶不受影響。也有 Reddit 使用者抱怨用量限制嚴格,輕度使用就把每週額度燒掉大半,也有人設定 Sol 為預設模型、需要時才手動切換到 Astra,作為規避用量壓力的折衷方案。與此同時,OpenAI 也把 Astra 逐步推進 ChatGPT Work、Codex 與 API,擴大企業端應用。
結語
換到 GPT-6 Astra,開發者最該做的就是重新審視既有指令的「密度」。官方反覆傳達的核心訊息很簡單:描述要精準、檔案要按需閱讀、邊界要留給判斷力更好的模型。把堆了半年的 scaffolding 拆掉,也許才是讓 Astra 發揮實力的第一步。如果你完全沒概念的話,把這篇文章或原文丟給 Astra 它就會去整理了。