以後就算是視訊電話也不能全部相信了,舊金山 AI 研究公司 Tavus 發表最新的 AI 視訊模型:Griffin,稱它是第一個通過即時視訊圖靈測試的模型:在一分鐘的即時視訊盲測中,54 名參與者有 26 人(48%)認定螢幕對面是真人,他們的前代系統在同一路測試下只有 1 人(2.4%)能騙過對手。Tavus 把 Griffin 定位為一個新的模型類別:HIM(Human Interaction Model),一個全雙工的 video-to-video 系統,邊說話邊聽、邊看。
全雙工架構:每秒都在決定要不要開口
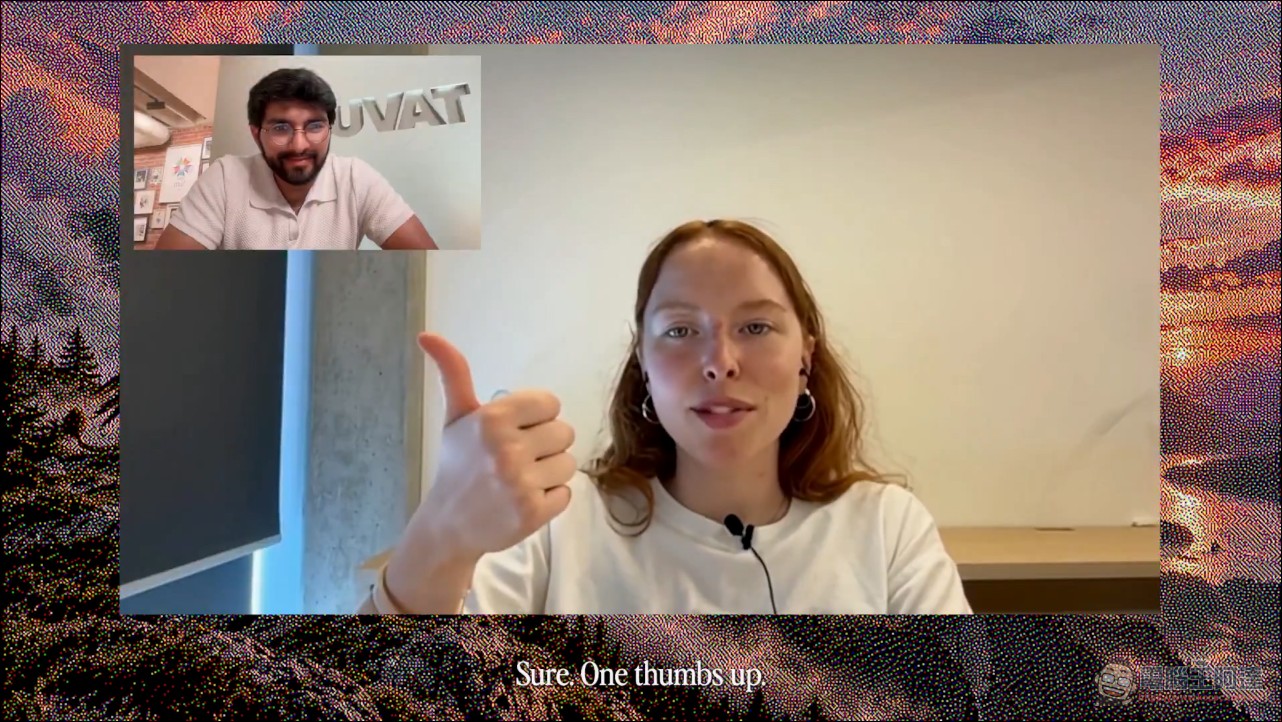
多數即時語音 AI 採用串接式管線:語音辨識、語言模型、語音合成一道道接力,等用戶講完才開始回應。Griffin 的對話引擎不以「輪次」為單位,而是在亞秒級的間隔持續評估對話狀態,每個 mini-turn 決定要說話、點頭、發出「嗯哼」的附和聲,還是保持安靜。它同時讀取影像,能辨識眼神、表情與使用者舉起的物件;人類思考時的停頓不會被當成發言結束,被打斷時也能停下來、之後接回原本的位置。
Introducing Griffin, the first model to pass the video Turing test. 48% of people who talked to it live thought it was a real human. Previous systems have had a pass rate <3%. It is #1 on NVIDIA’s benchmark for full-duplex AI video. It’s the first Human Interaction Model (HIM). https://t.co/eb11XbC8Xr
— Tavus (@tavus) October 1, 2026
官方示範影片展示了這種能力的細節:玩 Simon Says 時,Griffin 要同時聽指令、看對方的手、動自己的手;講故事講到一半,對方舉起孔雀玩偶,它就把孔雀寫進劇情;指導使用者解魔術方塊時,從镜头里看著他的手,對方安靜思考時它就等待。生成涵蓋的是整個畫面,臉只是其中一塊:從一張參考照片出發,連人物坐的椅子晃動、影子與背景都在即時生成的範圍內。
底層技術:10 秒克隆語音、720p 每 320 毫秒一塊
Griffin 是兩部分系統。連續對話建模引擎吸收音訊與影像,輸出決定「說什麼、怎麼說」的控制訊號;音訊視覺生成引擎再把這些訊號變成語音與影像,感知、決策、生成三者平行運作。語音端用一個叫 Tavec 的卷積自編碼器,把 48 kHz 音訊壓成連續表徵:每 10 毫秒一幀、每幀 40 個數值,沒有 codebook;解碼器完全因果,音訊封包小到 10 毫秒,句子還沒講完語音就能開始播放。語音生成用自回歸擴散模型 VDiT,靠一段約 10 秒的參考音訊就能克隆說話者的聲音。
影像端把一個大型雙向多步擴散模型蒸餾成少數步驟的自回歸生成器,分三個階段:先用 Distribution Matching Distillation 做出快速學生模型,再用 teacher forcing 轉成逐區塊生成,最後用 Self-Forcing 訓練讓長時間生成不漂移。VAE 把時間軸壓縮 8 倍,在 25fps 下一份 latent 對應 320 毫秒,因此能在即時狀態下產出 720p 影像。在 H100 上,從收到音訊到畫面上出現反應的平均延遲是 0.43 秒,只有次快方法的一半。
NVIDIA 基準:只比真人差 0.09 分
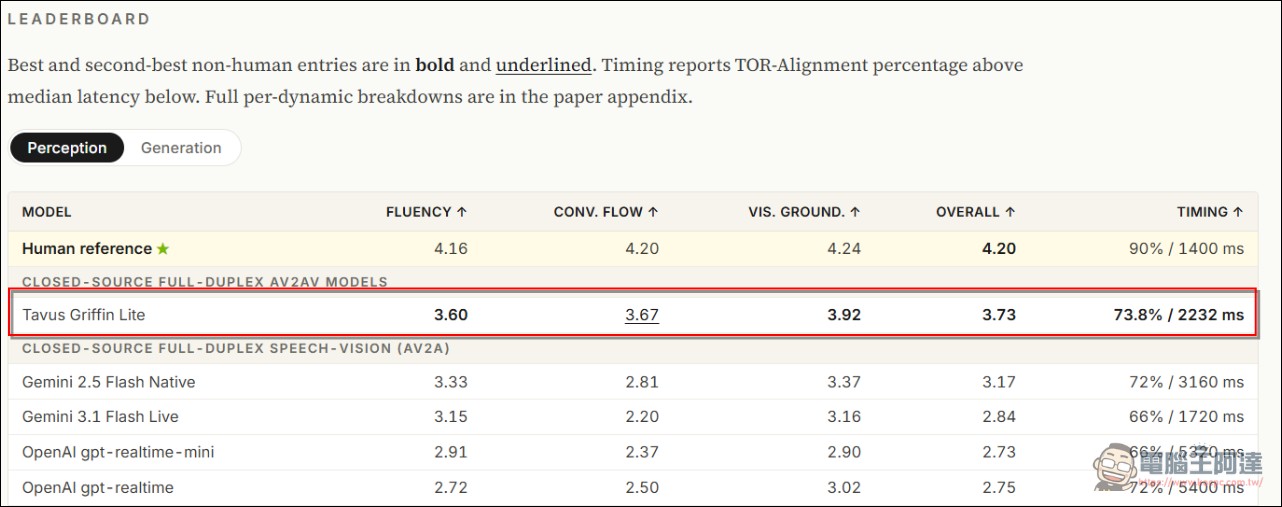
NVIDIA 的 VideoFDB 是評量全雙工音訊視覺對話的產業基準,由 NVIDIA 獨立評分。生成組考的是模型自己輸出的語音與表情是否自然:Griffin 拿到 3.83 分(滿分 5),人類參考錄音是 3.92,次強系統(Gemini 2.5 搭配 Anam)只有 2.80,Griffin 與真人的差距縮到 0.09 分,比任何其他系統接近真人 12 倍以上。感知組考的是模型懂不懂當下的情境:Griffin 3.73 分,勝過 MiniCPM-o 4.5 的 3.44、Gemini 2.5 Flash Native 的 3.17 與 OpenAI gpt-realtime 的 2.97,是受測 15 個模型中最會「讀空氣」的一個,人類基準為 4.20。兩組的接管率對齊(何時開口的時機與真人對話的吻合度)分別是 62.8% 與 73.8%,都是榜上最高。
盲測細節:懷疑的人多在 20 秒內起疑
研究透過獨立研究平台招募參與者,告訴他們會與另一位參與者進行一分鐘視訊,聊聊今年最期待什麼;對面其實是跑著 Griffin-Lite 的虛擬人物,事後問卷最後才詢問「有沒有想過對方可能不是真人」,結束後所有人才被告知真相。過半數參與者說這個念頭從頭到尾沒出現過;起疑的人多半在前 20 秒內察覺。說對方是真的參與者平均有 79% 信心,說對方是 AI 的也有 81% 信心。評分(7 分制)方面,自然度 5.4、可信度 5.6、「願意再聊一次」5.8,後者在那些識破 AI 的參與者之間仍有 5.4;「感覺對方真的在聽」拿到 5.5,「對話流動自然」4.9 是五項最低。
為什麼不開放:公司自己按下了暫停鍵
Tavus 明確表示 Griffin-Lite 目前不對客戶開放,只提供給一小群受信任的測試者,理由是同一套讓它自然的特性,也能讓人被欺騙到以為螢幕對面不是 AI。公司說正在開發安全揭露功能,並與 AI 安全組織合作,希望處理完疑慮後盡快推出完整版。這個風險並非假設:TRM Labs 統計 2026 年犯罪組織採用 AI 的年增率達 40%,詐欺案件領先成長。X 上的討論也聚焦在同一點:「48% 基本上是擲硬幣,過了這個點,確認對方是不是 AI 唯一可靠的方法只剩它自己說,揭露不再是可選項」。
這個 48% 也有必須打問號的地方:通話只有 60 秒、樣本 54 人、研究由賣這套技術的公司自己執行,目前沒有外部複製;「視訊圖靈測試」的定義本身也是 Tavus 擬定的(也就是他自己說的)。對話拉長到一小時會怎樣,沒有人知道。
結語:一家做視訊 AI 的公司,把牌翻在「像人」上
Tavus 累計募資約 7,000 萬美元(約 NT$22.4 億),投資人包括 CRV、Sequoia Capital、Scale Venture Partners 與 Y Combinator,2025 年 11 月由 CRV 領投 4,000 萬美元 B 輪,2026 年宣稱服務超過 10 萬名開發者。既有客戶用的是 Phoenix、Sparrow、Raven 那套產品線,Griffin 是他們把「像人」這件事推到最前面的下一張牌。官方設想的應用包括注意到學生聽不懂就換個講法的家教、陪伴長輩的聊天夥伴、舉起破損零件就能一起找出修理方式的客服。技術數據漂亮,安全機制還沒上線,Griffin 的兩難很直白:模型越像人,越需要強制揭露它是 AI;這段差距怎麼補,會決定它是產品還是事故來源。