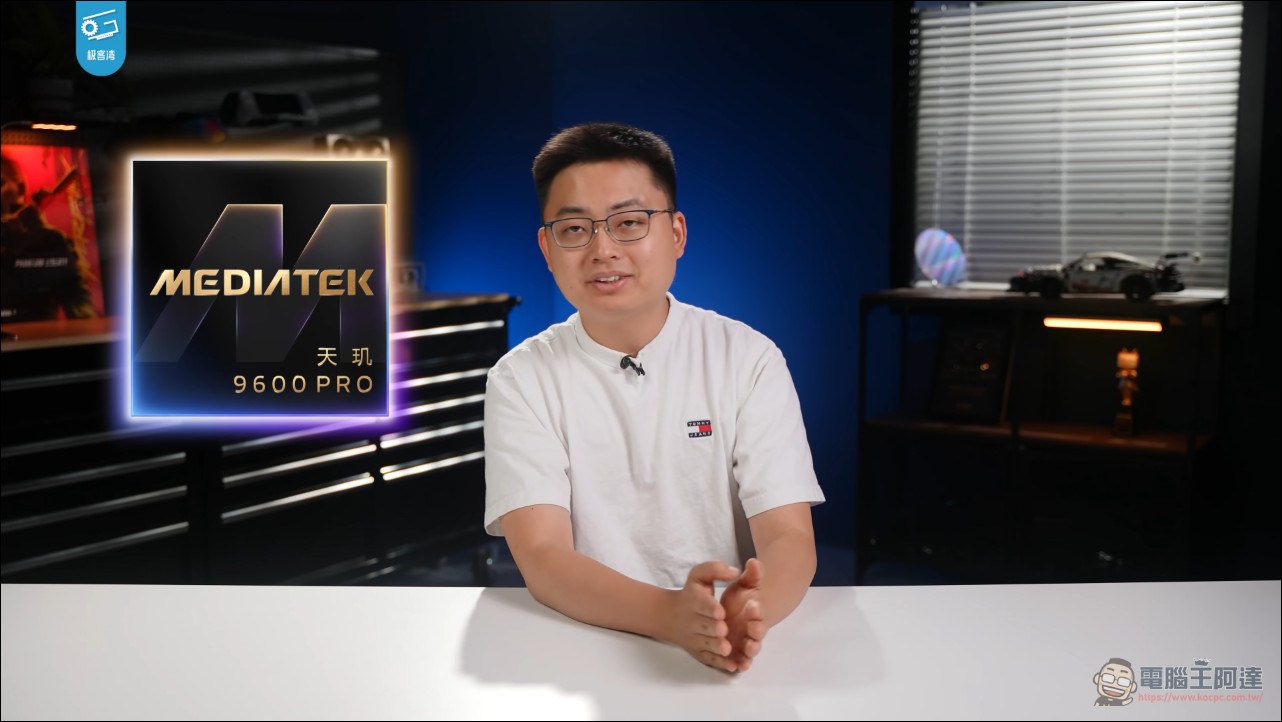
聯發科於 9 月 15 日正式發表天璣9600 Pro(Dimensity 9600 Pro),首款採用台積電 2nm 製程量產的手機晶片,擁有超過 330 億顆電晶體, 天璣9600 Pro 也是聯發科首款以「Pro」為後綴的旗艦晶片,代表這是架構層級的重新設計,不只是製程微縮。台積電 N2P 製程的密度進步,也為核心配置調整提供了空間。將由 vivo X500 系列全球首發。同日,B站科技頻道「極客灣」取得聯發科提供的工程機,進行了完整的效能與遊戲實測。
天璣9600 Pro CPU架構:從1+3+4改為2+3+3
天璣9600 Pro 的 CPU 維持 8 核心,但架構從上代天璣9500 的 1+3+4 改為 2+3+3。超大核從一顆 C1-Ultra 升級為兩顆 C2-Ultra,L2 快取各給到 2MB,峰值頻率 4.55GHz,終於做成雙超大核。
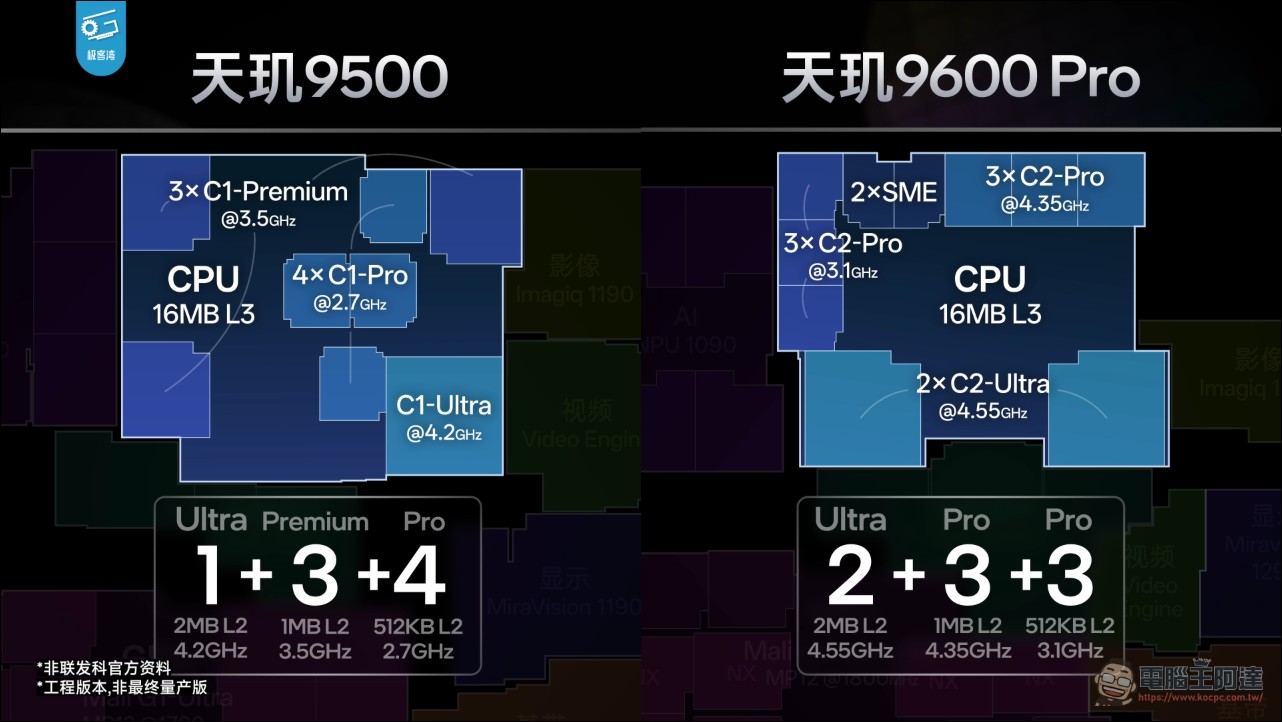
原本的 Premium 大核這次沒有再用,改為 6 顆 C2-Pro:其中 3 顆搭配 1MB 快取、峰值 4.35GHz 擔任性能核;另外 3 顆搭配 512KB 快取、最高 3.1GHz 擔任能效核。C2-Pro 就是 C1-Pro 的更名版,這次調整等於犧牲一顆大核換來多一顆超大核,瞄準需要高效能瞬發的場景。CPU 部分還搭載兩顆 SME 單元,支援 CPU 端的 AI 運算。
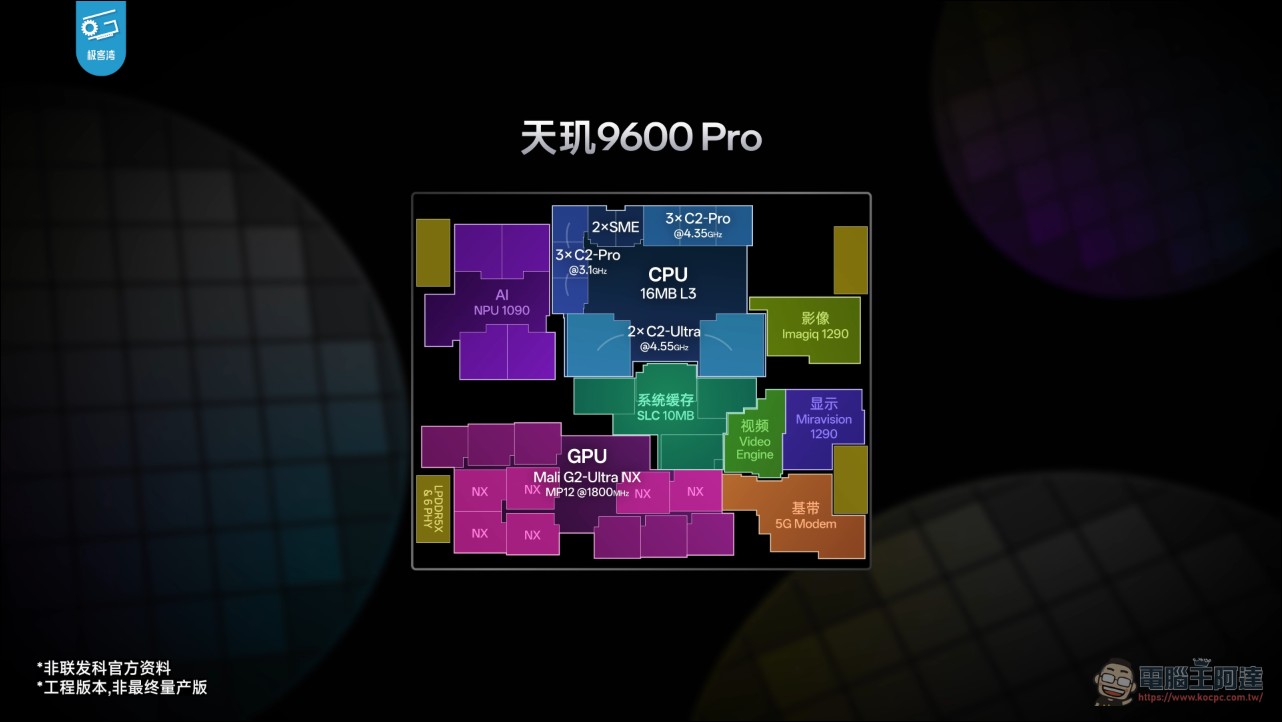
雙超大核架構是聯發科對「日常使用需要什麼」場景的回答,多數手機使用場景是短暫的高負載切換(開啟App、載入遊戲),雙超大核能更有效地分配瞬發任務,而非將所有壓力集中在一顆核心上。
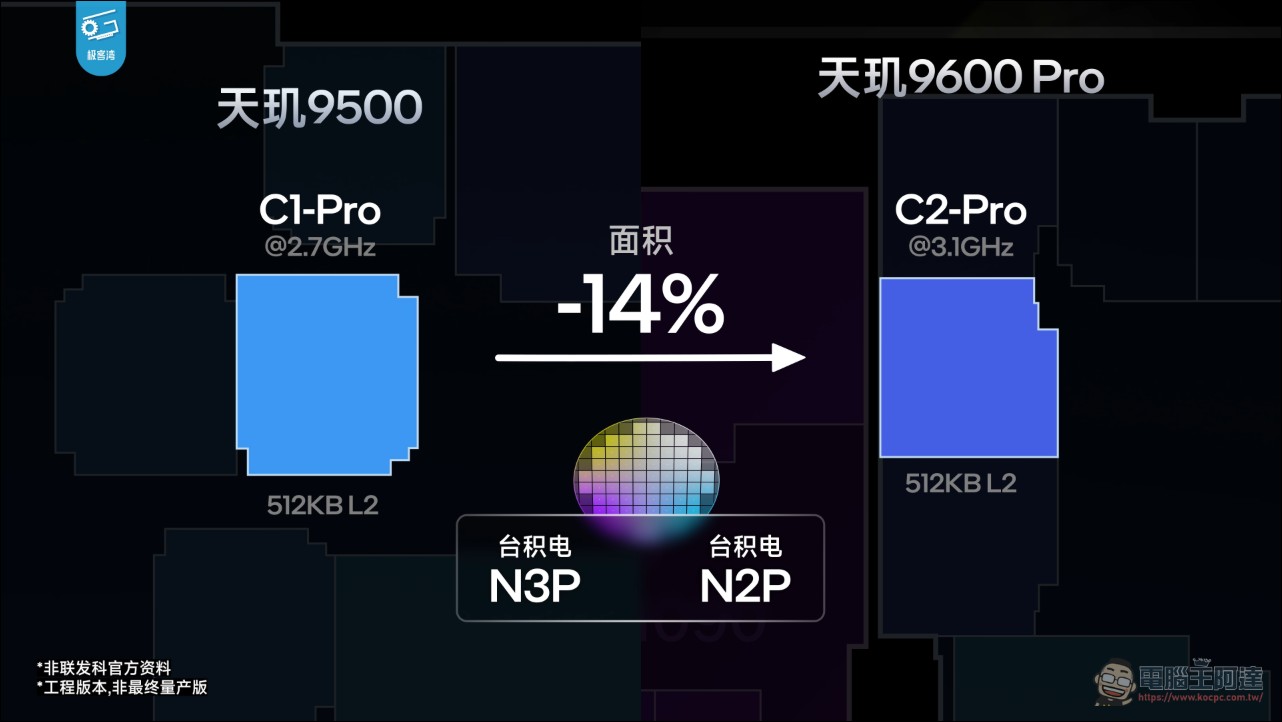
天璣9600 Pro 上的能效核 C2-Pro 與天璣9500 的 C1-Pro 做面積對比,兩者是同一顆核心,但 9600 Pro 的單個能效核面積小了 14%,證實 N2P 製程的密度確實有所提升。整體晶片面積也比天璣9500 更小。
GPU升級:Mali G2-Ultra NX、峰值1.8GHz
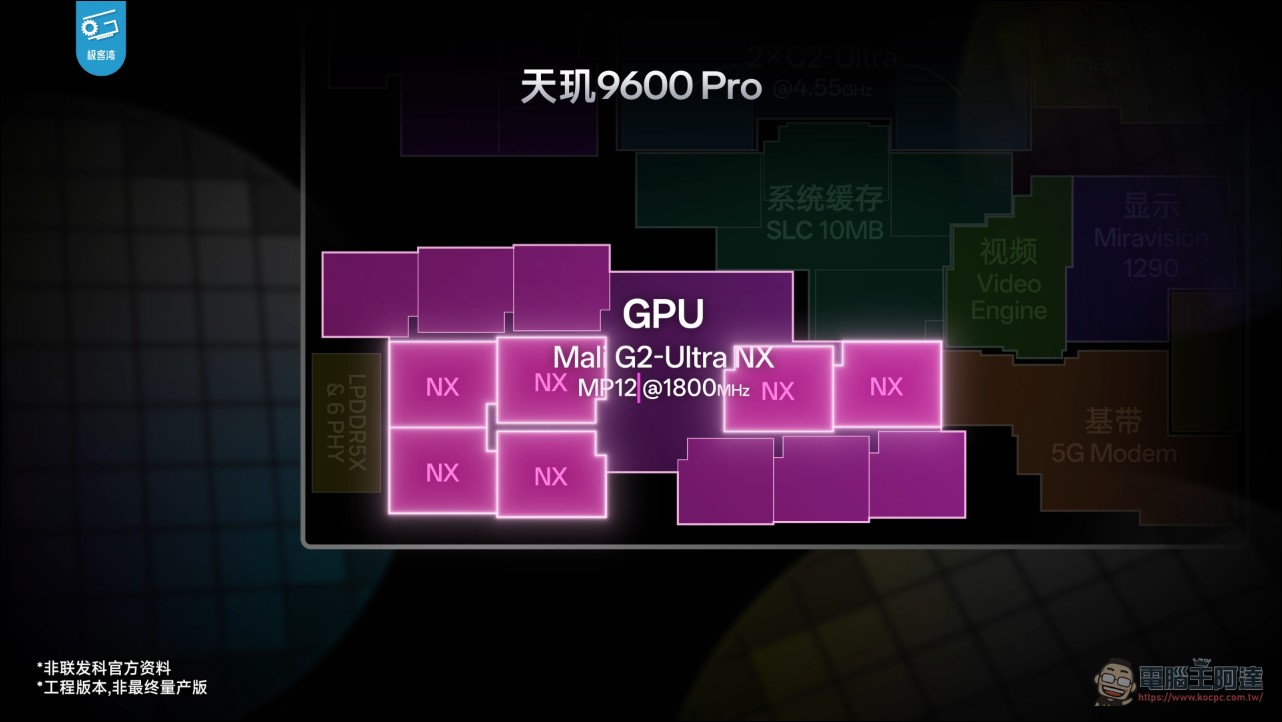
GPU 換上 Arm 最新的 Mali G2-Ultra NX 架構,維持 12 核心配置,其中 6 顆是支援 AI 超分插幀的 NX 單元。峰值頻率達到 1.8GHz,極客灣形容「這是一個相當離譜的高頻」。NPU 也升級到新的 APU 1090,在 N2P 製程密度提升的情況下,NPU 面積反而增加,代表這代旗艦晶片在 AI 上都不甘示弱。
CPU能效實測:GB6單核近4300、GB7首測出爐
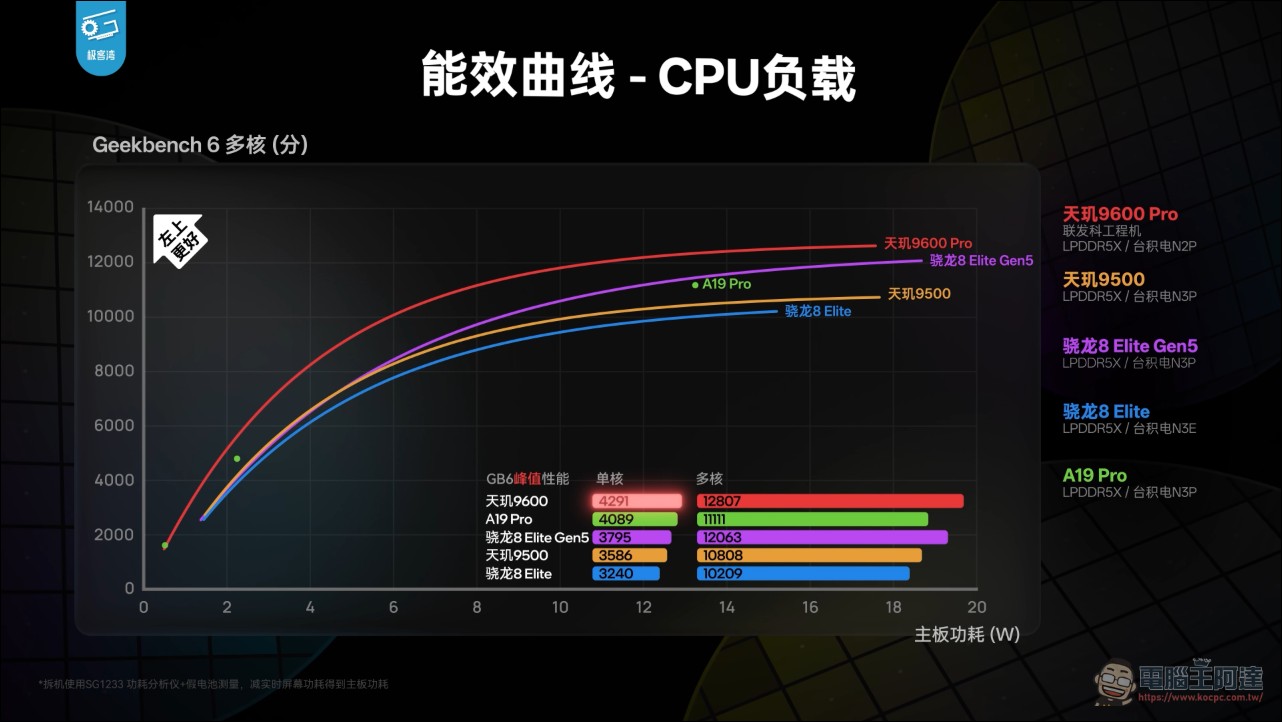
極客灣以 GeekBench 6 測試這台工程機,單核跑出將近 4300 分,多核能效「拉出代差」,尤其日用場景較多的中頻能效領先幅度頗大。官方 GeekBench V6.4 跑分數據則為單核 4276 分、多核 12650 分,相較天璣9500 的 3666 / 11014 分,單核提升約 17%、多核提升約 15%。
極客灣也首次跑 GeekBench 7 多核能效,由於是新基準首次測試,各處理器未必完全發揮,數據僅供參考,但天璣9600 Pro 相比前代的領先幅度比 GB6 更大。官方數據顯示,超大核功耗較前代下降 37%、多核功耗下降 61%。
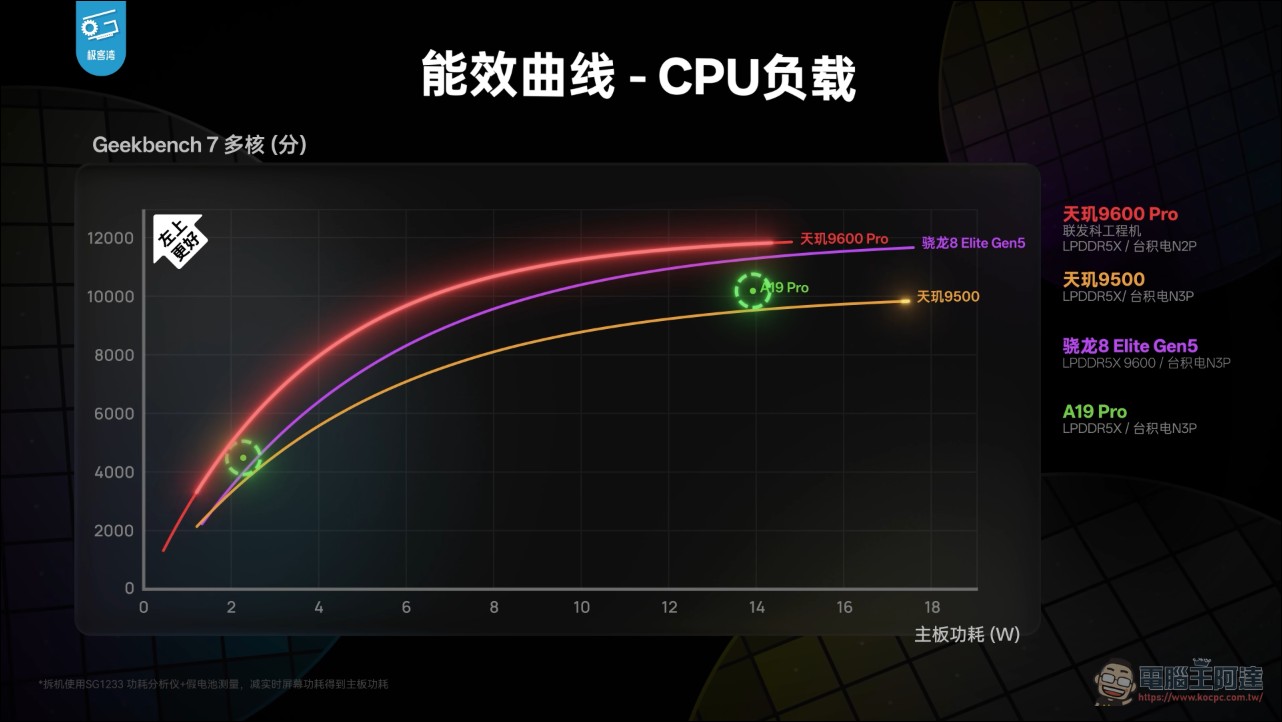
多核功耗下降 61% 是非常顯眼的數字。這代表在相同工作量下,天璣9600 Pro 只需要前代約四成的功耗就能完成,對手機續航與散熱壓力有直接幫助。GB7 首測的領先幅度更大,新架構在更複雜的多核調度場景下優勢更明顯。
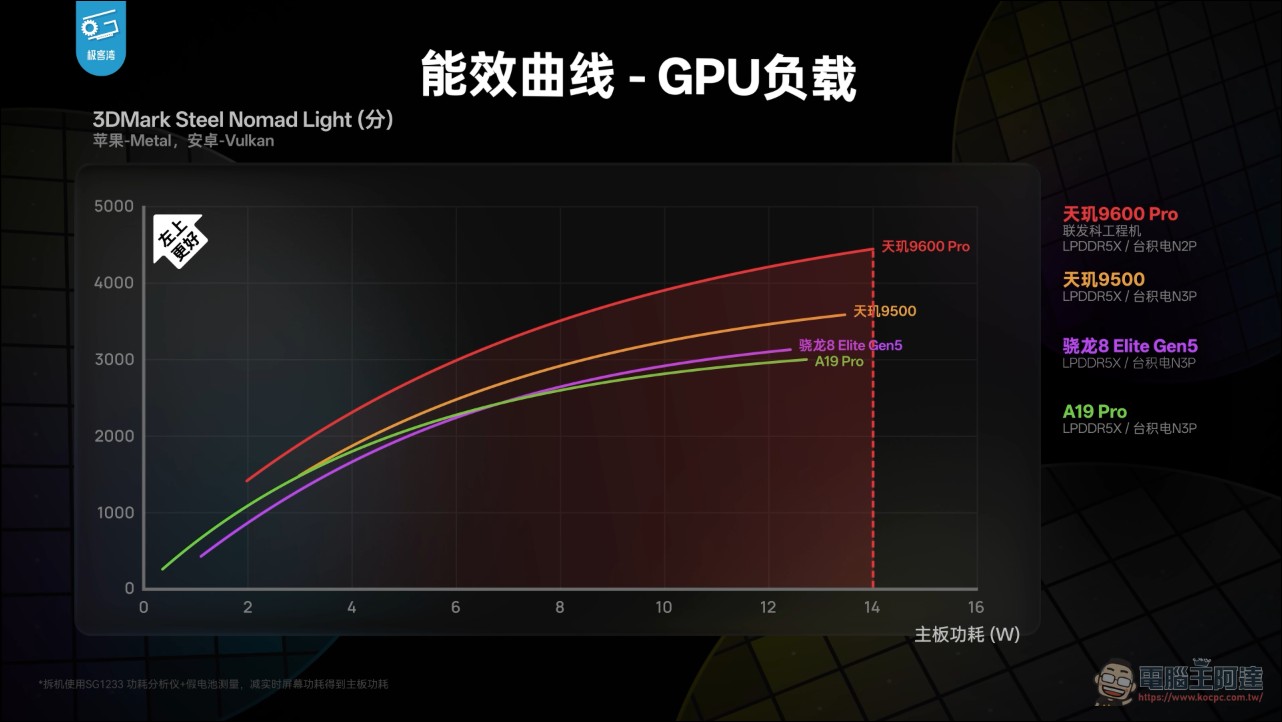
3DMark SNL 能效測試中,峰值接近 4500 分,能效比前代拉開不少距離。極客灣表示「沒想到這代 GPU 進步也不小」,考慮到 G2-Ultra NX 的規模依然是 12 核,但峰值能到這個水準,表現挺猛。這顆 GPU 與小米玄戒 O3 同源架構。
遊戲實測:三款手遊30分鐘穩定度\
極客灣測試了三款遊戲,均以 30 分鐘為基準:
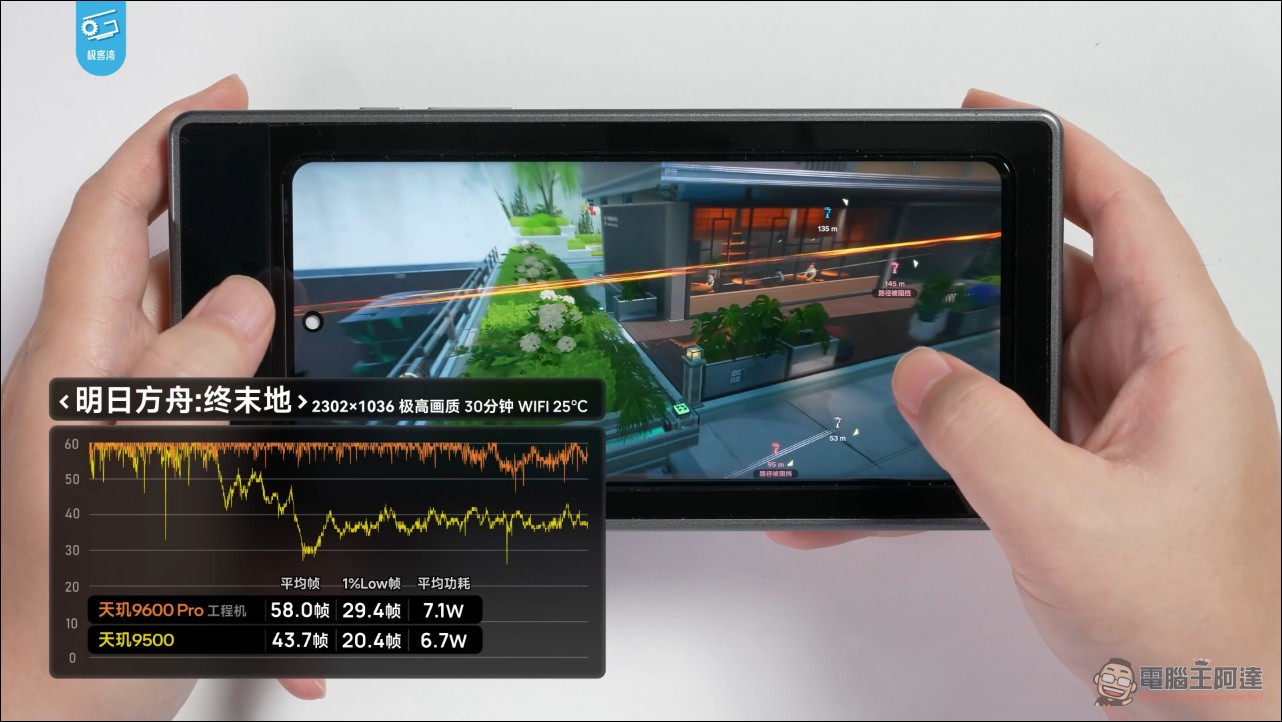
- 明日方舟:終末地(1036P 全特效,武陵城跑圖):30 分鐘平均 58 幀,整機功耗 7.1W,比起天璣9500 機型表現更好
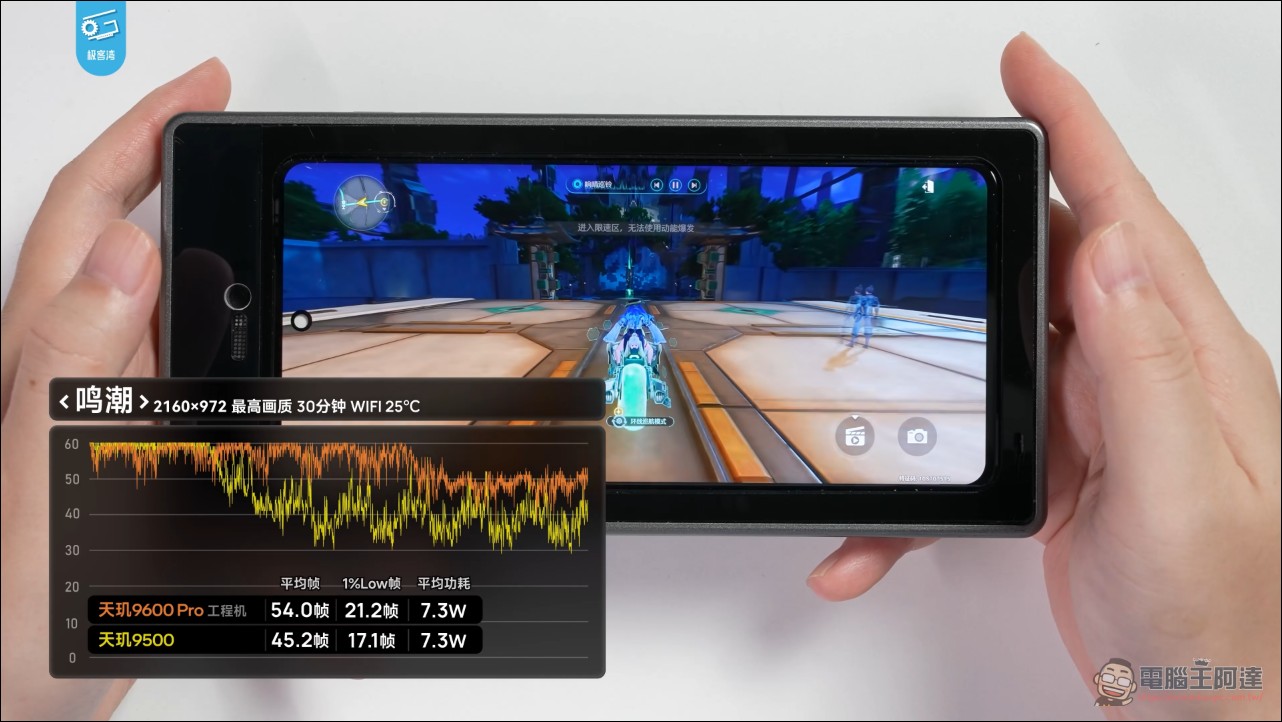
- 鳴潮(972P,玄方城騎摩托跑圖):壓力比先前測試場景大得多,但仍可做到平均 54 幀,整機功耗 7.3W,和天璣9500 比起來「進步相當之大」
- 異環(792P,雨天開車):30 分鐘平均 59.4 幀,功耗 6.4W,同樣比前代更流暢
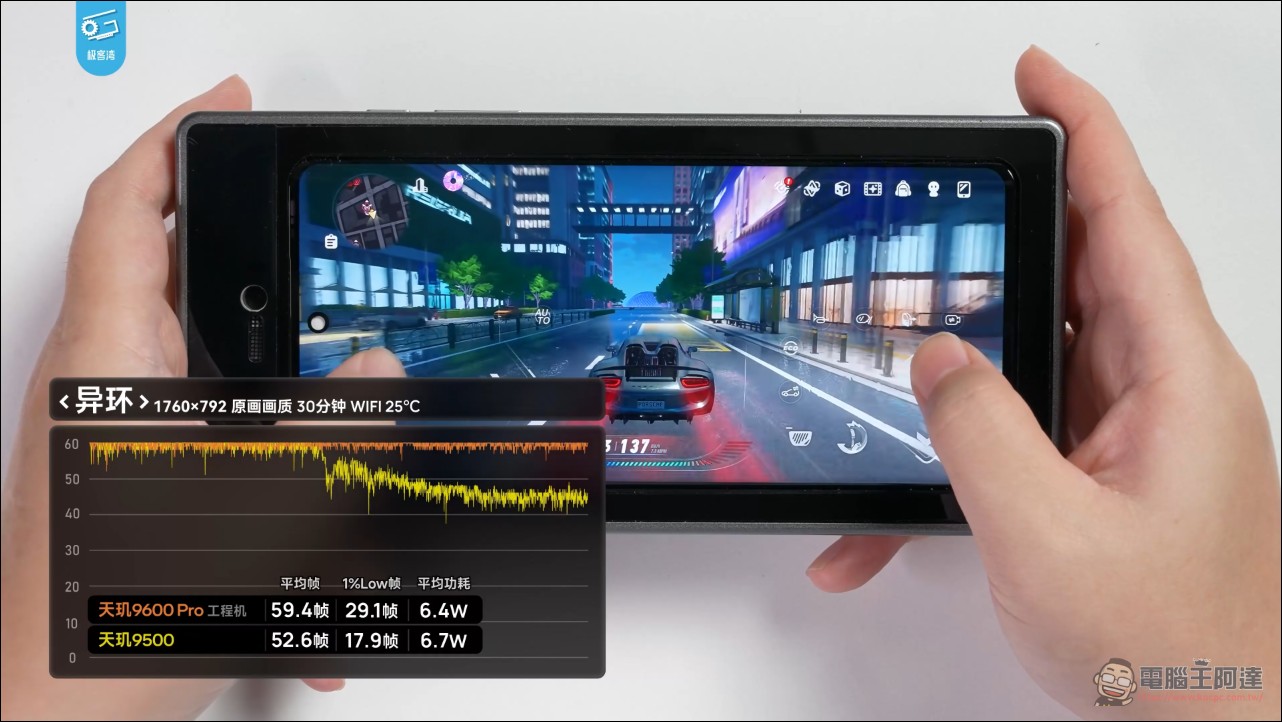
三款遊戲的功耗都在 6.4W 到 7.3W 之間,幀率則維持在 54-59 幀的穩定水準。鳴潮的玄方城場景是壓力最大的測試,天璣9600 Pro 仍能維持 54 幀,代表 GPU 在高負載下的能效確實有明顯進步。
NPU實測:Prefill 5000+ Tokens/秒,為Agent鋪路
極客灣以 Qwen2.5-3B 模型測試 NPU 的 AI 性能,Prefill 速度達到每秒 5000+ Tokens,比上代工程機提升約五成。官方數據顯示 INT4 運算能力翻倍、峰值性能提升 51%、每瓦特生成詞元數提升 55%。此外還配備超能效 NPU,支援超低功耗全時感知,功耗降低 40%。Decode 速度則與前代差不多,同樣每秒約 42 個 Token,功耗從 7W 降至 6.2W。極客灣分析,Prefill 速度直接影響 Agent 讀取指令的等待時間,「Prefill 讀得越快,等待就越短,這算是提前給 Agent 的時代做準備了」。
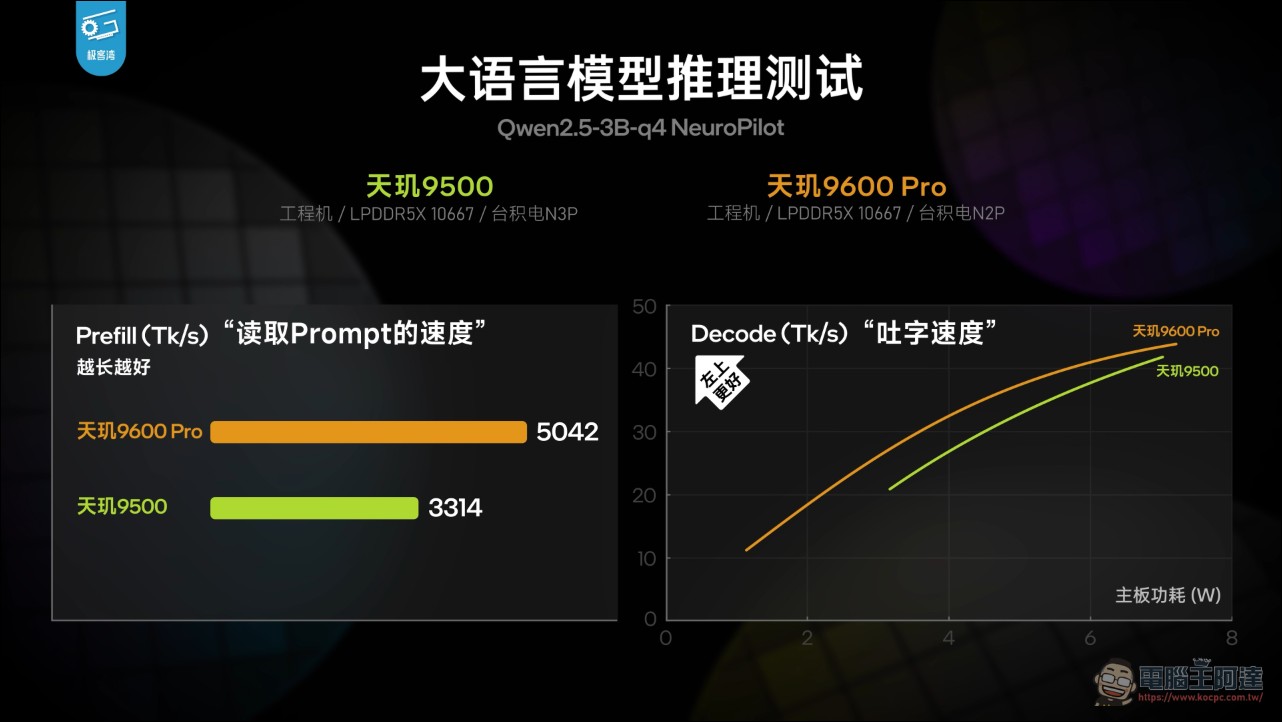
Prefill 提升五成、Decode 維持不變,這個進步方向很明確:聯發科在為端側 Agent 做準備。Agent 需要快速理解使用者指令(Prefill),但生成回應的速度(Decode)受限於模型本身,晶片能做的有限。超能效 NPU 的全時感知能力,則讓手機在待機狀態下也能持續監聽環境觸發 Agent,這是「隨時待命」的硬體基礎。
如果大家對詳細內容有興趣的話,可以直接觀看下面的影片,YT至今還沒上線:
結語:穩扎穩打的2nm敲門磚
極客灣總結,聯發科進入 2nm 時代的這塊敲門磚「比較穩扎穩打」,沒有追求誇張的規模擴充,晶片面積反而縮小。在記憶體漲價的大背景下,要維持手機價格競爭力就必須控制成本,同時帶來穩步的性能升級:CPU 換上雙超大核架構、GPU 換上更強的 G2-Ultra NX、NPU 為 Agent 時代備足算力。