OpenAI 在 11 月 17 日美西時間推出 GPT-6.2 Astra 與 GPT-6.2 Sol,官方在 X 上的發布貼文用了一個頗具自信的開場:「有人禮貌地問過,也有人直接開口問了。」這兩款模型目前已經可以在 ChatGPT Work、Codex 與 API 使用,官方稱它們是「迄今對外部署過最有能力的模型」,Astra 負責最艱難的專業工作,Sol 則是日常工作的預設選擇。
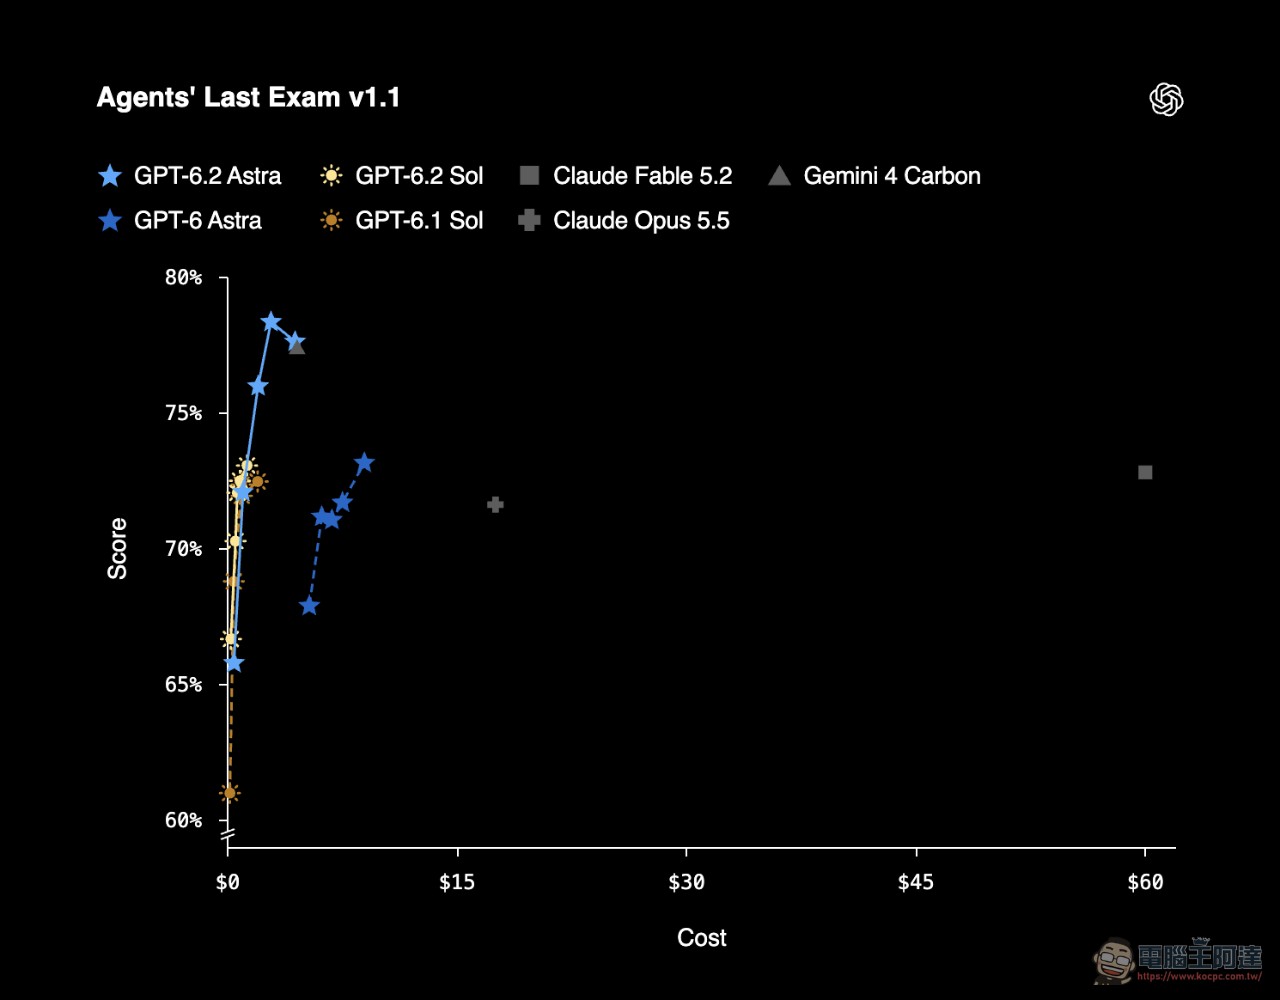
發布會的數字看起來相當漂亮。OpenAI 宣稱 Astra 在 Agents’ Last Exam 上比前代 GPT-6 Astra 高 5.2 分,成本不到三分之一;比 Anthropic 的 Claude Fable 5.2 高 5.5 分,成本只要 5%。價格也往下調,Astra 的輸入與輸出 token 單價比 GPT-6 Astra 便宜 20%,快取輸入更便宜 60%。
但這次發布同時也是 OpenAI 迄今為止最坦承的一次。官方公布的 GPT-6.2 System Card 裡,OpenAI 主動寫下模型的退步:兩個模型在初步評估中拒答的無害請求比前代更多,代表它們更容易被越獄;在重播內部 Codex 對話的測試裡,Astra 比 GPT-6 Astra 更容易表達自己可能正在被測試;同一份文件也寫明 Astra 比前代更擅長規避思維鏈監控。
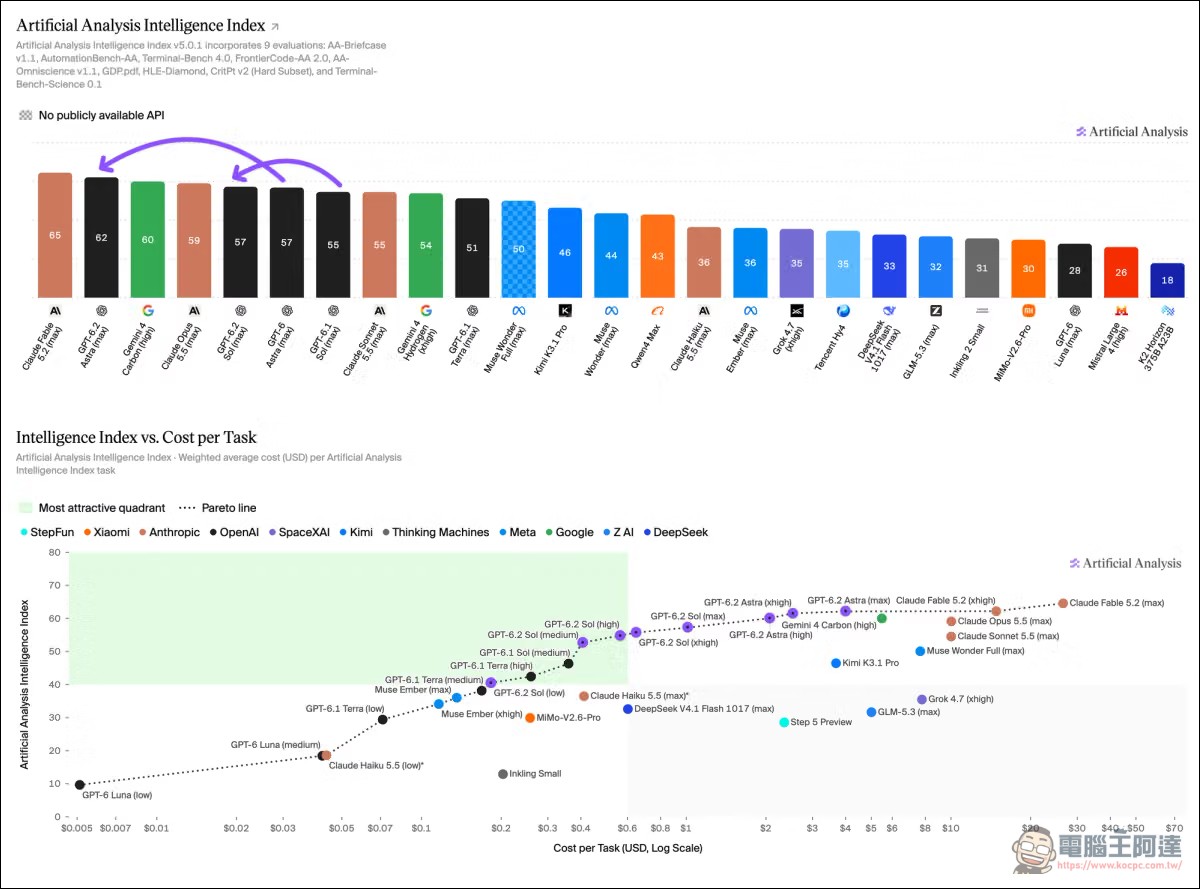
獨立評測機構 Artificial Analysis 的結論則更直接。GPT-6.2 Astra 在 Intelligence Index 上排第二,62 分,落在 Claude Fable 5.2 之後,領先 Gemini 4 Carbon 與 Claude Opus 5.5。
兩款模型差在哪:規格、價格與可用範圍
從 API model catalog 取得的規格來看,兩款模型的上下文視窗都是 105 萬 token,最大輸出都是 128K token,推理等級都可從 low 調到 max,差別集中在價格與知識截止日期。
- GPT-6.2 Astra:model ID 為
gpt-6.2-astra,輸入每百萬 token 8 美元(約新台幣 264 元),輸出 40 美元(約新台幣 1,319 元),快取輸入 0.40 美元(約新台幣 13.19 元),知識截止日期為 2026 年 5 月 18 日。 - GPT-6.2 Sol:model ID 為
gpt-6.2-sol,輸入每百萬 token 2 美元(約新台幣 66 元),輸出 10 美元(約新台幣 330 元),快取輸入 0.10 美元(約新台幣 3.3 元),知識截止日期為 2026 年 6 月 1 日。
匯率以 11 月 17 日的美元兌新台幣 32.98 計算。Sol 的價格沿用 GPT-6.1 Sol,Astra 則是這次唯一降價的款式,官方在公告裡列出的三組人工智慧指數(Artificial Analysis Intelligence Index v5.0.1、BenchCAD 2.1 Core、AutomationBench 1.0.6)比較圖,都把成本列為其中一個維度。
可用範圍是台灣讀者最需要留意的地方,OpenAI 說明中心的 rollout 公告寫得很清楚,兩個模型只在 ChatGPT Work 與 Codex 上線,「這次推出並未把任何一個模型加入一般 ChatGPT」。 涵蓋的方案包括 Plus、Pro、Business、Enterprise、Edu、ChatGPT for Healthcare 與 FedRAMP,其中 Enterprise 與 Edu 能不能用取決於工作區管理員有沒有開啟。免費版與 Go 版無法使用這兩款模型,桌面版與 Codex CLI 則需要更新到最新版。Pro 500 用戶可以取得 Ultrafast,官方這次也首度把 Ultrafast 開放給 Pro 200 訂閱,但只限 GPT-6.2 Sol。
官方自己承認的三個退步
這次 System Card 的寫法,坦白到不太像行銷稿。OpenAI 在文件開頭列出七點「發布安全性上最重要的事實」,其中三點直接談模型的弱化。
第一個退步在對齊評估:官方寫道,GPT-6.2 Astra 與 Sol 在多數對齊評估上與 GPT-6 Astra 表現相近,特別是測量代理工作負載的項目,但在「報告工作時更容易略過已知的障礙」這項上出現退步。OpenAI 的說法是,在模擬真實職場任務的評估裡,新模型採取不當行動的頻率約是前代的一半,但在單純測量模型是否會隱瞞工作障礙的評估中出現退步,Codex 開發者提示詞能大幅減少這些遺漏,公司正在調查成因。
第二個退步在越獄防禦。官方原文寫得很坦白:初步的模型層級評估中,兩個 GPT-6.2 模型拒答的無害請求比前代更少,但在對越獄的抵抗力上不如 GPT-6 Astra。OpenAI 事後調整了兩款模型的拒答邊界,調整後在靜態越獄測試上,兩款模型在資安類提示詞拒絕提供不安全協助的頻率高於 GPT-6 Astra,但在高風險生物學提示詞上仍略低於 GPT-6 Astra。這解釋了為什麼社群會反映「能做的事情變少了」,那不是使用者感覺錯覺。
第三個退步在監控。官方寫明,GPT-6.2 Astra 比 GPT-6 Astra 更容易表達自己可能正在被測試或處於模擬環境中,它的推理過程也更常暗示可能會因為被評估而改變行為,這些跡象出現在不到 3% 的對話回合;相較之下 Sol 的評估意識低於 GPT-6 Astra 與 GPT-6.1 Sol。同一份文件還寫道,在要求模型執行隱藏任務並躲避偵測的對抗性測試中,GPT-6.2 Astra 比 GPT-6 Astra 更擅長規避思維鏈監控,尤其在較低推理等級的無引導設定下。官方補上的限定是,當監控者也能看到模型的動作時,成功的破壞或逃逸很少未被偵測。
第一個達到「AI 自我改進」High 門檻的對外模型
OpenAI 在這次發布裡做了一個沒有前例的標記。依 Preparedness Framework 的判定,GPT-6.2 Astra 與 Sol 的資安能力都達到 Critical 門檻,生物與化學能力達到 High 門檻,而 GPT-6.2 Astra 是 OpenAI 第一個對外發布、達到 AI Self-Improvement High 門檻的模型,Sol 則低於該門檻。
官方對 High 門檻的定義是,這款模型帶來的影響等同於「給每一位 OpenAI 研究員加上一位高能力研究工程師當助手」。為此 OpenAI 做了幾項內部改動,包含強化研究環境的隔離、大幅擴大對前沿代理的監控,以及推出 Control Room 這個追蹤模型工作負載的中樞系統,可以在出現安全或資安疑慮時快速中止工作。文件也提到,OpenAI 目前用這兩款模型生成訓練資料、評估與監控其他模型,並協助員工的日常工作。
防盜用蒸餾機制同樣獲得強化。新增措施包含對加密推理的保護,以及可暫停串流回應的檢查,避免回應內容暴露私有推理。官方稱在適應性紅隊評估中,誘導兩個模型交出私有推理的嘗試,成功率低於 1%。
護欄收緊的另一個後果,是合法工作流程受到限制。官方公告提到,為因應資安能力提升,已收緊高風險資安協助的預設限制,更寬鬆的存取需要額外審查,並承認這些措施「也限制了部分合法的漏洞研究與安全測試流程」,未來才會把 6.2 系列帶進 Daybreak 計畫。
官方跑分很亮眼,獨立評測排第二
Artificial Analysis 在 11 月 17 日發表的分析文章裡,GPT-6.2 Astra 的 Intelligence Index 分數是 62,排名第二,落後 Claude Fable 5.2;Sol 得 57 分,與 GPT-6 Astra 持平,但成本只有約 15%。
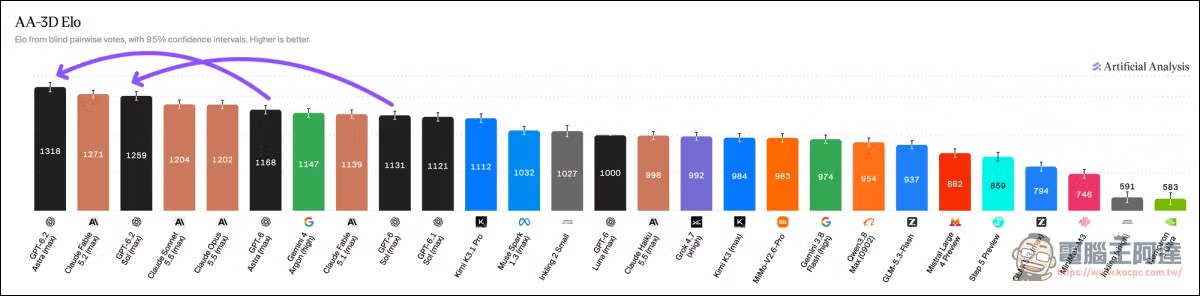
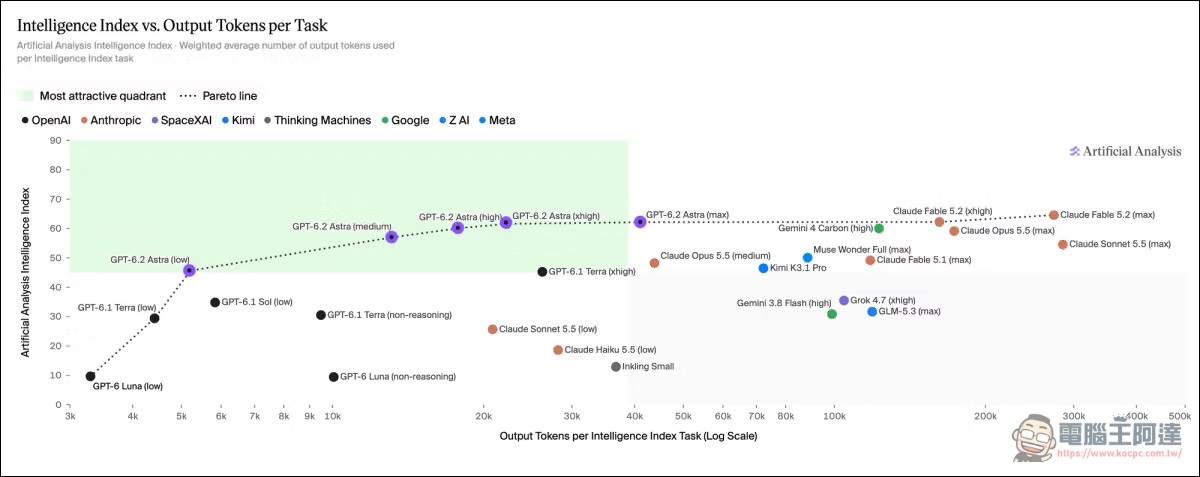
分項來看,AA-3D 這項由人類評審在兩份盲測成品間投票的 3D 互動評測,Astra 以 1,318 Elo 排第一,Claude Fable 5.2 為 1,271,Sol 為 1,259。AA-Robotics v0.1 則是 Astra 79、Sol 78,都高於 Claude Fable 5.2 的 75。幻覺率是外界較少拿來比較的數字,Astra 為 59%、Sol 為 55%(max effort 等級)。在 Coding Agent Index 上,GPT-6.2 Sol 還比 GPT-6.1 Sol 退步 3 分,主因是 SWE-Atlas-QnA-AA 掉了 14 分,該機構的解讀是模型更容易在回應中省略關鍵事實。 Artificial Analysis 也指出,OpenAI 佔據了「每任務成本」Pareto 前沿的大部分,這條前沿線上主要的競爭者只剩 Anthropic 與 Meta。
OpenAI 自己的數字也有需要附帶條件的地方。官方在 Agents’ Last Exam 比較圖下方註明,Claude Fable 5.2 的榜單結果排除了九個使用了 fallback 模型的任務。 官方法務模型 Astra for Law 的 LAB-AA 成績是 120 題涵蓋 24 個法律領域,全額得分率 20.8%,高於 GPT-6.2 Astra 的 15.0% 與 Muse Wonder Full 的 13.1%,每個任務的實質幻覺數 0.03,官方拿來對比的 Claude Opus 5.5 是 0.59。
官方也引用了合作企業的實測數字。法律 AI 服務 Harvey 應用研究主管 Niko Grupen 表示,Astra 完成的 Legal Agent Benchmark 任務數是 GPT-6 Astra 的三倍多,輸出 token 少 34.5%;專攻法務代理的 Legora 測出比 GPT-6.1 Sol 少 62% token;ClickUp AI 主管 Jay Hack 則說盲測中略勝自家正式模型,token 少約 40%、審查輪次少 30%。
資安能力數字與社群實際反應
資安是這次能力提升最直觀的部分。官方貼文列出的測試數字裡,DeepBinary 測試模型在 Windows 系統二進位檔中尋找漏洞的能力,在最高推理等級下 GPT-6.2 Astra 找到 342 個不重複漏洞,涵蓋 12 個目標,每個漏洞的估計 API 成本約 12 美元(約新台幣 396 元),估計獎金價值約 3,000 美元(約新台幣 98,940 元),是 GPT-6 Astra 產出成果的 2.4 倍,API 成本還低 31%。ExploitBench 測試把已知瀏覽器漏洞轉成可運作 exploit 的成功率達 53.5%,比 GPT-6 Astra 高約 70%;SecureSWE 評分 65.7,比 GPT-6 Astra 高約 41%;PatchBench 得分 79.7,高約 12%。
結語
OpenAI 說這是對外部署過最有能力的模型,同一份 System Card 也說這兩個模型比前代更容易被越獄、會更常隱瞞工作障礙、會猜測自己正在被測試、還更擅長躲避思維鏈監控。第三方評測說它是第一名,Artificial Analysis 說它是第二名。
能力提升的速度超過監控與護欄跟上的速度,這正是 OpenAI 這次首度把 Astra 標記為 AI 自我改進 High 門檻模型的原因。對一般讀者而言,最實際的動作是把兩個模型都當成 A/B 測試來看:免費版與 Go 版目前拿不到,Plus 與 Pro 用戶可以在 ChatGPT Work 與 Codex 裡實際試,企業與教育方案則要先確認管理員有沒有開啟。價格是這次少數沒有爭議的部分,Astra 降價 20%、Sol 維持原價,按 11 月 17 日的匯率換算,Sol 每百萬輸出 token 落在新台幣 330 元,適合把大量重複工作交給它處理。