Google 一年之內推出四套 TPU 系統,這是 TPU 十年歷史上頭一遭。今日 Google AI 與基礎設施部門負責人 Amin Vahdat 在 X 上宣布,第八代 TPU 產品線再加兩款:TPU 8i Max 標榜最大的上下文視窗與單機櫃最高運算密度,TPU 8tx 則鎖定安全與機密推理。加上今年 4 月 Google Cloud Next 發表的 8t 與 8i,第八代共有四套系統,Google Cloud 官方也用一則貼文把四套系統的定位並列。
新晶片 vs 新系統
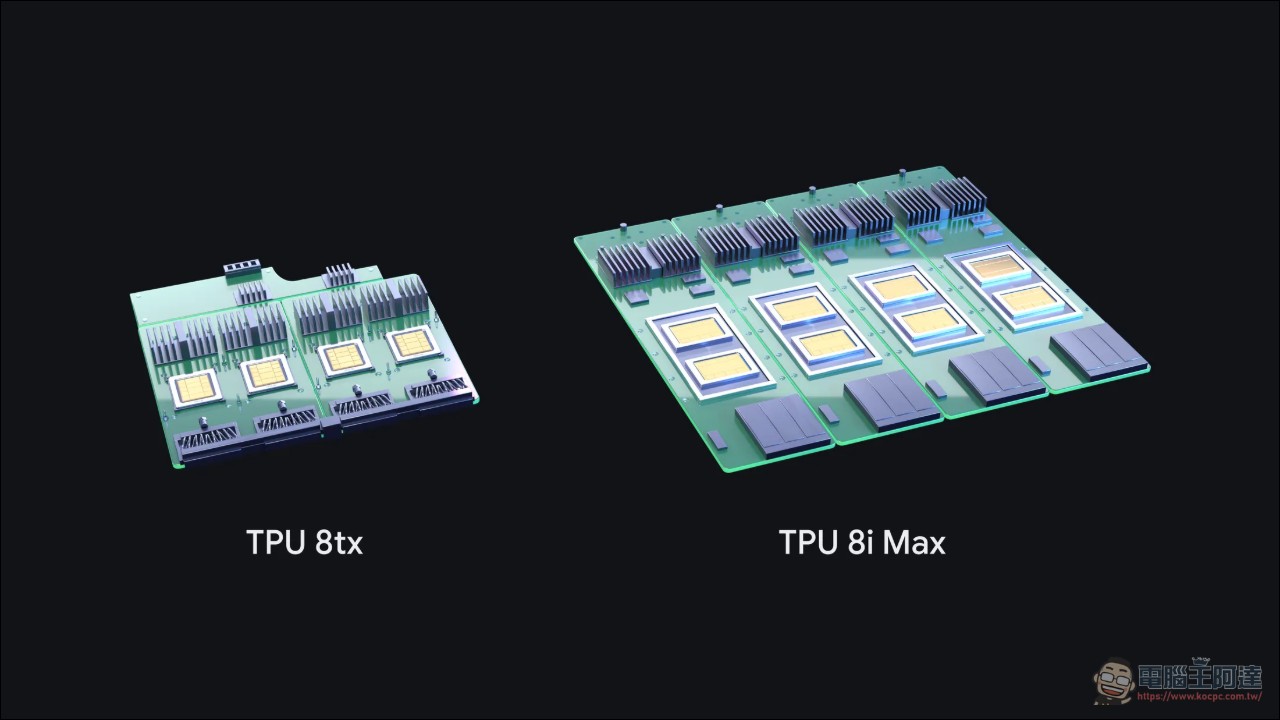
Google 在官方部落格寫道:設計一顆新晶片,是在晶圓上佈局數十億個電晶體,受限於物理定律與漫長的製造週期,一做就是好幾年;設計一套新系統,則是決定運算、網路與儲存要怎麼圍著這顆晶片組裝,包括封裝方式,可以快速因應新出現的客戶需求。其中 8tx 是「built on the same silicon as TPU 8t」,也就是沿用 8t 的晶片;8i Max 是「two low-latency TPU 8i chips … onto a single package」,兩顆 8i 封在同一個封裝裡。
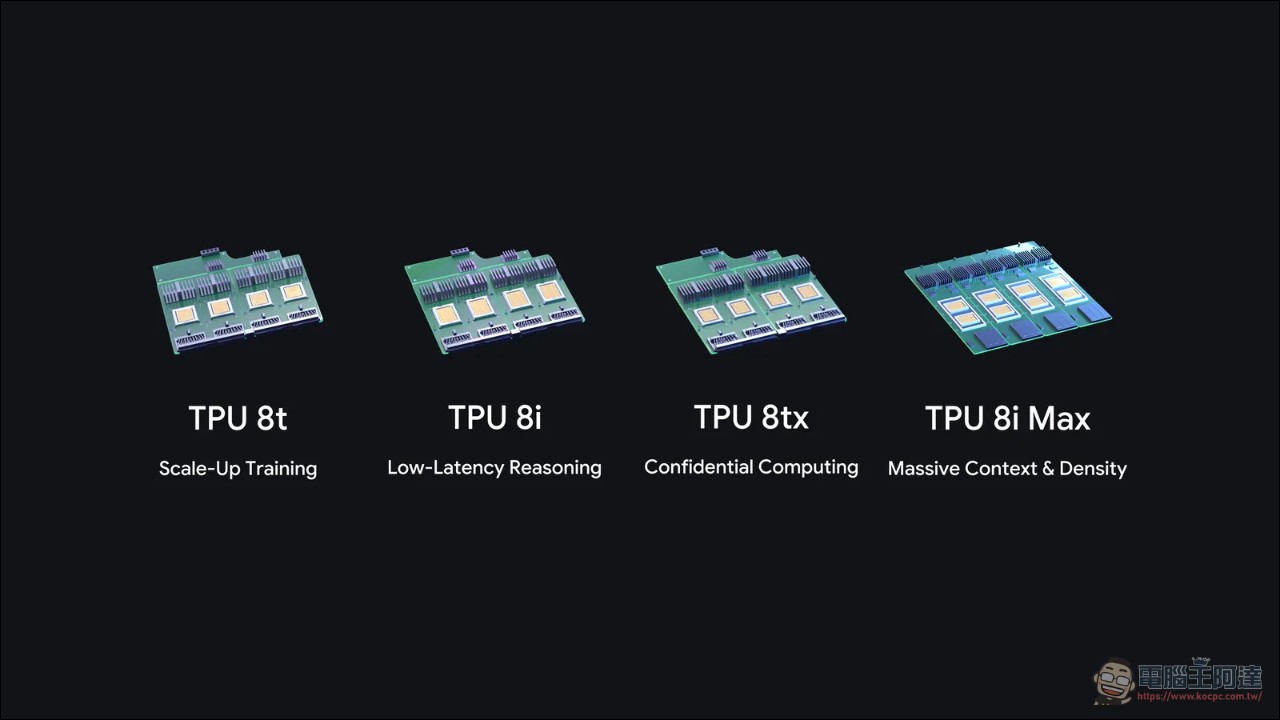
四套系統底下其實是兩顆晶片。Google 這一年做的事,是把同一套矽晶片用不同的封裝、記憶體、網路與安全配置,快速組出四種針對不同工作負載的機器。Google 自己的說法是,這種做法能在幾個月而不是幾年內交出專用超級電腦。
8i Max:兩顆 8i 封在一起
TPU 8i Max 解決的是記憶體牆。當數十個 AI 代理同時處理整個程式碼庫或數小時的影片時,記憶體頻寬很快就會變成瓶頸。做法很直接:把兩顆低延遲的 TPU 8i 封進同一個封裝。運算、SRAM 與 HBM 頻寬同步翻倍,處理器才不會因為拿不到資料而停擺。而且因為在既有的機櫃空間裡塞進兩倍的矽晶片,資料中心每平方呎、每瓦的運算量都能明顯提升。
定位上,8i Max 對應的是百萬 token 等級的上下文視窗。這個需求來自代理式工作負載:多個 AI 代理要同時橫跨整個程式碼庫或長時間的影片進行推理,傳統的記憶體配置撐不住。作為基準,4 月登場的 8t 與 8i 當時給出的數字是訓練效能最高提升 2.7 倍、推理 CP 值改善 80%。
8tx:機密推理,但有個前提
TPU 8tx 的訴求是硬體層級的機密運算。一般情況下資料在儲存或網路傳輸時會加密,但電腦處理時必須在記憶體裡解開;8tx 要做到的是連正在使用中的資料與模型權重都能保持保護與隔離。
規格上,8tx 沿用 8t 晶片,搭配第 5 代 AMD EPYC 處理器主機,並採用 8i 那套低延遲的 Boardfly 網路。官方數字是相較 8t 延遲最多降低 2 倍,效能損失接近於零。這樣的組合讓企業可以在同一套系統上用自己的私有資料微調模型、把大模型蒸餾成小模型、用強化學習訓練代理,不必在不同叢集之間搬運敏感資料。
軟體才是這次的重點
Vahdat 在貼文裡寫得很直白:「硬體有多好,取決於軟體堆疊有多好。」這次公告裡軟體的篇幅其實比硬體多。TorchTPU 上個月開源,PyTorch 程式碼與 Hugging Face 模型現在可以原生跑在 TPU 上,不必改寫程式碼,vLLM 與 SGLang 這些主流開源推理引擎也有開箱即用的 TPU 後端。
TPU Sync 是這次技術含量最高的一項。它是 TPU 叢集的模型狀態層,把晶片 HBM、主機 DRAM、共用儲存與資料中心網路整合成單一的記憶體階層,能在毫秒級把大型 KV 快取移出晶片、在分離式 prefill 與 decode 節點之間串流上下文、同步強化學習權重。官方數字是 KV 傳輸延遲與首字元時間(TTFT)降低超過 90%。
Agent Compute Engine 則針對代理式工作負載的特性:AI 代理是有狀態的,經常會停下來等資料庫查詢、外部工具或人工回饋,一停就是幾秒到幾小時。這套軟體會自動暫停閒置的代理工作階段,在毫秒級把工作記憶體移出晶片,降低運作成本。
另外還有 XLA Serving Engine(Python 訓練、C++ 低延遲執行,跨 TPU/GPU/CPU)、TPU 代理套件(可接 Claude Code、Cursor 與 Google Antigravity,用自然語言自動完成 TPU 上手、瓶頸診斷與核心調校)、Cloud Pathways 與 GKE 動態切片(用光電路交換即時組裝或切割 TPU 拓撲,作業啟動時間最多縮短 5 倍,故障復原最多加速 4.5 倍)。
客戶與市場反應
Google 表示 TPU 已是快速成長的業務,擁有近 100 個客戶,涵蓋前沿實驗室、交易商、零售商與大學。效能方面則宣稱在 InferenceX 與 AgentX 兩個產業基準測試上,原生 vLLM-TorchTPU 堆疊拿下最佳 CP 值。
社群的反應則是另一種聲音。有網友直接問:「晶片做得更好了,可是 AI 模型的價格反而變得更貴?」也有人關心這是否能改善 API 長期以來的過載錯誤問題,以及「新的模型在哪裡」。
結語
Google 這一年的 TPU 策略有個清楚的邏輯:晶片迭代慢、系統組裝快,那就把創新重心放在系統層。四套系統對應訓練、低延遲推理、機密運算與超大上下文四個階段,等於把代理的整個生命週期各配一顆專用加速器。
對開發者而言,門檻一直落在遷移成本,規格數字反而是其次。TorchTPU 讓 PyTorch 程式碼不用改寫就能上 TPU,這件事動的是要不要用 TPU 的決策,影響比任何一個倍數數字都大。想實際評估的團隊可以直接從 Google Cloud 的 TPU 產品頁查可用配置。
資料來源:Our newest TPUs