NVIDIA 今年 5 月底在台北 GTC Taipei 發表 RTX Spark 超級晶片,把 20 核 Grace CPU、6,144 個 CUDA 核心的 Blackwell GPU 與最高 128GB 統一記憶體封進一顆 SoC,官方定位就是「個人 AI 電腦」。四個月過去,首批 RTX Spark 筆電終於上市。聯想 YOGA Pro 15 RTX Spark 是全球首批搭載 N1X 超級晶片的機型之一,中國筆吧評測室拿到滿配版本,把本地 AI、創作與遊戲三個主戰場表現全測了一遍,相信能讓想入手這台筆電的朋友可以作為選購參考。
N1X 晶片解析:DGX Spark 的 Windows 孿生兄弟
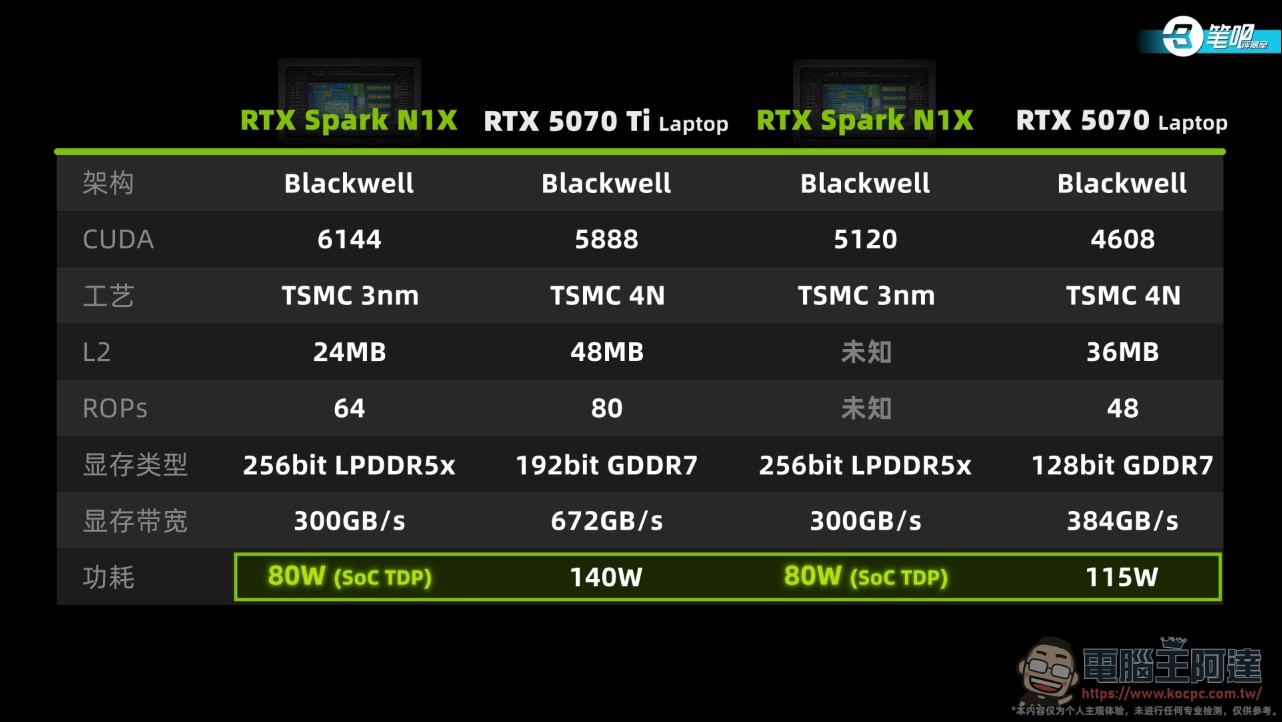
目前上市的 RTX Spark 都是第一代 N1X 晶片,CPU 與 GPU 分成兩個 die,都採台積電 3nm 製程。它有兩種配置:高階版是 20 核 CPU 加 6,144 CUDA GPU,標準版是 18 核 CPU 加 5,120 CUDA GPU;20 顆 CPU 核心由 10 顆 Cortex-X925 與 10 顆 Cortex-A725 組成,18 核版本各砍一顆、P 核頻率也略低。
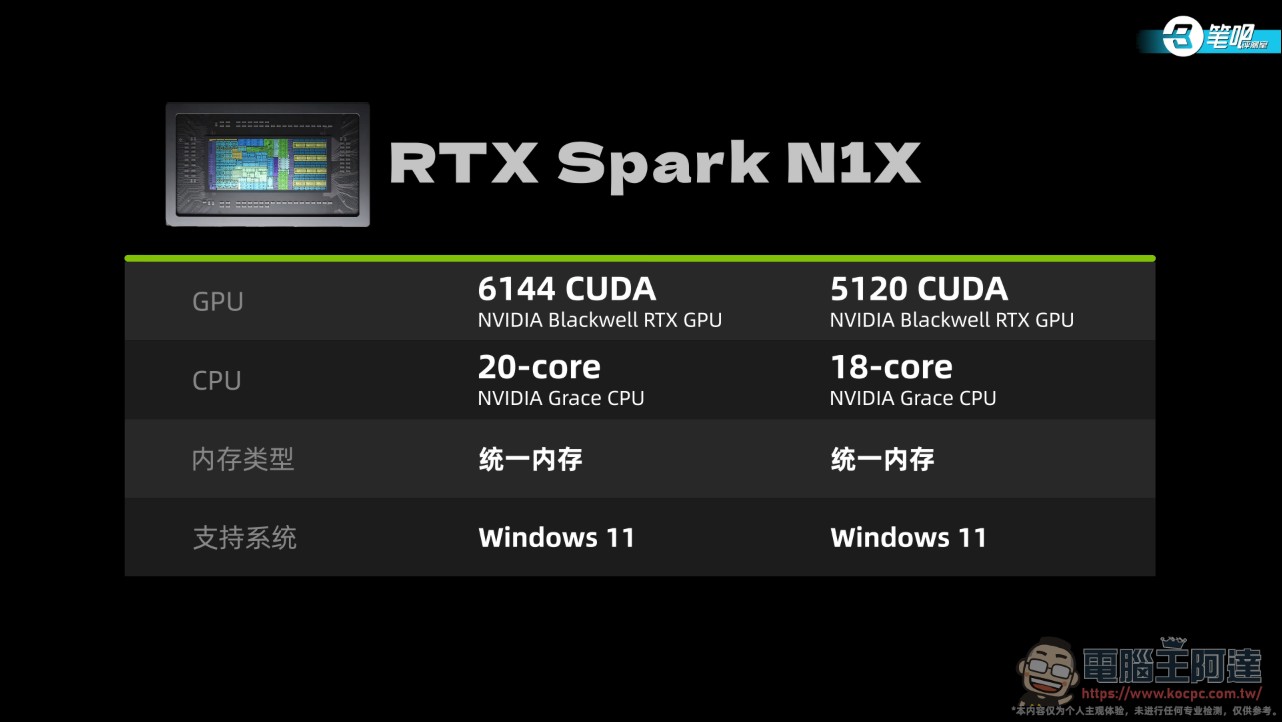
記憶體部分高階版 24 至 128GB、標準版 24 至 32GB,標準版只出現在筆電上。GPU 規模介於筆電版 RTX 5070 Ti 與 5080 之間,5,120 CUDA 的版本則落在 5070 與 5070 Ti 之間。聯想也宣稱這台機器可本地執行超千億參數大模型,出廠就內建 35B 模型開箱即用。
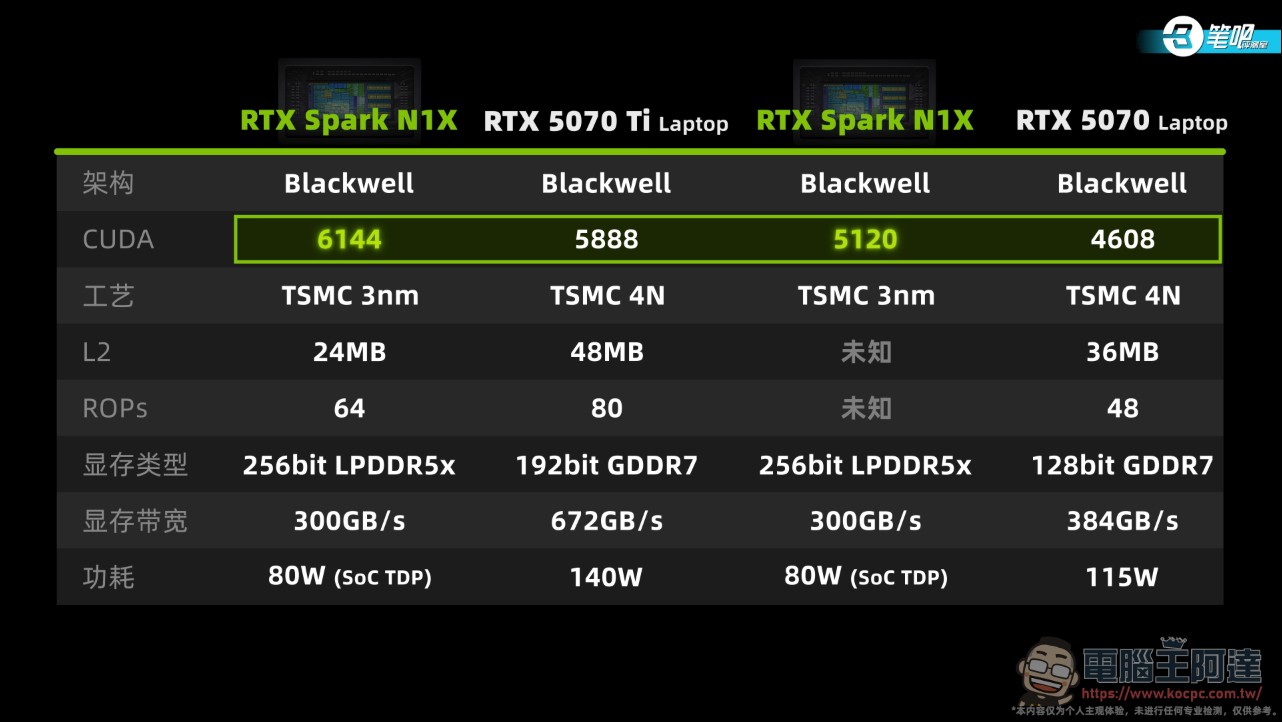
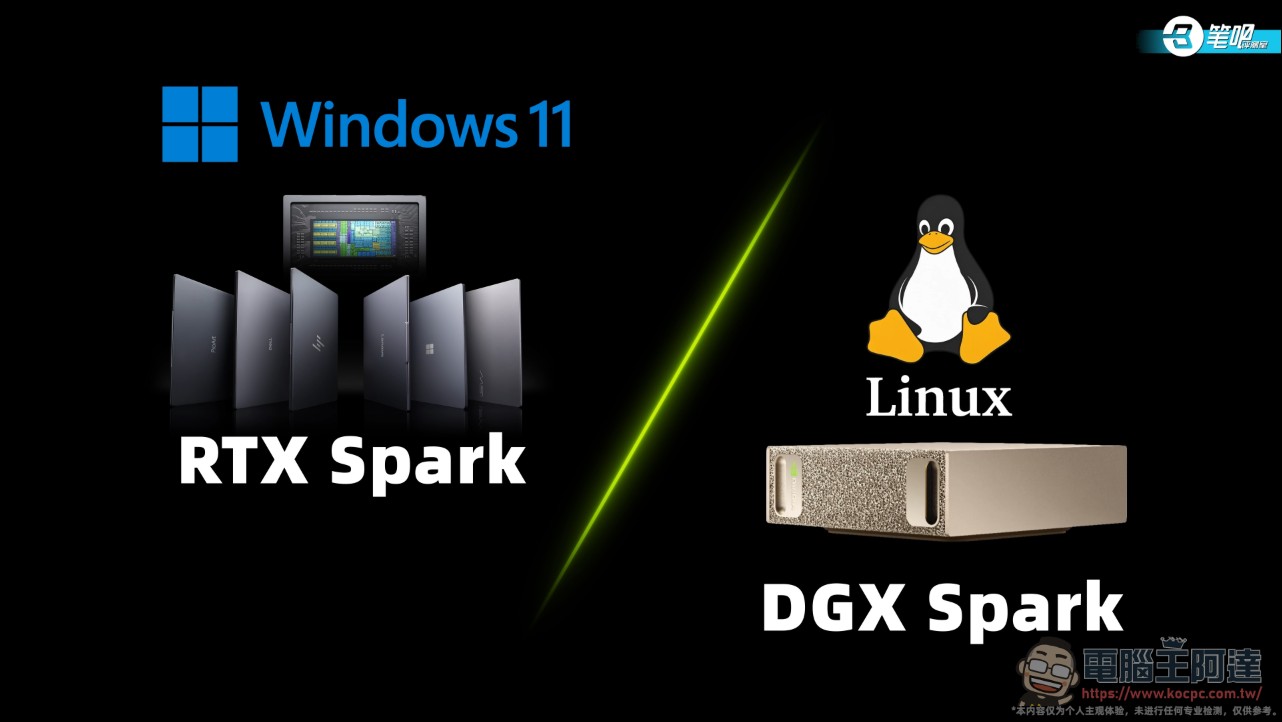
規模給得大方,但影片點出幾個體質限制:L2 快取與記憶體頻寬都低於 RTX 50 系筆電 GPU,ROPs 數量比 5070 Ti 還少,最大的差異在功耗,80W 是包含 CPU 的 SoC 總功耗,實際分給 GPU 的更少。看得出來,這個架構就是 DGX Spark 迷你主機那顆 GB10 的雙生版本:DGX Spark 跑自家 DGX OS、定位小型伺服器,RTX Spark 裝 Windows 11、瞄準個人電腦用戶。CPU 設計有 MediaTek 參與,主打功耗效率與連線能力。
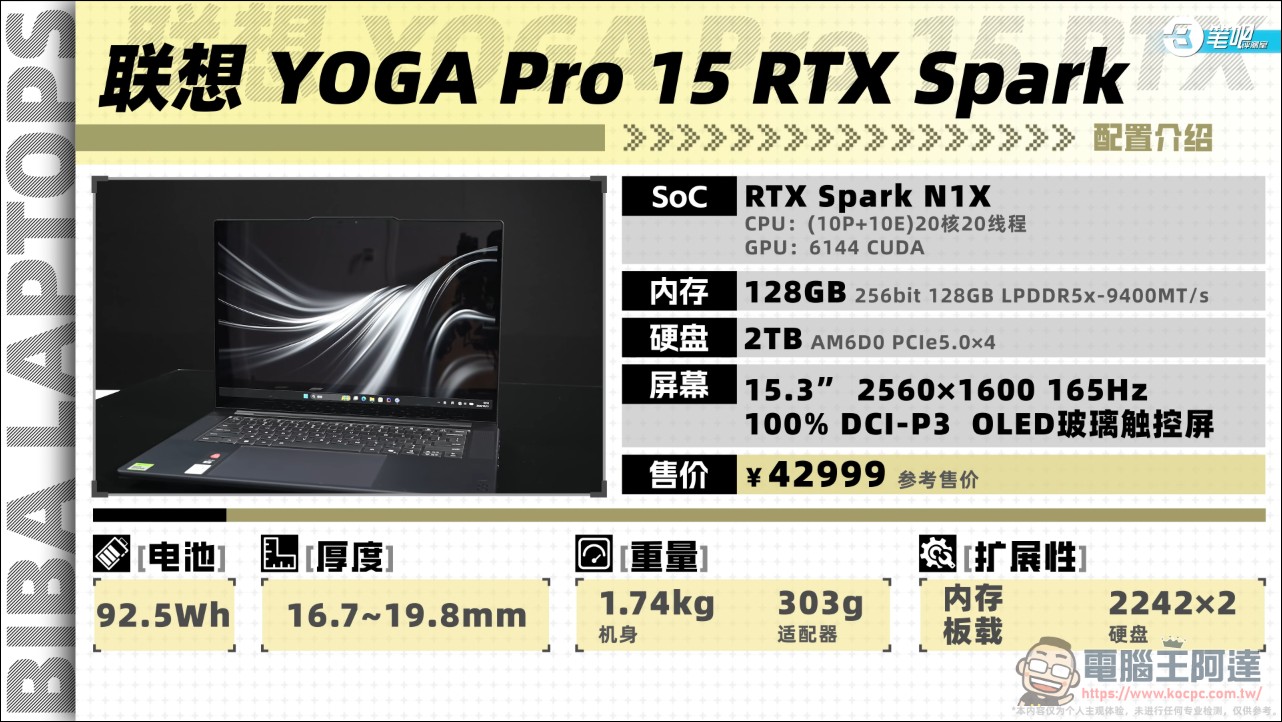
這次的測試機是聯想 YOGA Pro 15 RTX Spark 滿配版:20 核 CPU 加 6,144 CUDA 的 N1X、256bit 128GB LPDDR5x-9400、2TB 憶聯 AM6D0 PCIe 5.0 固態硬碟、15.3 吋 1600P 165Hz 廣色域 OLED 鏡面螢幕,售價 42,999 人民幣,估算約新台幣 20.8 萬元。
GPU 與遊戲實測:帳面規模對不上跑分
直接看 3DMark:在 ARM 原生的 Steel Nomad Light 中 N1X 跑出 13,752 分,沒贏過規模比自己小 25% 的 5070,只強於 5060;到了需要轉譯的 Time Spy 與 Fire Strike Extreme,綜合起來只比 5060 強 2%,幾乎在誤差範圍內,而 5060 的規模只有 N1X 的 54%。
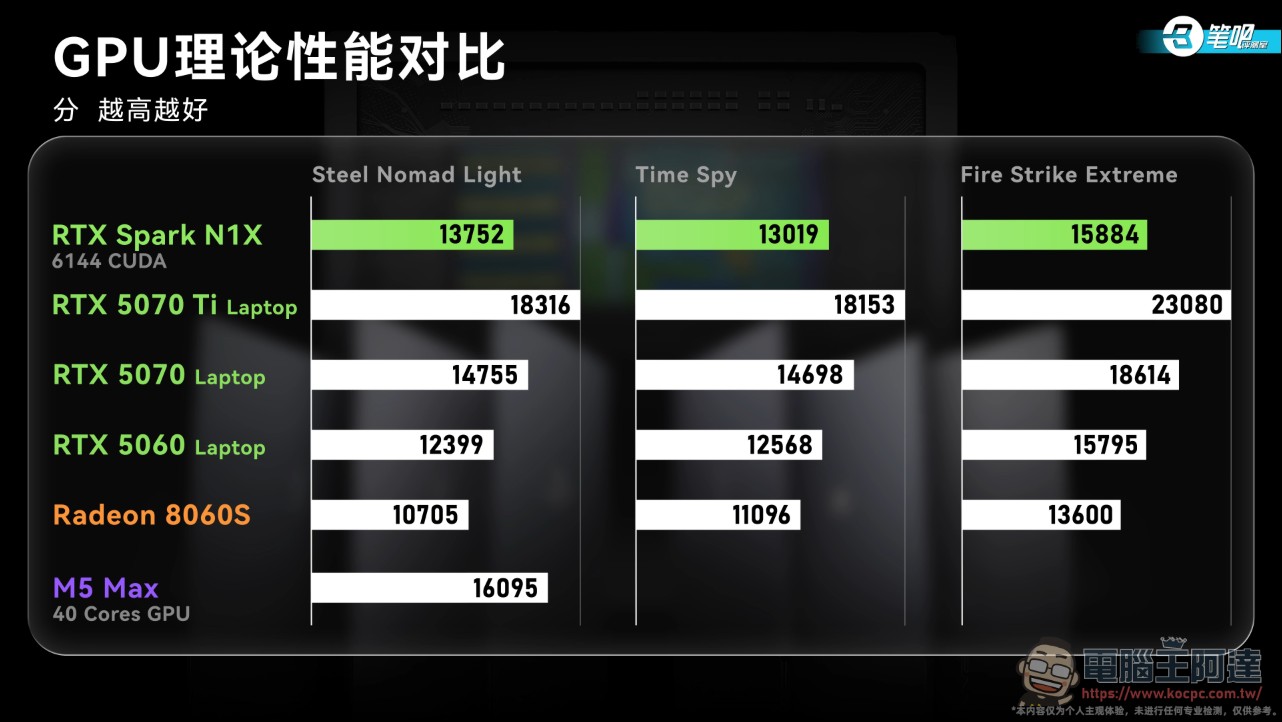
會有這種表現的主因是由於記憶體頻寬、L2 快取的先天差距,加上 80W 的 SoC 功耗牆;從 Steel Nomad Light 能效曲線看,80W 以下 N1X 的跑分高於 5070,只是 SoC 功耗與獨顯 GPU 功耗的計算口徑不完全一致,成績僅供參考。
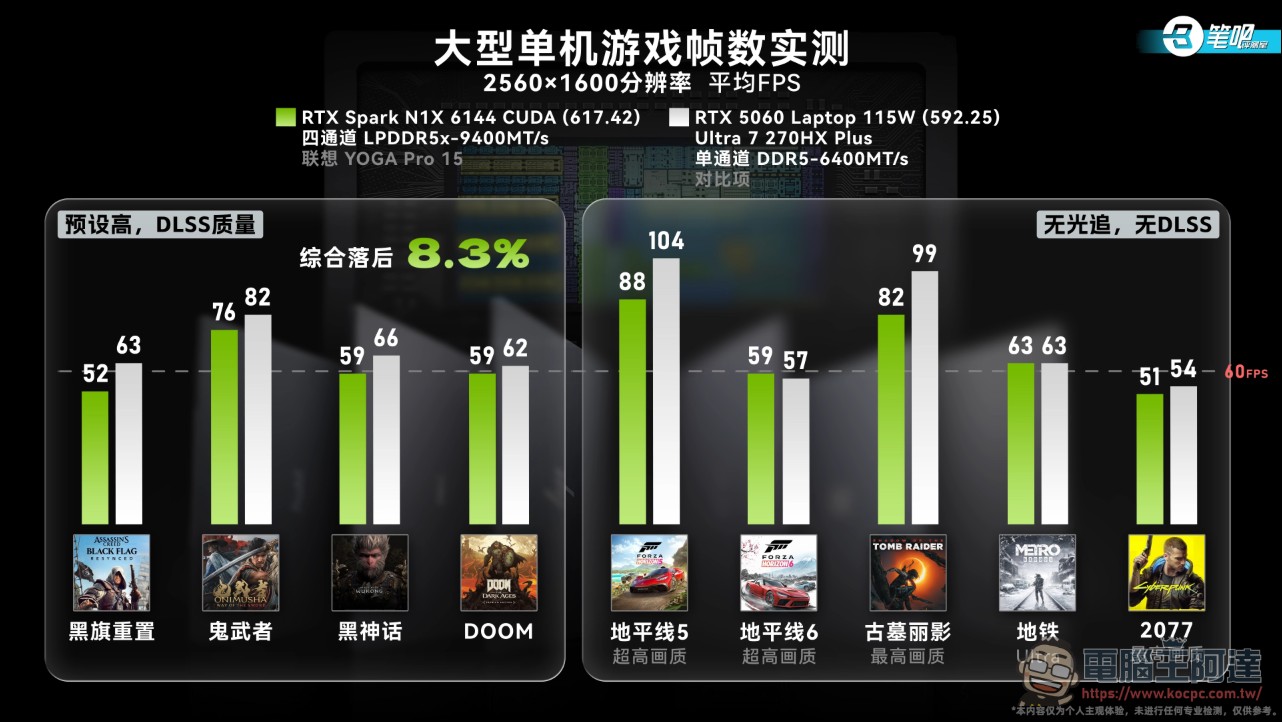
實際遊戲裡,大多數單機遊戲跑得起來,但幾乎都需要轉譯。GPU 型號與驅動能正常識別,CPU 因為轉譯只顯示虛擬 CPU;9 款遊戲實測平均落後 5060 遊戲本 8.3%,只有《極限競速:地平線 6》以 2 幀領先,吃 CPU 的《古墓奇影》落後幅度高達 17.2%。
競技類遊戲就從「幀數低」變成「能不能玩」。16 款實測中,英雄聯盟、三角洲行動、鳴潮、穿越火線、洛克王國 5 款尚未支援;終末地與絕區零進得了遊戲但無法流暢執行;正常遊玩的有 9 款:崩壞:星穹鐵道、原神、異環、特戰英豪、Minecraft、鬥陣特攻 2、太空戰士 14、全面戰爭:戰鎚 3 與 CS2。其中 Minecraft 是原生 arm64 版本,能跑到 1,000 幀以上;英雄聯盟、三角洲、鳴潮、終末地都有原生支援 RTX Spark 的計畫。4 款網路遊戲綜合落後 5060 遊戲本 44.7%,越吃 CPU 的項目表現越差。所有幀數都至少測兩遍,因為轉譯的遊戲首次啟動會嚴重卡頓,跑過一次有快取後才正常。
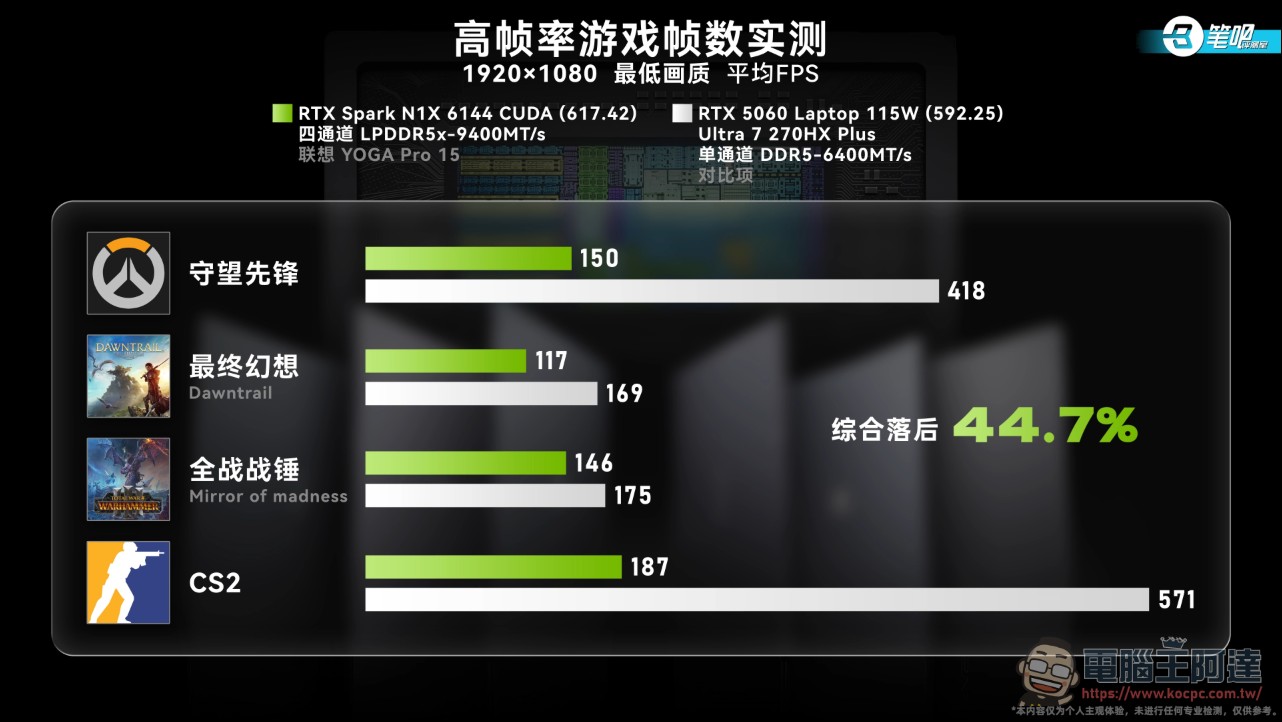
對照 NVIDIA 官方宣稱 RTX Spark 能以 1440p、100 幀以上跑 3A 遊戲,實測的落差主要來自轉譯層的代價,而非晶片本身跑不動。DLSS 與光追這些特性在測試全程倒是沒遇到問題。這是 Windows on ARM 現狀的縮影:原生表現亮眼(Minecraft 1,000 幀),轉譯處處打折。N1X 的 GPU 規模沒有兌現成跑分,7 成原因在功耗與頻寬體質,3 成在生態還沒跟上。
本地 AI 實測
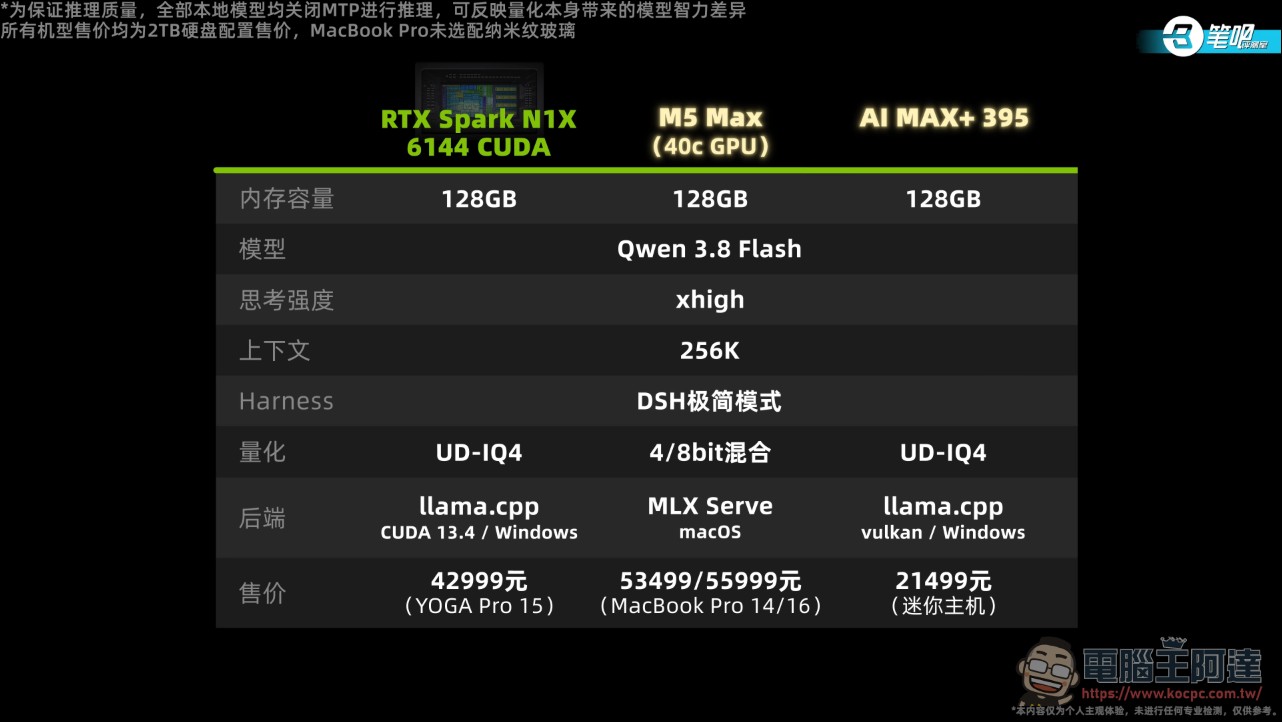
影片認為沒有人買 RTX Spark 是為了打遊戲,它的主場是本地 AI,所以測試設計也最重本:從 Terminal Bench 挑出 49 個真實 Agent 任務,涵蓋軟體工程、網路安全、系統管理、資料科學、科學計算、日常資料處理與環境除錯,其中不乏需要連續執行一小時以上的長程任務,單次測試超過 20 小時。參賽者除了 RTX Spark,還有同樣配 128GB 記憶體的 M5 Max 與 Ryzen AI MAX+ 395,各自用自家平台主流的量化方案與後端;另外在 Qwen AI 平台開通雲端方案,用全精度的 Qwen 3.8 Flash當雲端對照組。
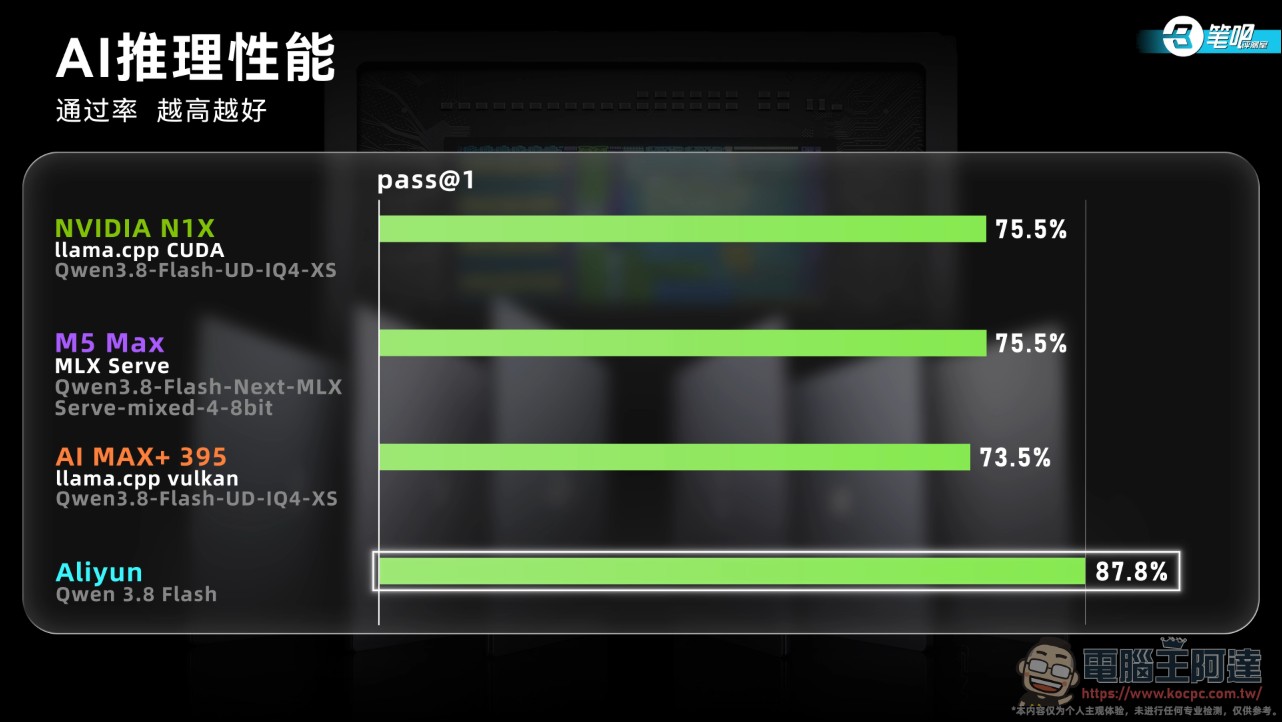
通過率方面,沒量化過的雲端模型表現顯著高於三台本地機器。量化模型的精度損失理論上不大,但在長程任務裡會積少成多:例如設計 DNA Q5 突變引物的任務,本地模型沒仔細讀題目的切分方式就用自己的口徑驗證;洛倫茲擬合拉曼峰的任務陷入思考空轉直到超時,從頭到尾沒進入擬合階段。也有很可惜的失敗:逆向光線追蹤器任務已在實驗副本修好並驗證通過,卻沒來得及把程式碼拷回去;建置 PyPI 服務的任務功能全對,但把服務開在智能體會話內,驗證程式讀不到。這類失敗只要多重做一次或多給提示,都很可能通過。
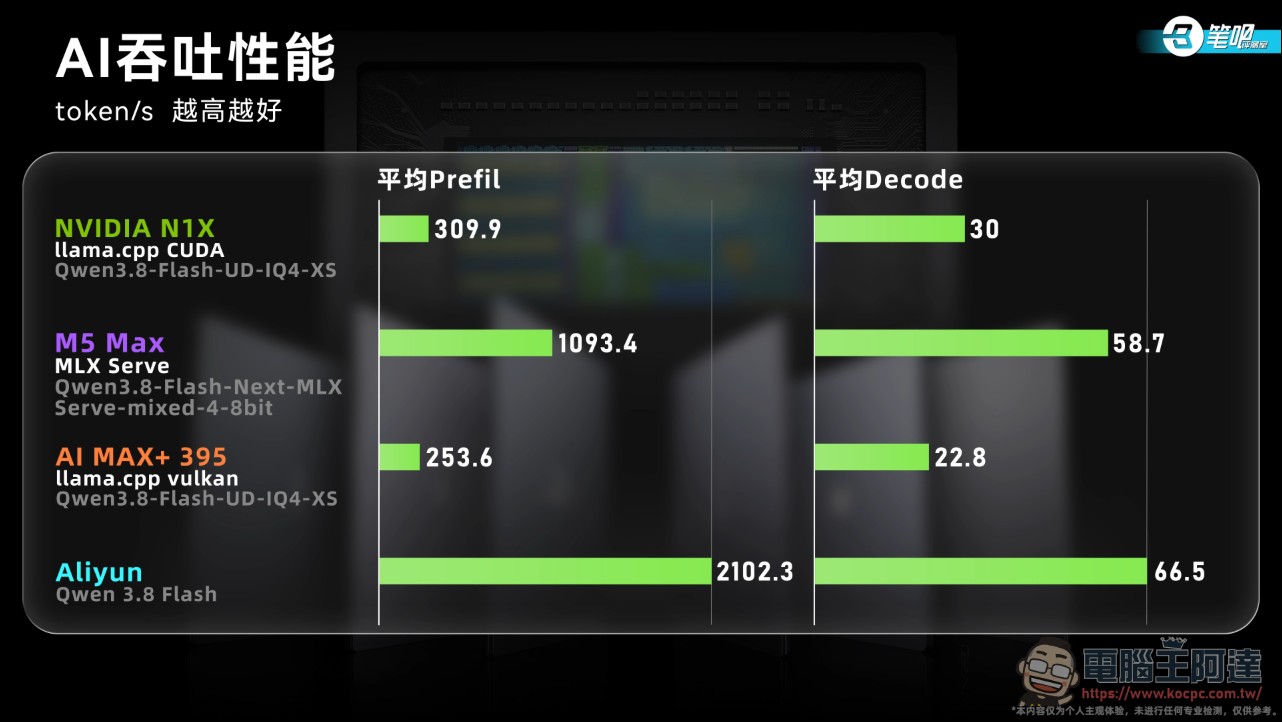
吞吐與效率上 RTX Spark 扳回一城:平均預填充與解碼速度分別比 AI MAX+ 395 快 22.2% 與 31.6%,平均任務耗時少 20.6%(限定成功任務為 21.2%),但與表現最好的 M5 Max 仍有距離。吐第一個 Token 的時間很短,原因是 llama.cpp 在這些任務的快取命中率較高,調整預填充分塊大小或加大快取配額還能再提升吞吐。影片另用 Artificial Analysis 的 AgentPerf 以 8 段錄製好的真實 Agent 對話測日常辦公場景的吞吐。
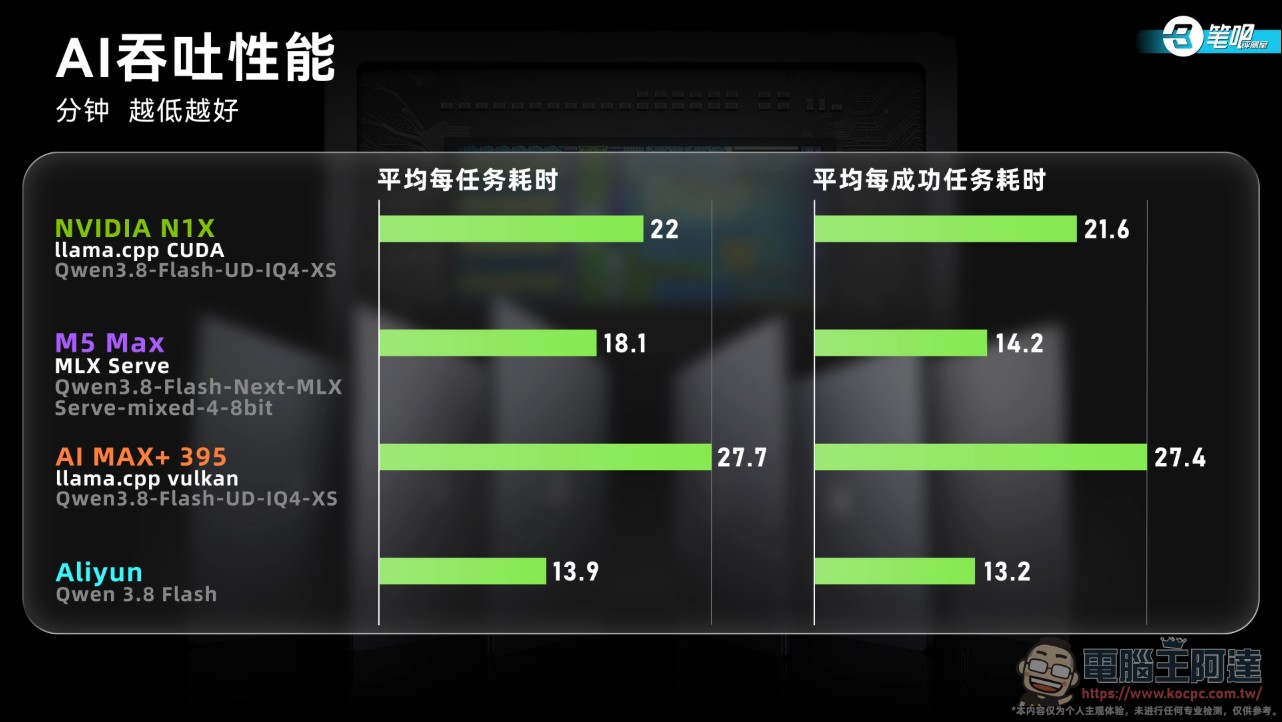
生態面,llama.cpp 已有 NVIDIA 官方支援、開箱即用,SGLang 與 vLLM 可透過 WSL 執行但尚未跟進 RTX Spark 的共享顯存支援。NVIDIA 官方則宣稱 RTX Spark 可在本地跑 120B 參數模型、最高 100 萬 Token 上下文。這是目前看過最有參考價值的本地 AI 本對決:它證明高吞吐確實換得到任務完成速度(快 AI MAX+ 395 兩成),但模型能力差雲端一大截,瓶頸在量化後的指令遵循與長程穩定性,不在硬體。影片那句「吐 Token 快不一定贏,不跌跟頭才是成功」是本地 Agent 的精準註解。
CPU 與機器本體:一台稱職的旗艦筆電(⏱️ 11:28-15:41)
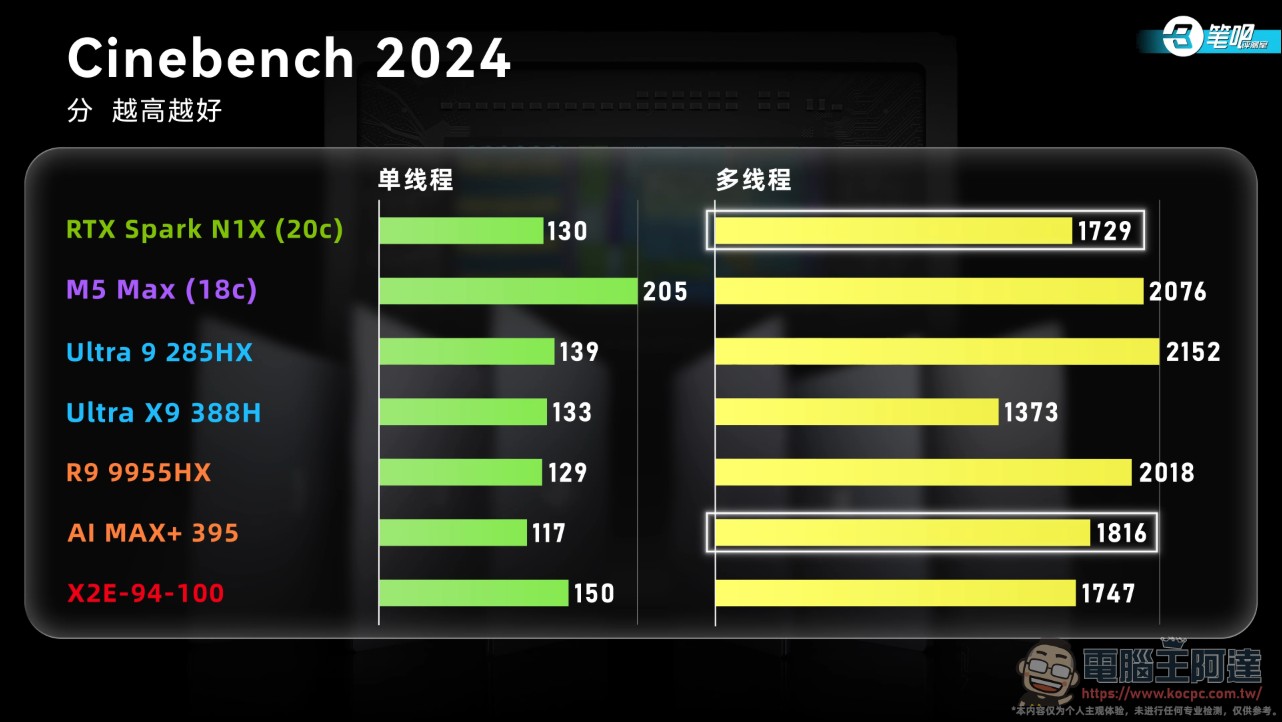
CPU 部分,ARM 原生的 Cinebench 2024 單核 130 分、多核 1,729 分,單核約 Ryzen 9 9955HX 的水準,多核略遜於 AI MAX+ 395;需要轉譯的 Cinebench R23 就跟不上版本了,對比高通 X2E-94-100,Cinebench 2024 多核只低 1%,R23 卻低了 7%,轉譯效率似乎比高通差一些。
機器本身倒是把旗艦該給的都給了:YOGA 韻律鍵盤 1.5mm 鍵程、親膚塗層;7 吋全域按壓觸控板有玻璃覆蓋,支援 4,096 級壓感、可當數位板用,隨附一支數位筆。介面 2A2C,C 口全是 USB 4、A 口全是 10Gbps,HDMI 與 SD 卡槽也是高速,兩側都有高速介面;機身 20mm 以內,配三腳氮化鎵充電器。15.3 吋 2.5K OLED 165Hz 觸控螢幕的色準與亮度都不錯、沒有低頻 PWM 調光,缺點是沒做 AR 抗反射,實測 SCI 達 4.74,顯示深色內容容易照鏡子。
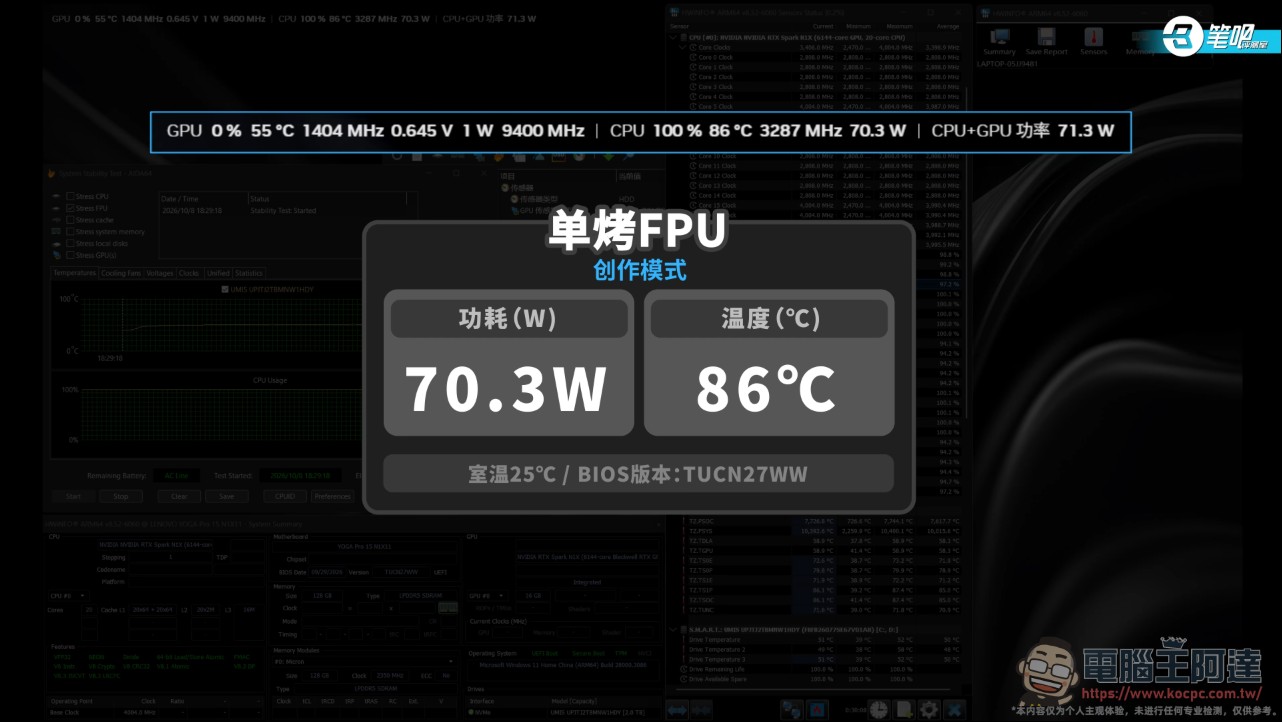
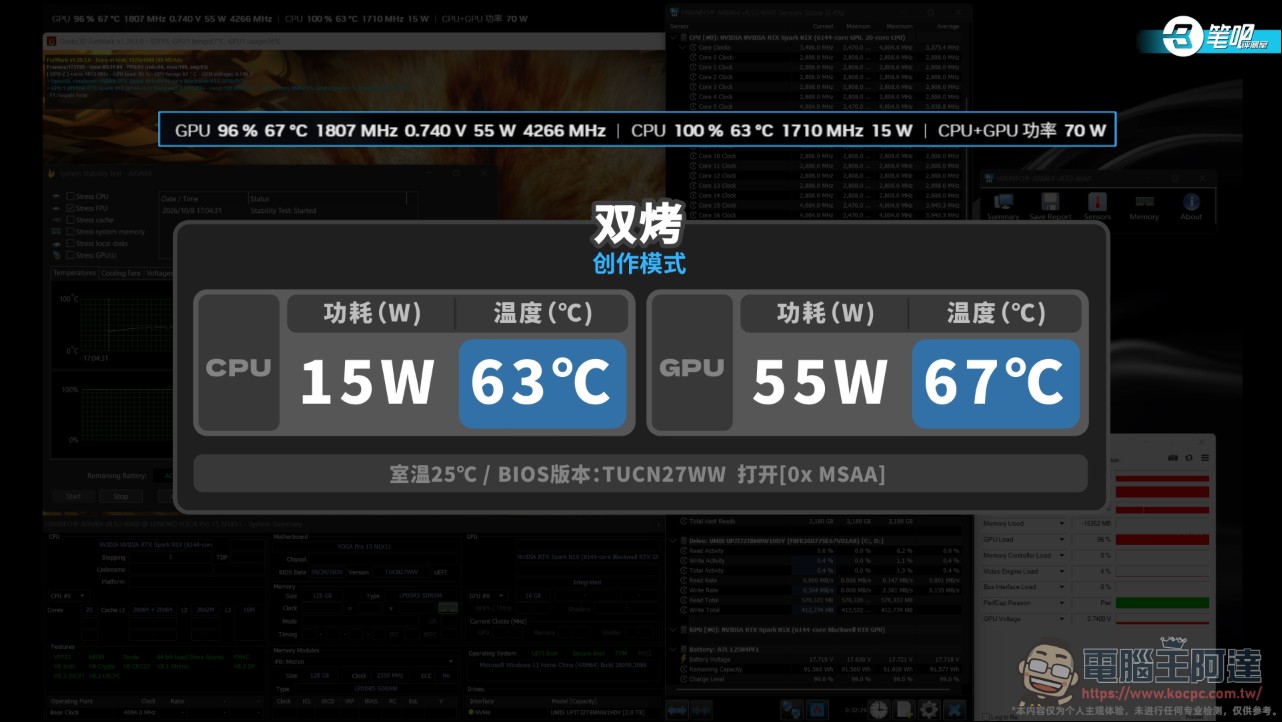
拆機看內功:電池從 84Wh 加大到 92.5Wh,實測續航 8 小時 15 分,在 NVIDIA GPU 機型中屬前段班。散熱改成 3 熱管雙風扇內吹模組,室溫 25°C 燒機:單烤 FPU 維持 70W、86°C,單烤 FurMark 維持 69W、72°C,雙烤時 CPU 與 GPU 分配 15W 與 55W、溫度僅 63°C 與 67°C,基本吃滿 80W SoC TDP;滿載人位噪音 53.9dB,鍵帽最高溫 43.8°C。HWiNFO 暫時不支援讀取 N1X 感測器,數據是用 NVIDIA APP 讀的。
這套散熱對 80W SoC 綽綽有餘,聯想把省下的散熱成本換成電池與介面,機器本體的完成度比晶片的成熟度高一個檔次。
結論:本地 AI 稱王,轉譯稅還沒繳完
筆吧評測室總結的優點是:機器素質對得起旗艦身分,介面速率頂滿、鍵盤觸控板體驗優秀、92.5Wh 大電池、PCIe 5.0 固態硬碟、廣色域 OLED,重量厚度也控制得不錯;散熱放在 80W 的 N1X 上剛剛好,跑滿功耗同時溫度、噪音、表面溫度都不高。缺點同樣明確:一碰到轉譯,CPU 與 GPU 的性能雙雙打折、跑分跟規模對不上號;熱門遊戲的相容問題沒解完,有的過不了反作弊、有的閃退、有的掉幀卡頓,第一代的陣痛難免。
本地 AI 是這台機器最硬的底牌:RTX Spark 在 Windows 筆電裡的本地 AI 效能沒有對手,llama.cpp 等工具開箱即用,但本地模型的推理效果仍差雲端一口氣,量化損失比理論預期得更明顯。還有一個相容性尾巴:許多為 DGX Spark 做的 NVFP4 社群量化方案,因為系統差異暫時在 Windows 這邊用不了。Windows on ARM 這幾年確有進步,大部分日用軟體都出了 ARM 原生版,32 位元 x86 應用轉譯在日常用途已無嚴重性能問題,但一到高效能需求場景,軟體生態的弱勢就全部暴露。
RTX Spark 的硬體與本地 AI 實力證明 NVIDIA 的切入點選對了,統一記憶體加 Arm 架構也確實打破了高通在 Windows on ARM 的獨佔局面;但 Adobe 重寫、遊戲原生化、開發者進場這些生態工程都還在進行式,距離「徹底改變 PC 工作方式」的宣傳語,中間隔的就是這一代使用者要繳的轉譯稅。若你的工作以本地 AI、開發與創作為主,這台機器目前在 Windows 陣營沒有替代品;若你在意遊戲與軟體的萬能相容性,這一代還不是下手的時機。
想了解更完整的相關評測資訊,相當推薦大家把這部影片看一下: