
近年越來越多人選擇購買高記憶體容量的 Mac,在本地運行 AI 模型,希望每個月能省下 OpenAI、Anthropic 等公司的 API 費用。只不過,考慮到目前 Mac 的價格、電費,以及不同 AI 模型的使用成本,本地 AI 或許沒有你想像中的那樣省錢。
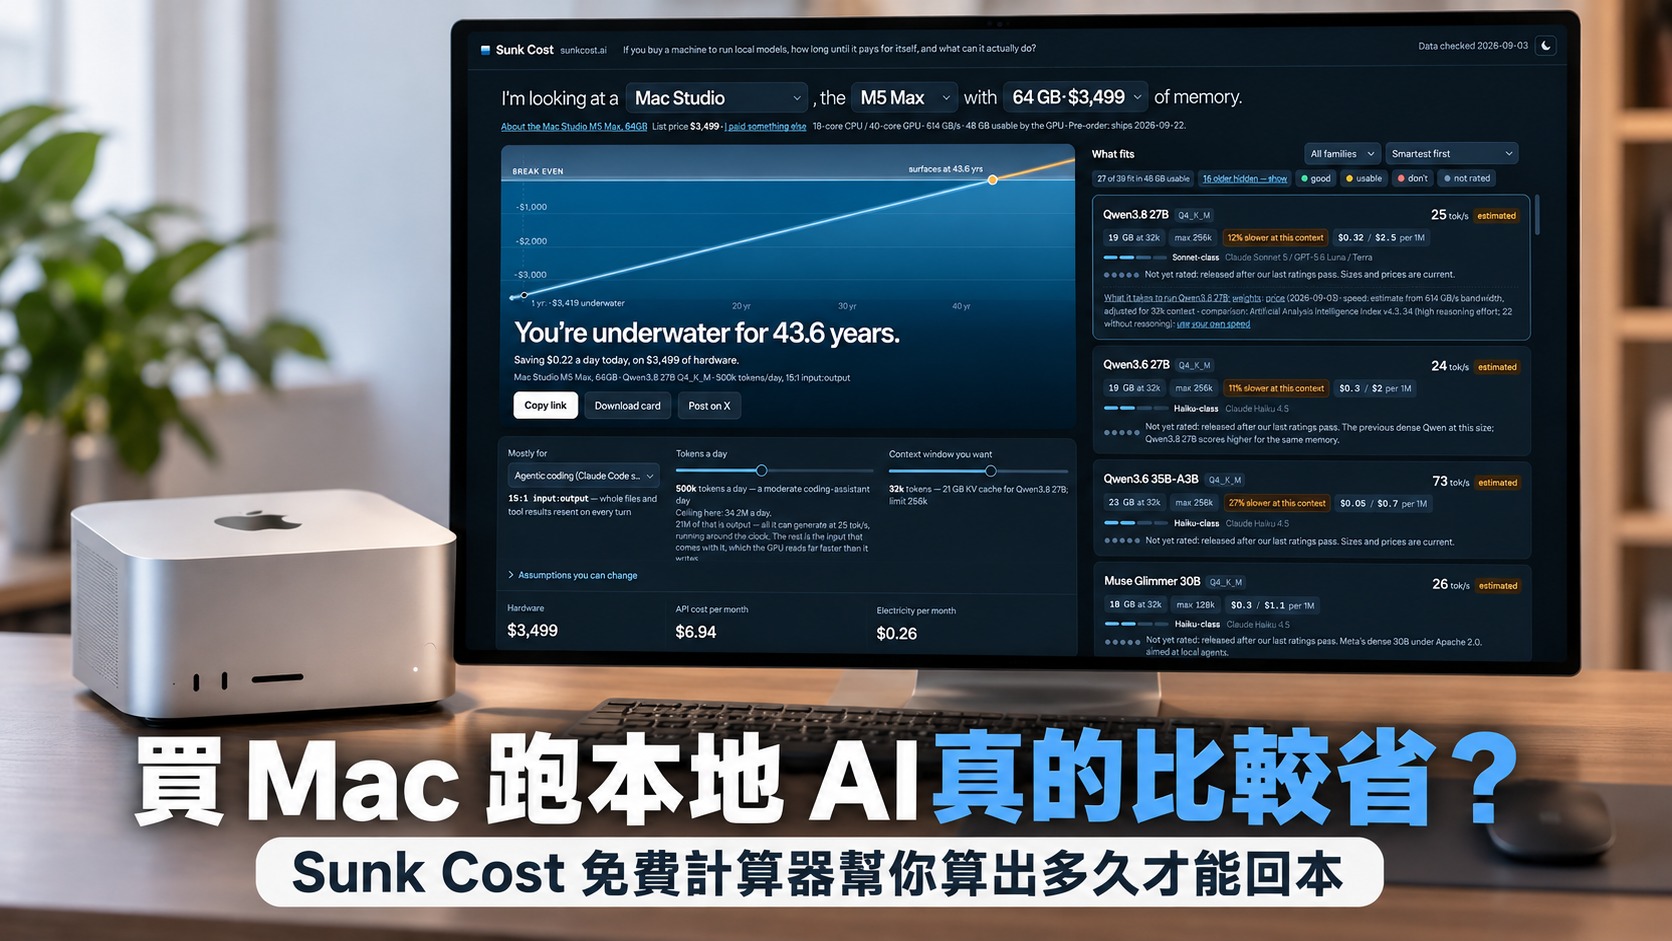
最近網路上就出現一款「Sunk Cost」的免費線上計算器,就能幫你算出答案。以一台台灣售價 NT$119,900 的 Mac Studio 為例,在特定的 AI 模型和使用量條件下,竟然需要到 46.7 年才能回本。除了算回本時間,它還能比較 AI 模型的能力、生成速度,以及告訴你哪些模型可以在自己的電腦運行。
Sunk Cost 免費計算器,一鍵幫你算出多久才能回本
Sunk Cost 是一個免費的線上計算器,核心邏輯是比較兩種使用 AI 的方式。一是花錢買硬體,在自己的電腦上跑開源 AI 模型,之後只要付電費;二則是不買硬體,直接用雲端 API 呼叫同一款模型,用多少付多少。
計算器會把硬體價格、每天的電費、同樣用量下的 API 費用都算進去,最後畫出一條回本曲線,告訴你要過幾年,省下的 API 錢才能補回當時買機器的錢。
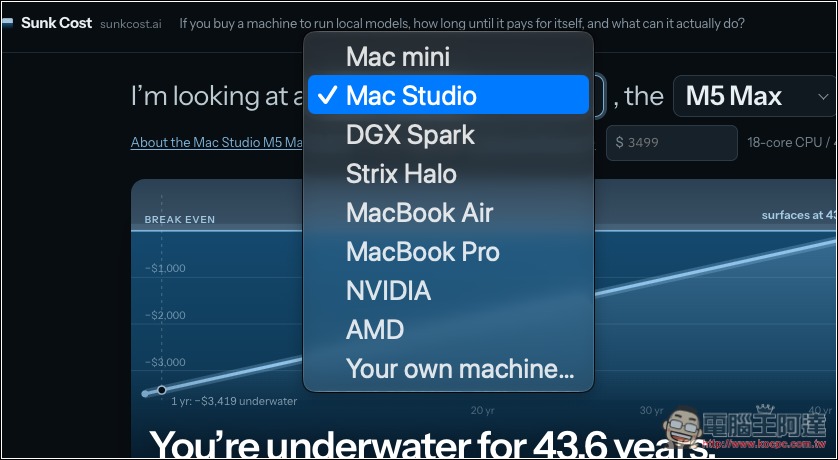
可以選的硬體不只 Mac 系列,也有 NVIDIA DGX Spark、AMD Strix Halo 這類主打本地 AI 的小主機,以及 NVIDIA、AMD 顯示卡,甚至還能自行輸入記憶體、功耗、記憶體頻寬等規格。
模型部分則以開源模型為主,包含 Qwen、Llama、Gemma、Mistral、DeepSeek、gpt-oss、GLM、Nemotron、MiniMax 等家族。API 價格參考的是 OpenRouter 上同一款模型的報價,網站標示資料最後檢查日期是 2026 年 9 月 3 日。
Sunk Cost 首頁是預設 8 月剛發表的 Mac Studio M5 Max 64GB 版本,美國售價 3,499 美元,模型則是阿里巴巴的 Qwen 3.8 27B,用 Q4_K_M 量化版本,大約占 19GB 記憶體。使用情境設定為「Agentic coding」,也就是類似 Claude Code 那種讓 AI 代理自己讀檔、改程式的用法,每天消耗 50 萬 tokens。最終算出 43.6 年才能回本:
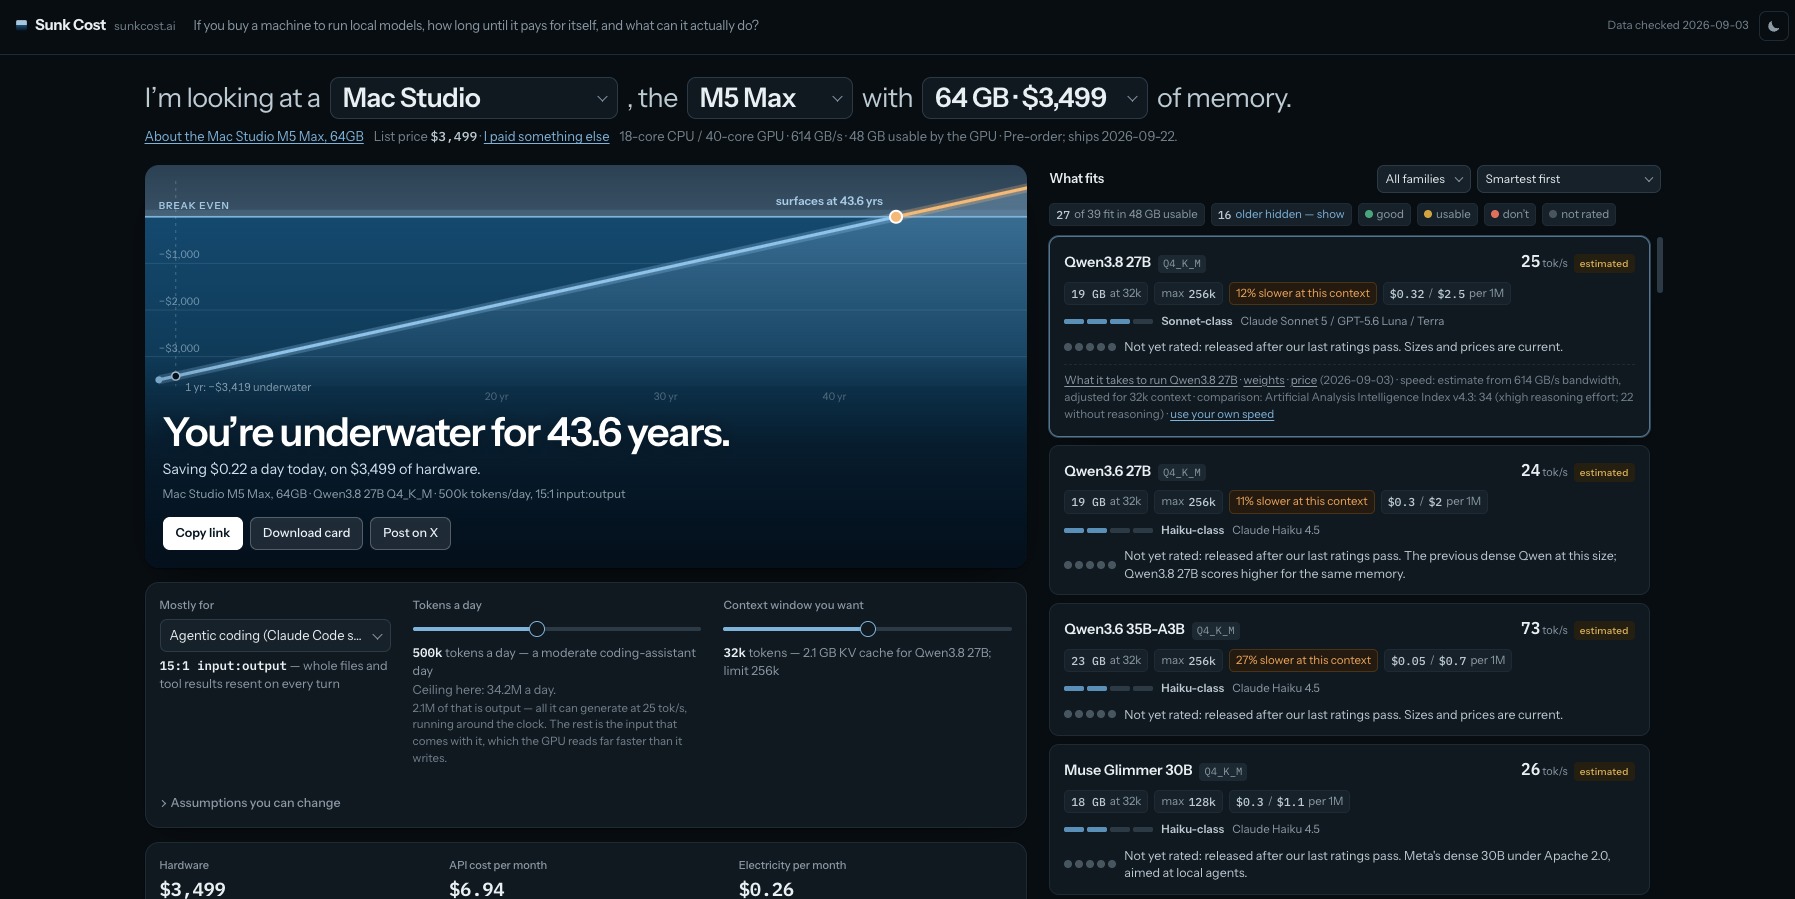
這台在台灣 Apple 官網售價是 NT$119,900(M5 Max 18 核心 CPU、40 核心 GPU、64GB 統一記憶體、512GB SSD),跟美國相比結果還貴一些。我用「I paid something else」把價格改成台灣售價換算的美元金額,其他條件不變,重新跑了一次,結果整理如下(匯率以 1 美元約 32 元新台幣計算):
| 項目 | 數值 |
|---|---|
| Mac Studio 購買成本 | NT$119,900(M5 Max、64GB,台灣 Apple 官網售價) |
| AI 模型 | Qwen3.8 27B(Q4_K_M 量化) |
| 每日使用量 | 500,000 tokens(輸入:輸出=15:1) |
| 雲端 API 每月費用 | 約 NT$222(6.94 美元,OpenRouter 報價) |
| 本地 AI 每月電費 | 約 NT$8(0.26 美元;每度 0.17 美元、滿載 145W) |
| 每月節省 | 約 NT$214(6.68 美元) |
| 回本時間 | 約 46.7 年(美國售價 3,499 美元為 43.6 年) |
算法很簡單,每個月如果是用 API 要付約 NT$222,但改成在自己的 Mac 上跑的話,變成只要付約 NT$8 電費,所以每個月省下約 NT$214。拿購買的 NT$119,900 去算,119,900÷214÷12,大約就是 46.7 年回本。
當然,回本時間這麼長,除了 Mac 較貴之外,比較的模型價格也偏便宜。
Qwen3.8 27B 在 OpenRouter 上每 100 萬個輸入 tokens 只要 0.32 美元(約 NT$10)、輸出 2.5 美元(約 NT$80),加上 Agentic coding 情境的輸入遠多於輸出(每 16 個 tokens 只有 1 個是 AI 產生的),大部分用量都落在最便宜的輸入價格上,一個月才只要兩百多元。
如果換一款 API 價格比較高的模型、用量拉大,回本時間就會變得不一樣。只不過我查了一下,目前 Mac Studio 使用絕大多數的開源模型,幾乎都要 50 年以上。
使用方式也很簡單,進到 Sunk Cost 後,就選擇你要購買的裝置:
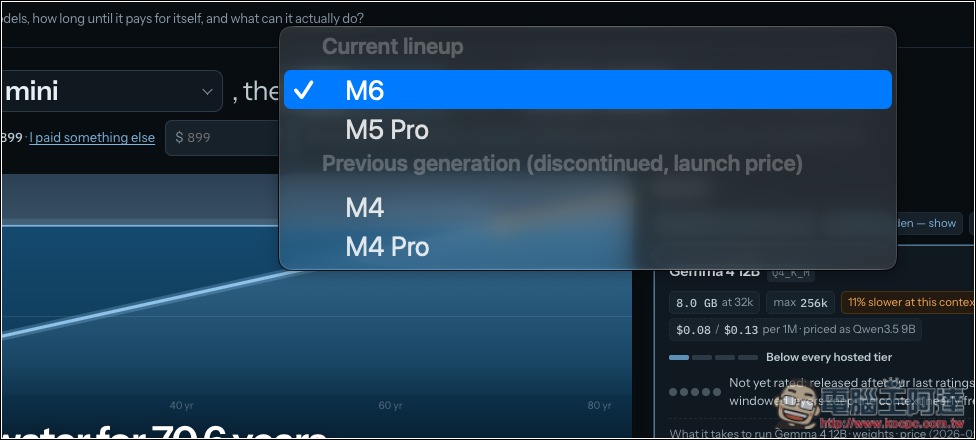
然後選擇規格:
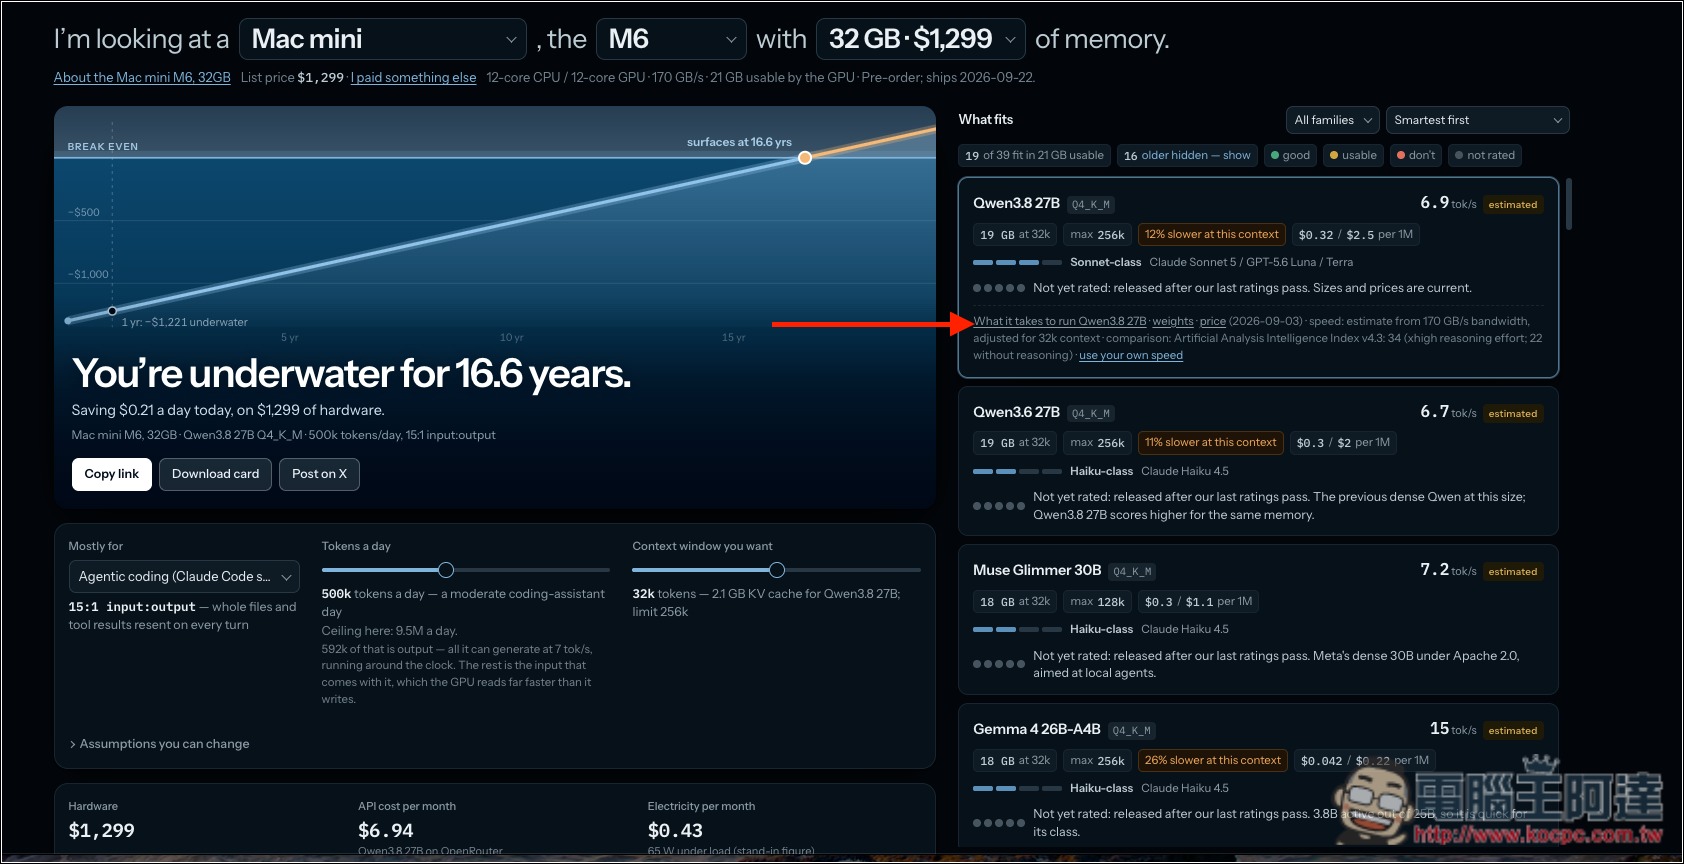
接著是選模型,在右邊的「What fits」清單中,點選你打算跑的模型,每張模型卡片都會寫出它在 32k 上下文時要吃多少記憶體、預估每秒能生成幾個 tokens,以及雲端 API 每 100 萬 tokens 的輸入/輸出價格。以預設的 Qwen3.8 27B 來說,需要 19GB 記憶體,我選擇 M6 Mac mini 32GB 中預估只有 6.9 tok/s:
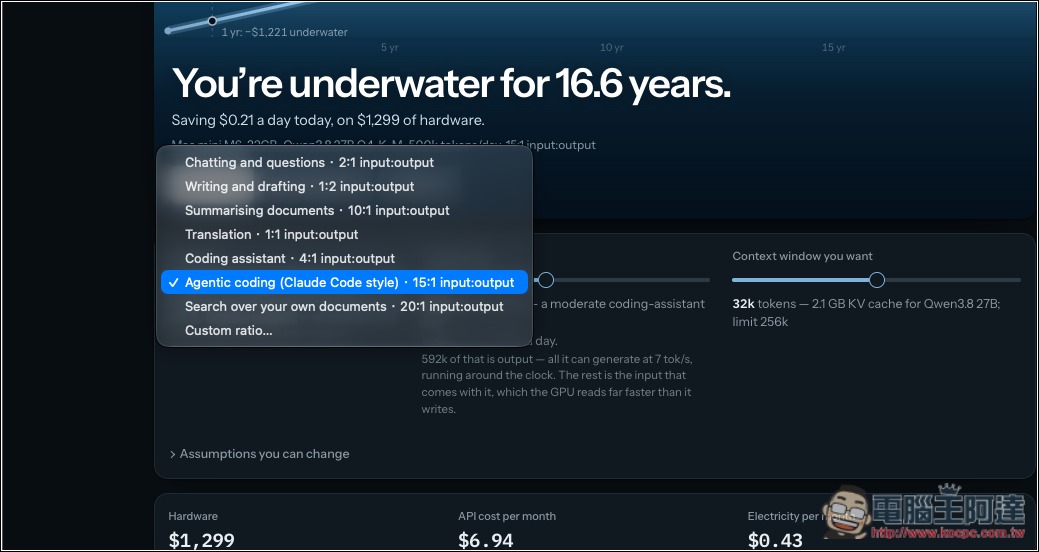
再來設定你會怎麼用。在「How you’d use it」區塊裡的「Mostly for」可以選主要用途,選項包含聊天問答、寫作、摘要文件、翻譯、程式助理、Agentic coding(Claude Code 這類代理用法),以及搜尋自己的文件,每種用途都會對應不同的輸入:輸出比例。:
最後是調整計算條件。在「Assumptions you can change」裡更改電費,預設是美國平均每度 0.17 美元(約 NT$5.4),你可以把自家每度電價換算成美元再填進去。如果你已經實測過自己 Mac 跑這個模型的速度,也可以填入實際的 tok/s,取代網站的估算值:
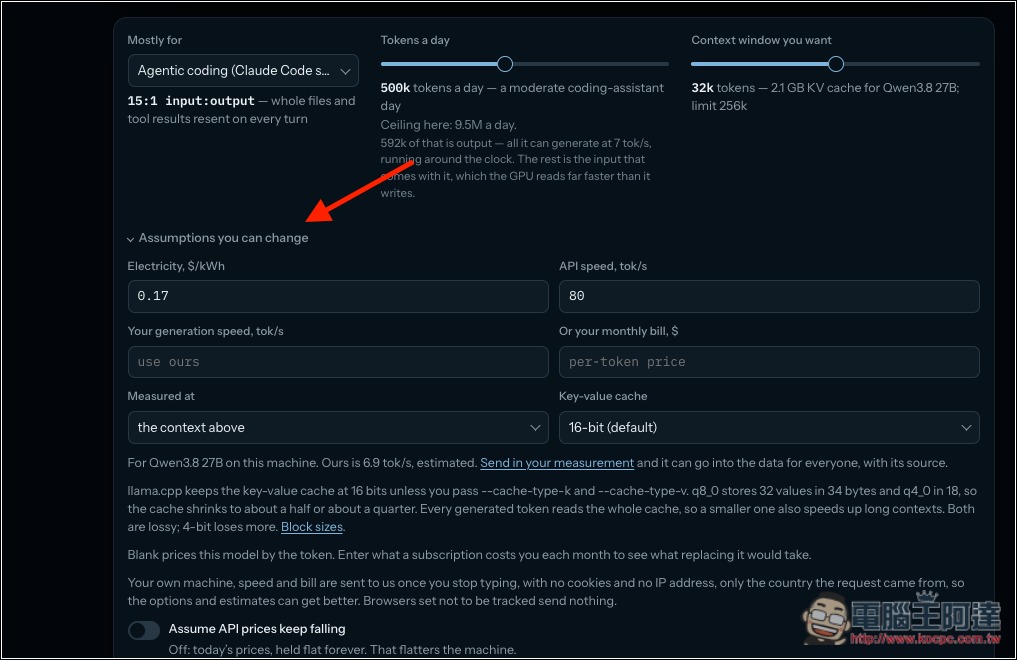
這裡最關鍵的是「Assume API prices keep falling」選項,勾選後可以設定 API 每年降價 20%、30%、40% 或 60%。過去幾年 API 價格一直往下掉,因此這選項對結果影響會非常大。另外「Compare against a subscription instead」可以改成跟月訂閱比,例如輸入你每個月付 ChatGPT 或 Claude 的 20 美元。
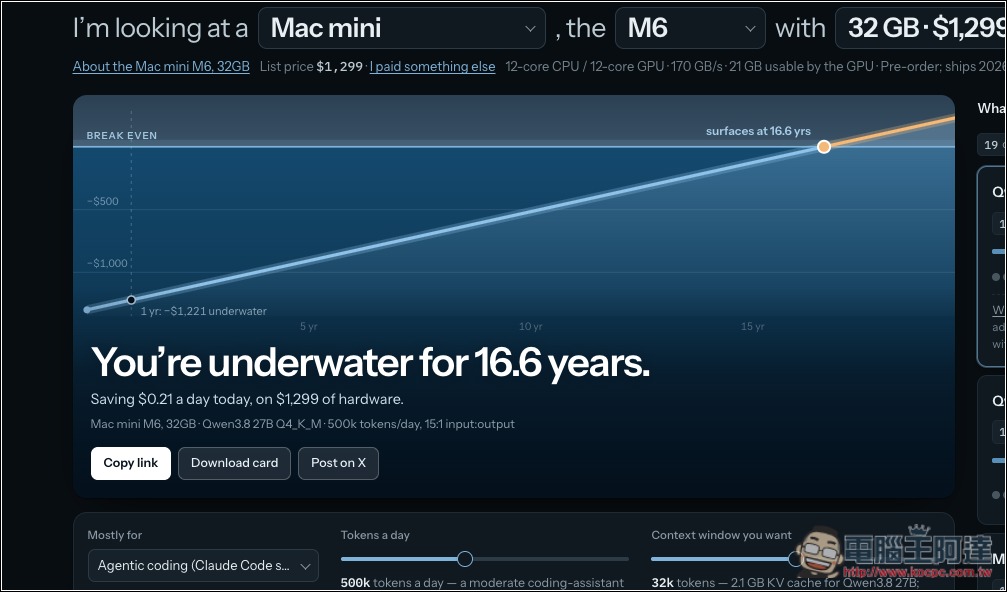
完成之後,上方就會顯示結果了。「The break-even」會畫出一條回本曲線,標出要幾年才能浮出水面:
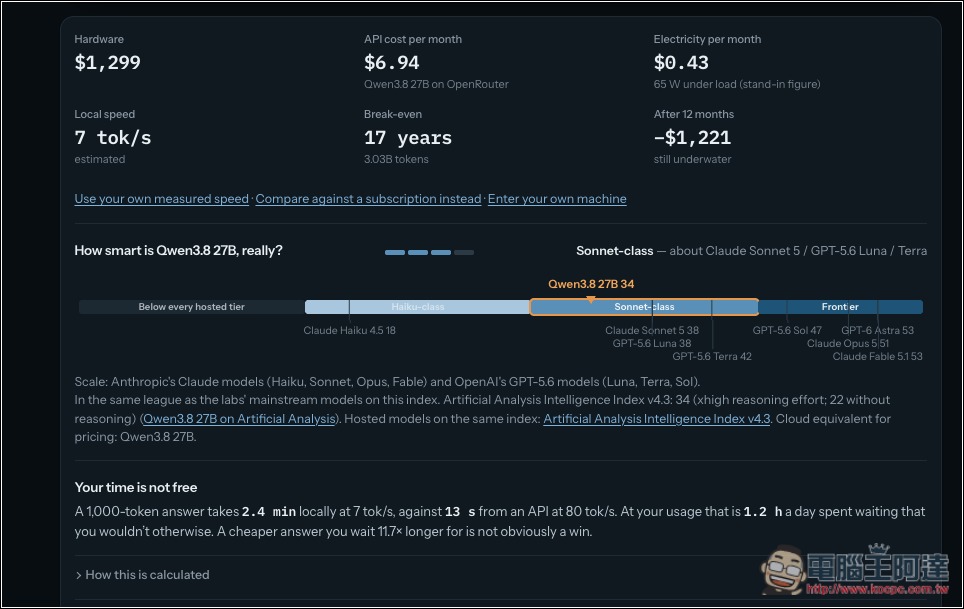
下方的數字列則會整理硬體價格、API 每月費用、本地每月電費、本地速度、回本時間,以及 12 個月後還差多少錢:
按 Download card 可以獲得這樣的結果卡:
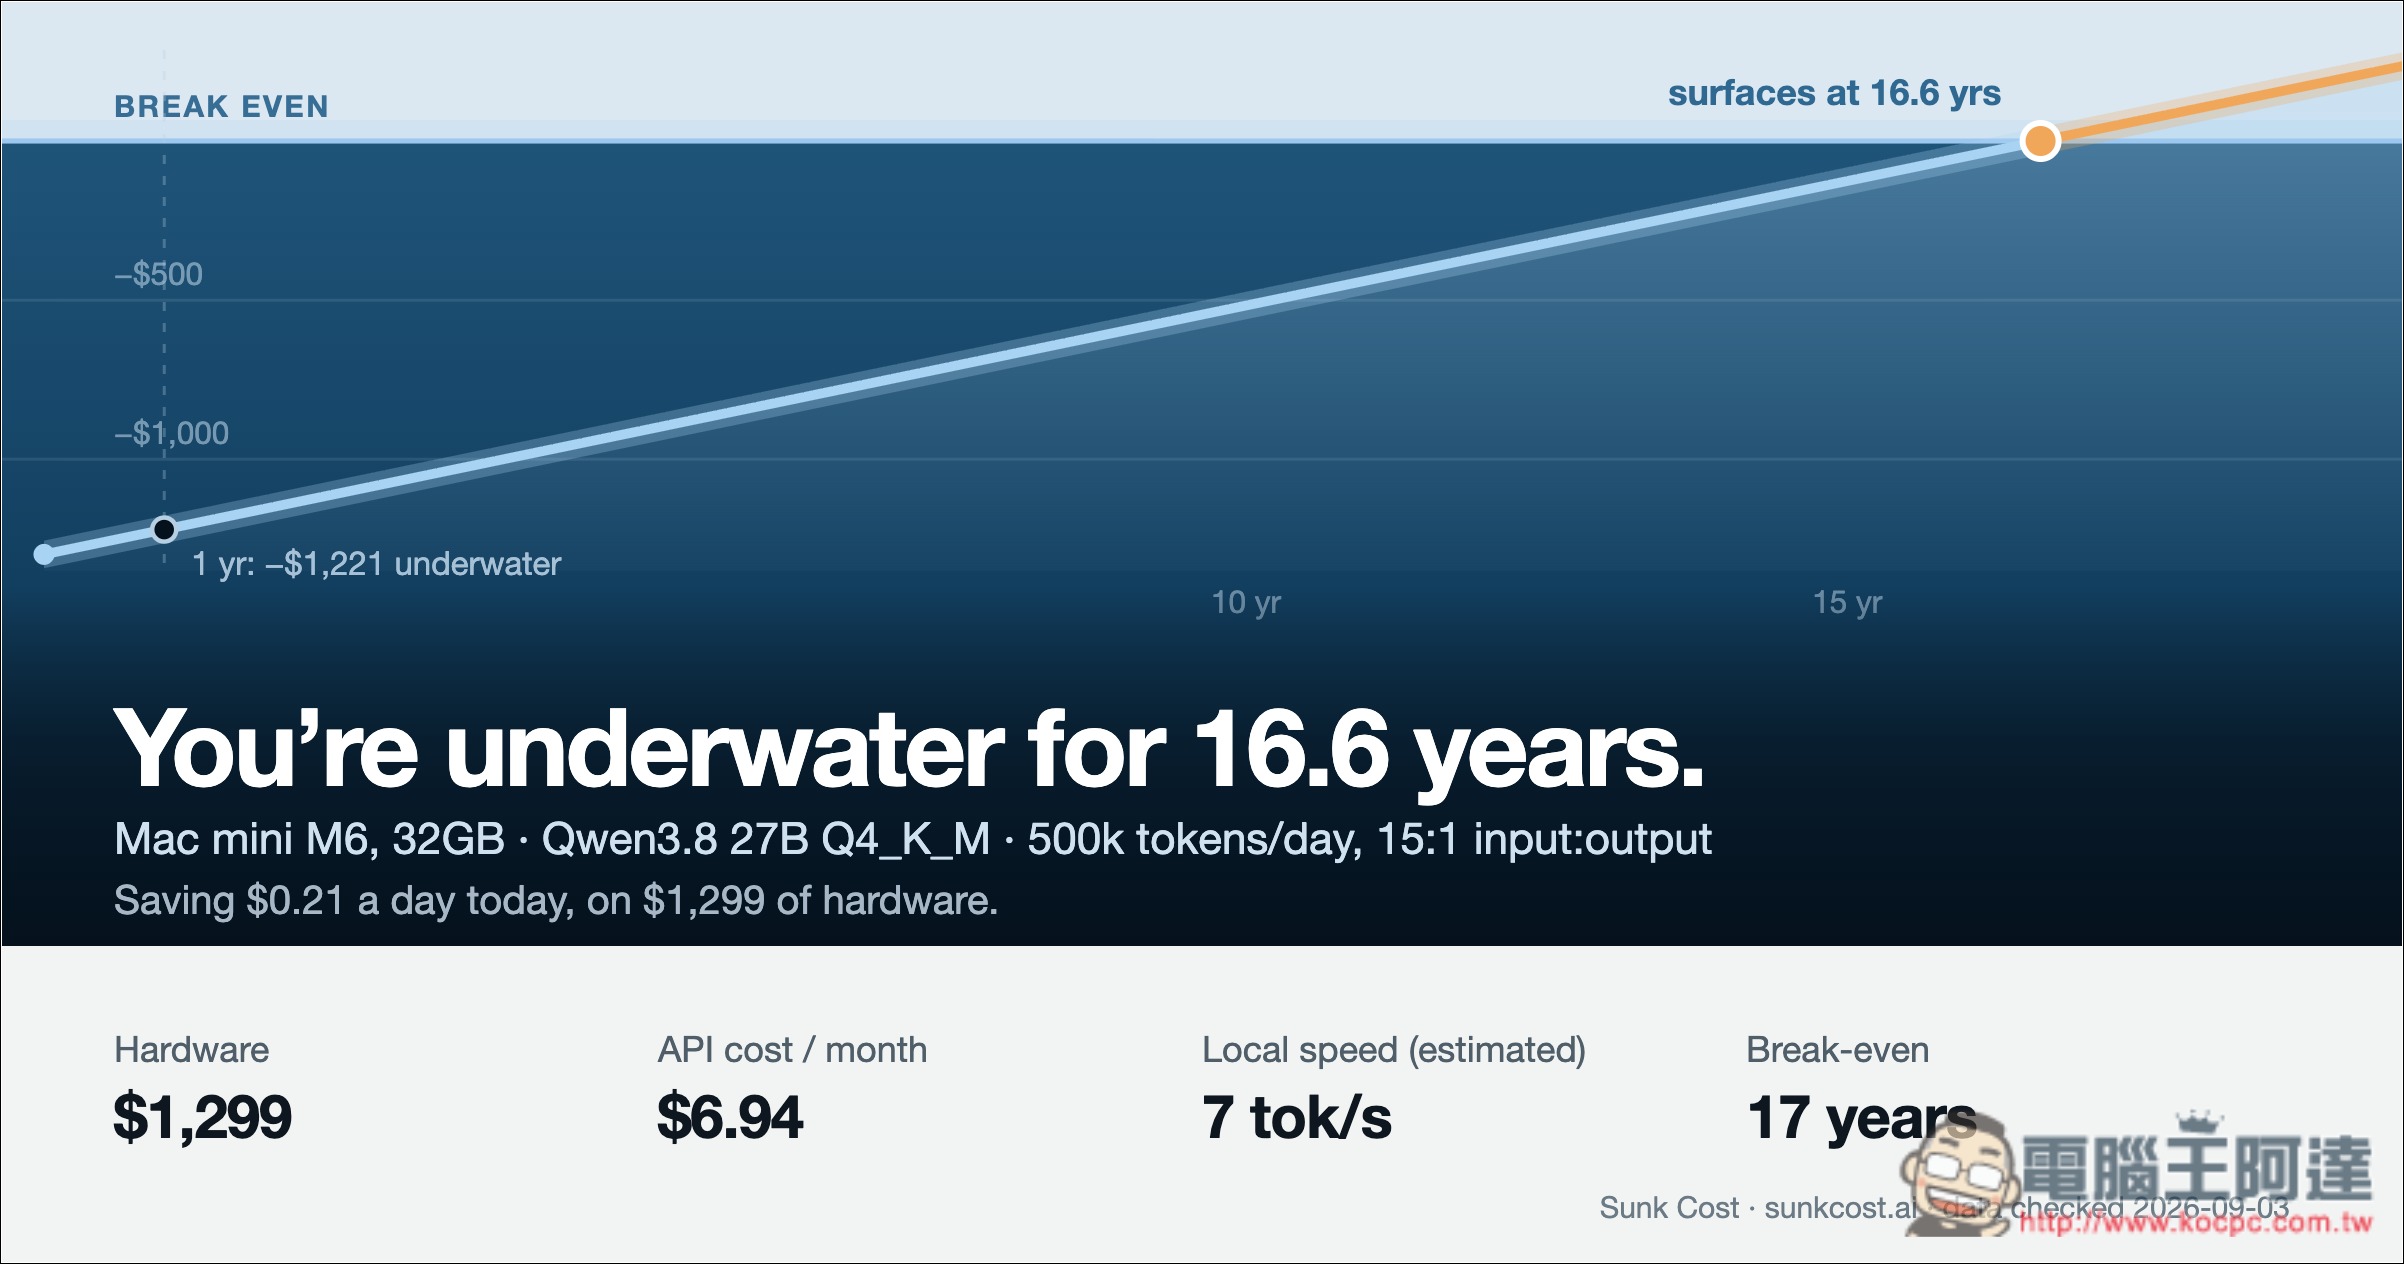
40~50多年聽起來很嚇人,但事實上也不用這麼久,因為硬體有轉售價值,特別是 Mac,就算用了幾年還是可以賣不錯的價格,而且電腦還可以拿來做其他事。
此外,本地 AI 的優勢也不只有省錢,網站也列出幾點,包括:
- 提示詞和檔案不會離開你的電腦
- 沒有人能修改、限流或下架你正在用的模型
- 你可以自己決定安全限制、自行微調
- 機器還能拿來打遊戲、算圖、編譯程式
對於要處理公司機密程式碼、客戶資料,或需要在沒有網路的環境下使用 AI 的人來說,這些可能比能省多少錢更重要。