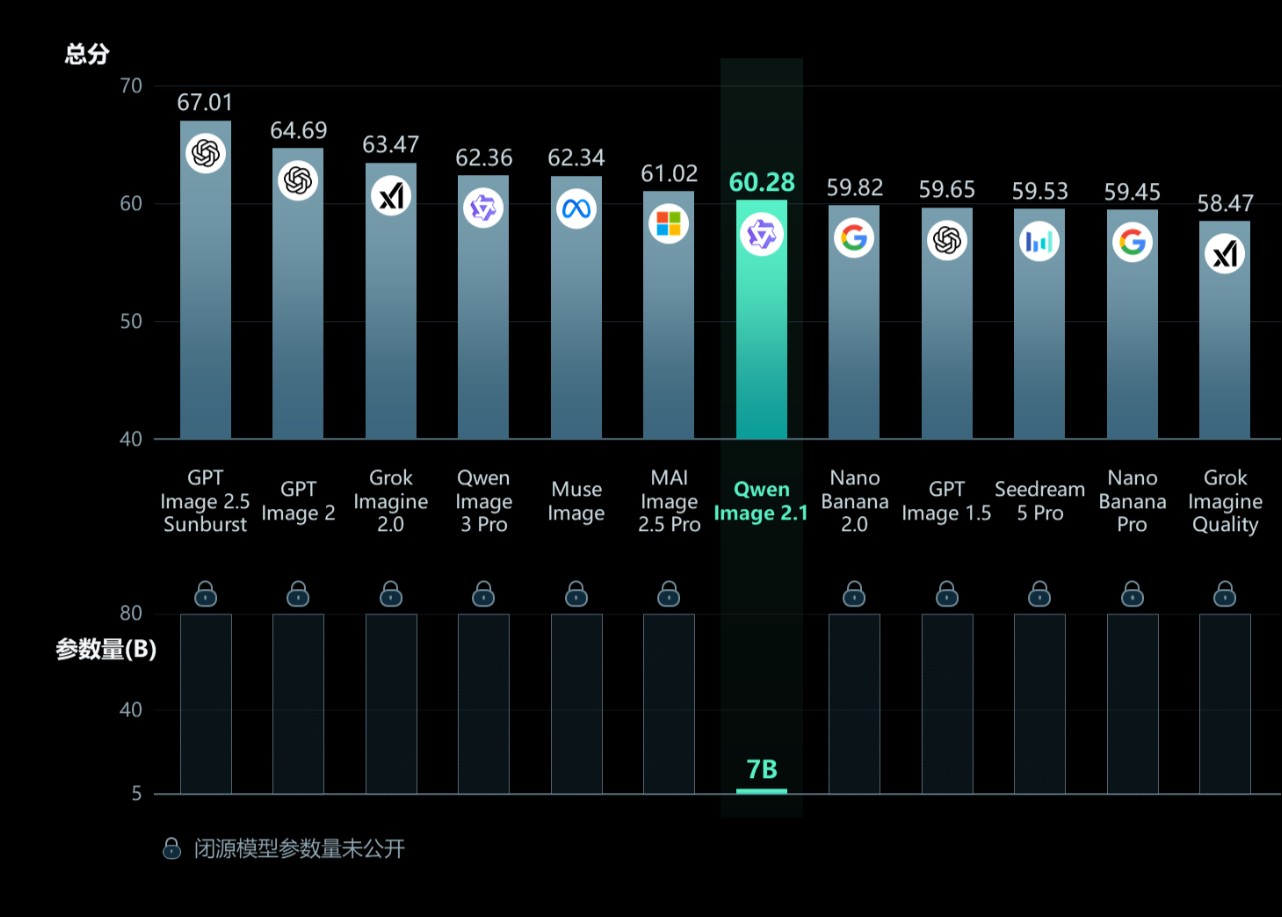
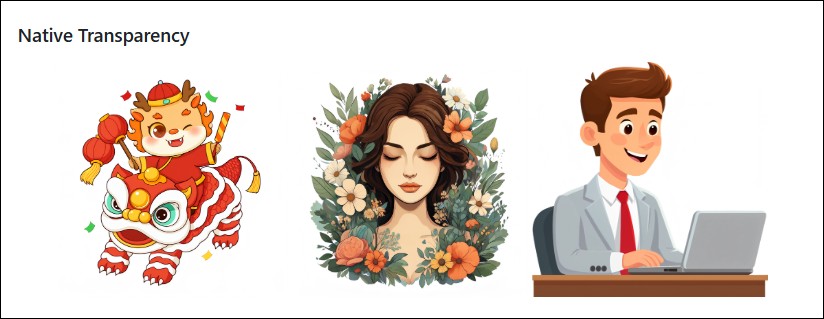
阿里巴巴通義千問(Qwen)團隊在昨晚( 9 月 20 日)正式開源了 Qwen-Image-2.1,這是一款結合文字生成圖片與圖片編輯的統一模型。與前代相比,新版最大的突破在於視覺生成元件僅有 7B(70 億)參數,卻號稱在多數基準測試中超越了大多數閉源圖像模型。這也是 Qwen 圖像系列首次支援原生透明圖片(RGBA)生成與編輯。過去要生成帶透明背景的圖片,通常需要後製去背或多個模型串接;Qwen-Image-2.1 將這些功能整合進單一模型中,從文字描述生成透明貼紙、編輯透明圖層、到從照片中提取主體,都能在同一個架構中完成。對於設計師和內容創作者而言,這大幅縮短了從初步構圖到最終成品的整體製作時間。
Qwen-Image-2.1 四大核心改進
根據 GitHub 文件,Qwen-Image-2.1 有四項主要改進。第一是輕量化與高效能:視覺生成元件採用 32 層 Single-Stream DiT 架構,搭配混合粒度注意力(mixed-granularity attention)與前綴 KV 快取重複使用技術,在低運算成本下維持高品質圖像輸出。這使得模型能在消費級 GPU 上執行,大幅降低了部署門檻。根據官方公佈的成績,Qwen-Image-2.1 也是目前所有主流生圖模型中體量最小且開源的模型,表現也名列前茅。
第二是原生透明度支援。模型可以直接生成 RGBA 格式的透明圖片,無需額外的去背步驟。這對於需要製作貼紙、圖示、合成素材的創作者來說相當實用,省去了傳統流程中「生成→去背→合成」的多個步驟。
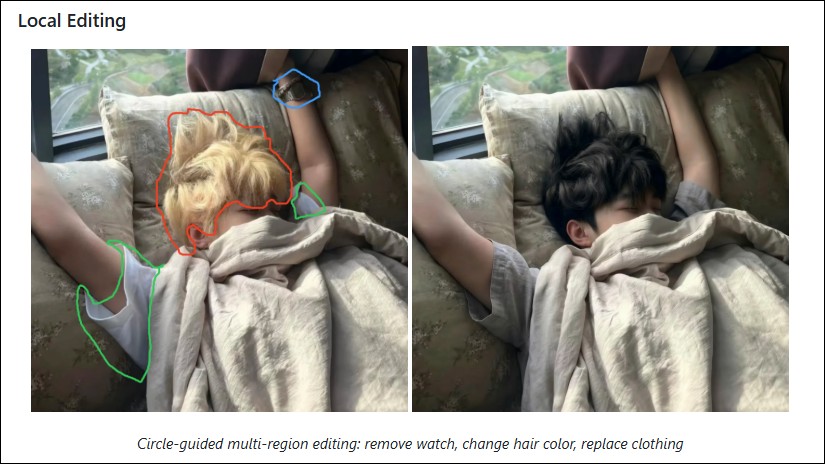
第三是多圖參考編輯能力。Qwen-Image-2.1 支援最多 10 張參考圖片進行編輯,使用者可以透過圈選、塗鴉標註或獨立遮罩指定局部編輯區域,同時保留人物與產品的身份特徵。這代表使用者可以將多張照片中的元素合成為一張新圖,並精確控制每個區域的編輯範圍。
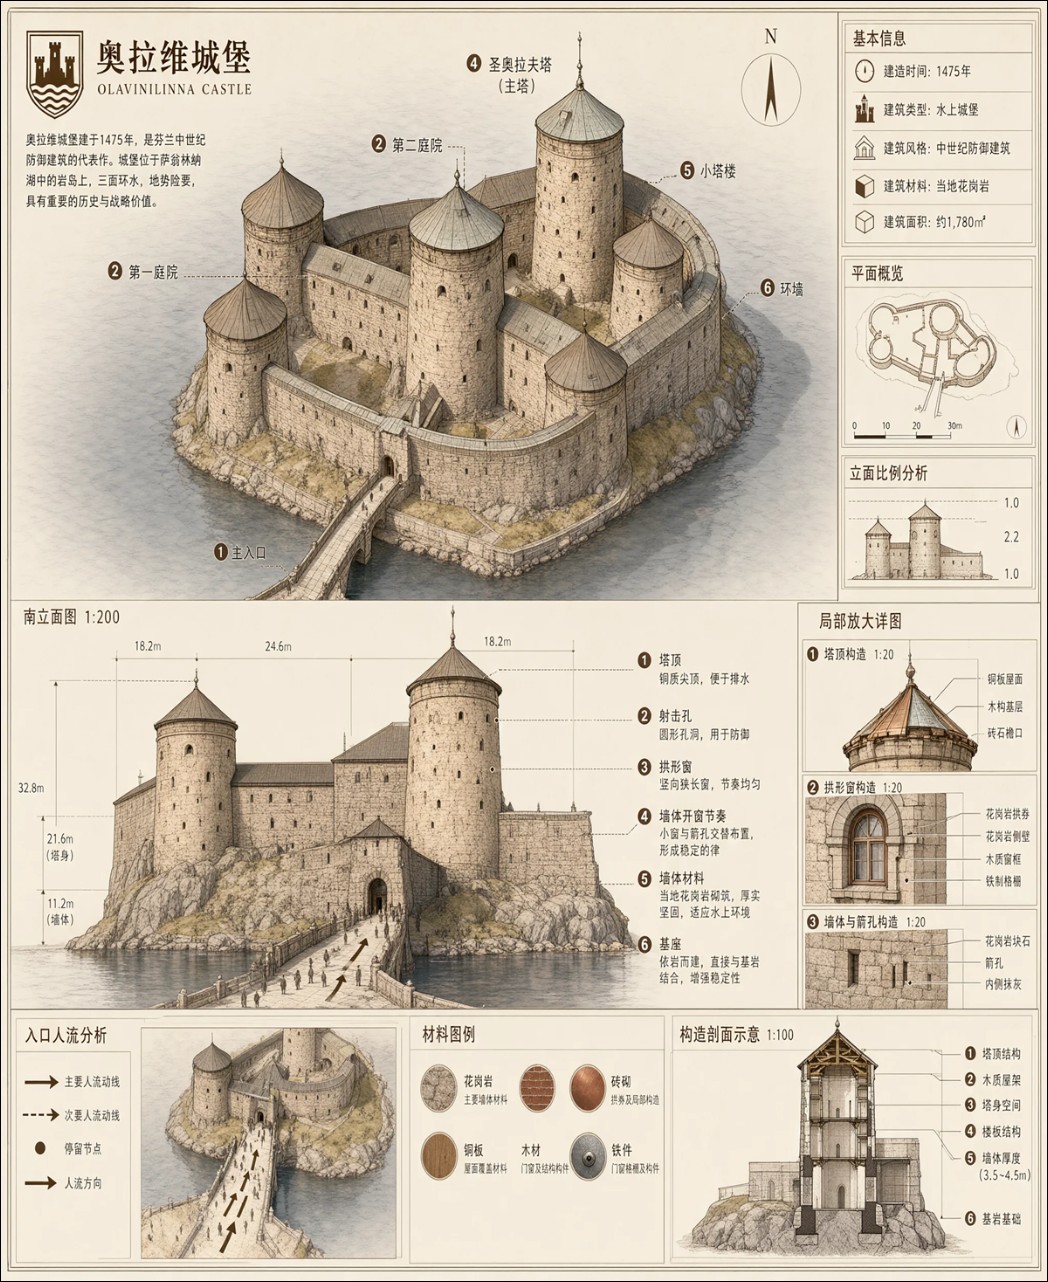
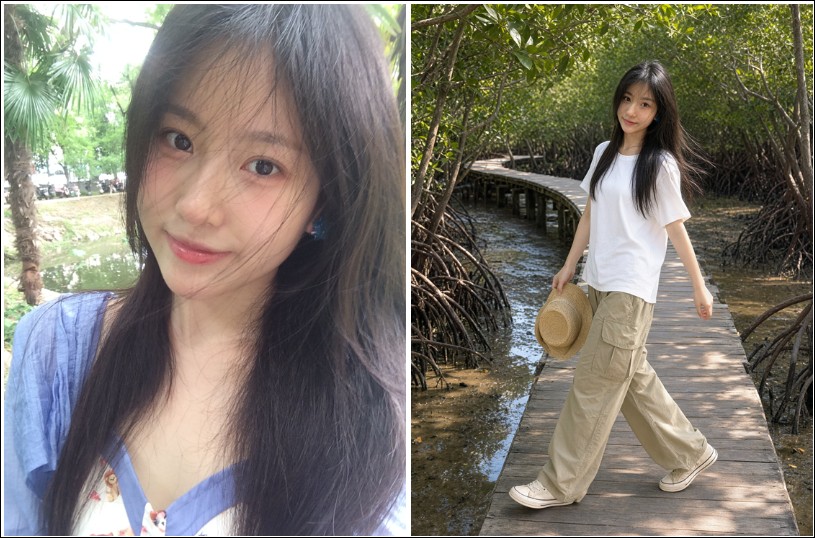
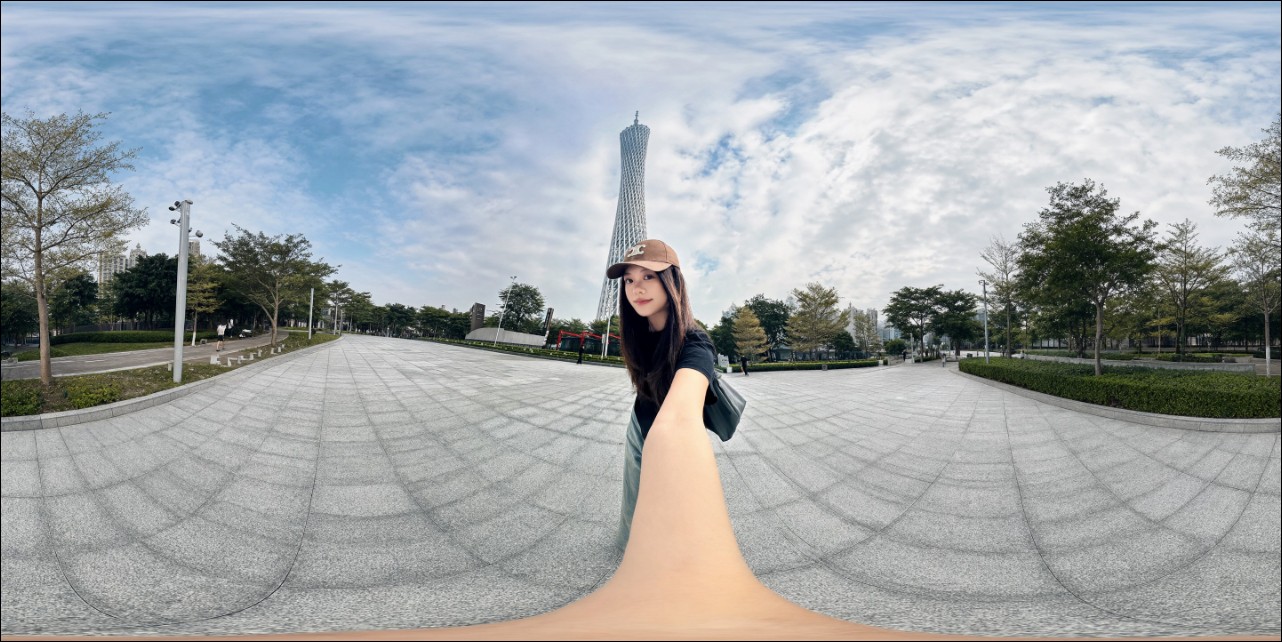
第四是寫實質感與美學提升。新版改善了文字排版、人像光影與細節呈現,在全景圖、資訊圖表與虛擬試穿等場景中表現特別突出,能產生更逼真的紋理與優雅的版面設計。
技術架構與規格
Qwen-Image-2.1 的視覺生成元件參數量為 7B,架構為 32 層 Single-Stream DiT。原生支援 2K 解析度輸出,支援多種長寬比,包括 1:1(2048×2048)、4:3(2400×1792)、16:9(2752×1536)等。推理時預設使用 40 個去噪步驟,資料格式為 BF16。
此外,官方還提供了兩組基於 Qwen3.5-VL 9B 微調的提示詞改寫模型(Prompt Enhancer),分別用於文字生成圖片與圖片編輯場景。這兩個模型可以將簡短的提示詞擴展為詳細的高品質描述,提升生成效果。例如使用者只需輸入「一隻可愛的貓」,改寫模型會自動擴展為包含場景、光線、構圖、風格等細節的完整提示詞,大幅提升生成品質。使用者可以透過 vLLM 進行批次推理或部署為 API 服務。
生態系 Day 0 支援
Qwen-Image-2.1 在發布當天就獲得了多個主流推理框架的原生支援。HuggingFace Diffusers 從 Day 0 提供 QwenImage21Pipeline,使用者只需幾行 Python 程式碼即可開始生成圖片。ComfyUI 同步提供原生支援與範例工作流程(文字生成圖片與圖片編輯各一組)。
在高效能推理方面,vLLM-Omni 提供了逐步執行、前綴 KV 快取、CUDA Graph 解碼、FP8 量化與張量平行等最佳化。SGLang 同樣從 Day 0 支援,包含快取機制、CUDA Graph、多種平行策略與元件卸載功能。LightX2V 也提供了加速方案。這種發布當天就獲得完整生態系支援的陣仗,在開源圖像模型中相當少見,反映出 Qwen 團隊在開源社群中的影響力。
結語
Qwen-Image-2.1 以 7B 參數量、原生透明度支援、多圖參考編輯與完整的推理框架生態系支援,為開源圖像生成領域帶來了一款功能全面且部署門檻低的新選擇。不過「超越多數閉源模型」的說法仍需等待獨立基準測試的驗證,實際使用體驗也有待社群回饋。Qwen Research License 並非完全開放的開源授權,商業用途可能受到限制,使用者需要仔細確認授權條款。模型權重已在 HuggingFace 與 ModelScope 兩大平台同步開放下載,有興趣的開發者可以立即開始測試與部署。