Apple 新一代 Mac Studio(搭載 M5 Ultra)正式出貨時間還沒到,在 oMLX 效能資料庫上已經悄悄出現首批 M5 Ultra 本機 AI 效能數據,相較前代規格看起來相當亮眼。這些數據在曝光後沒多久就被移除,讓這場「提前流出」多了一層話題性。
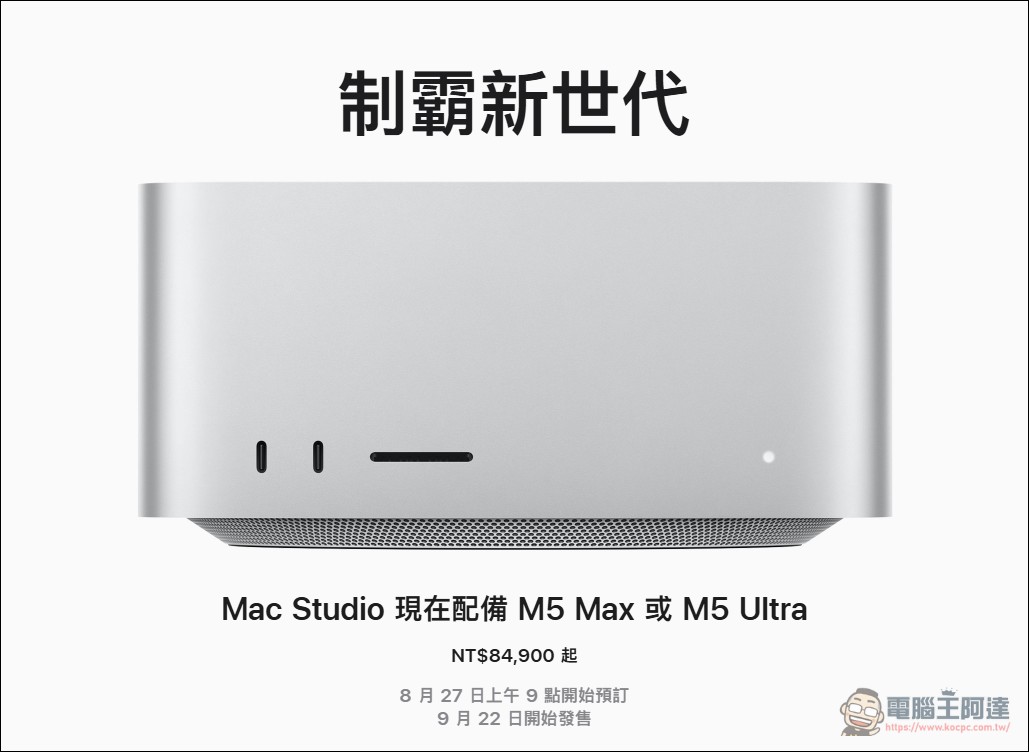
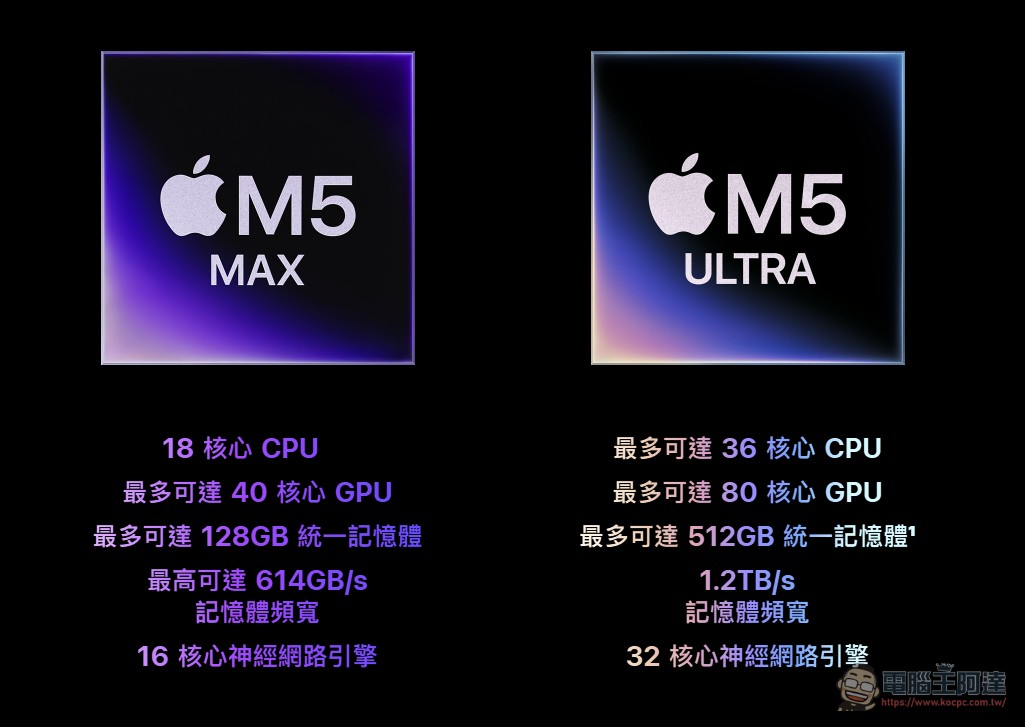
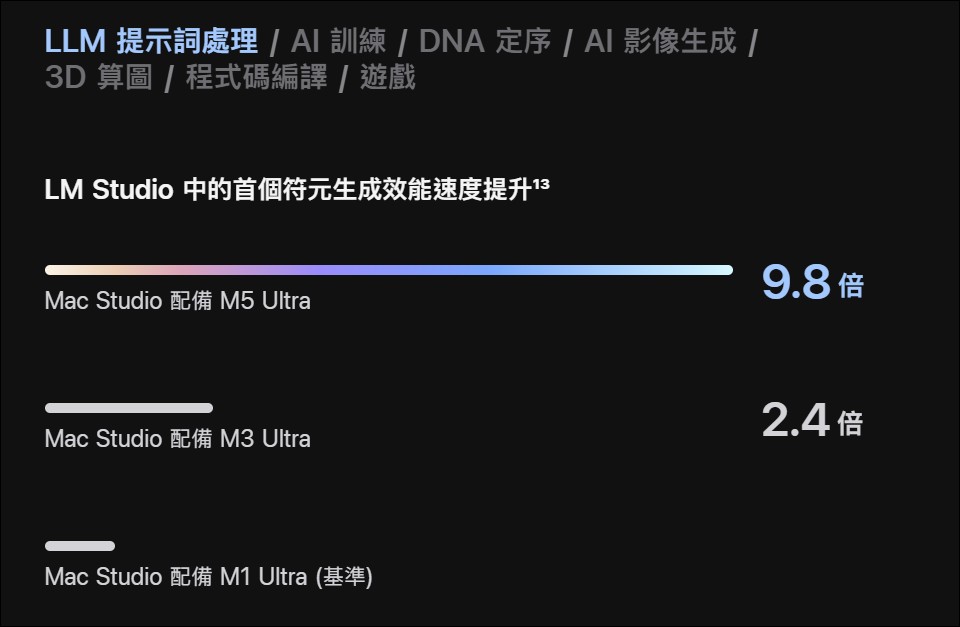
根據蘋果官方規格,M5 Ultra 採用首款四晶粒 UltraFusion 架構,最高提供 36 核心 CPU(12 個超級核心 + 24 個效能核心)、80 核心 GPU,並首次在 Ultra 晶片內建神經網路加速器,AI 峰值運算效能最高可達 M3 Ultra 的 4.3 倍、M1 Ultra 的 9.8 倍。 搭配最高 512GB 統一記憶體與 1.2TB/s 記憶體頻寬(較前代提升 50%),這台機器從發表之初就被定位為「可以完全在本機執行大型語言模型」的桌上型電腦。
這次流出的數據之所以受到關注,有兩個原因。其一,這是 M5 Ultra 晶片第一份實際跑在 MLX 生態系上的效能成績,而不是官方簡報上的理論數字;其二,這些數據是透過 oMLX 的社群基準測試頁面出現,代表測試環境、上下文長度、批次大小都有標準化條件,比一般個人跑分更容易與其他晶片橫向比較。
oMLX 流出的首批實測數據
在 oMLX 的 Community Benchmarks 頁面上(現在已被移除),出現了標記為「M5 Ultra (80c) / 256GB」的實測資料。oMLX 是架構在 Apple MLX 框架之上的推理引擎,提供統一的社群基準測試平台,讓不同 Apple Silicon 晶片在同一套測試條件下(相同上下文長度、相同批次大小)互相比較。 根據流出截圖,該平台的測量指標分為 PP(prefill,提示處理速度)與 TG(text generation,文字生成速度)兩個欄位,並支援過濾晶片、模型、量化、上下文長度等條件。
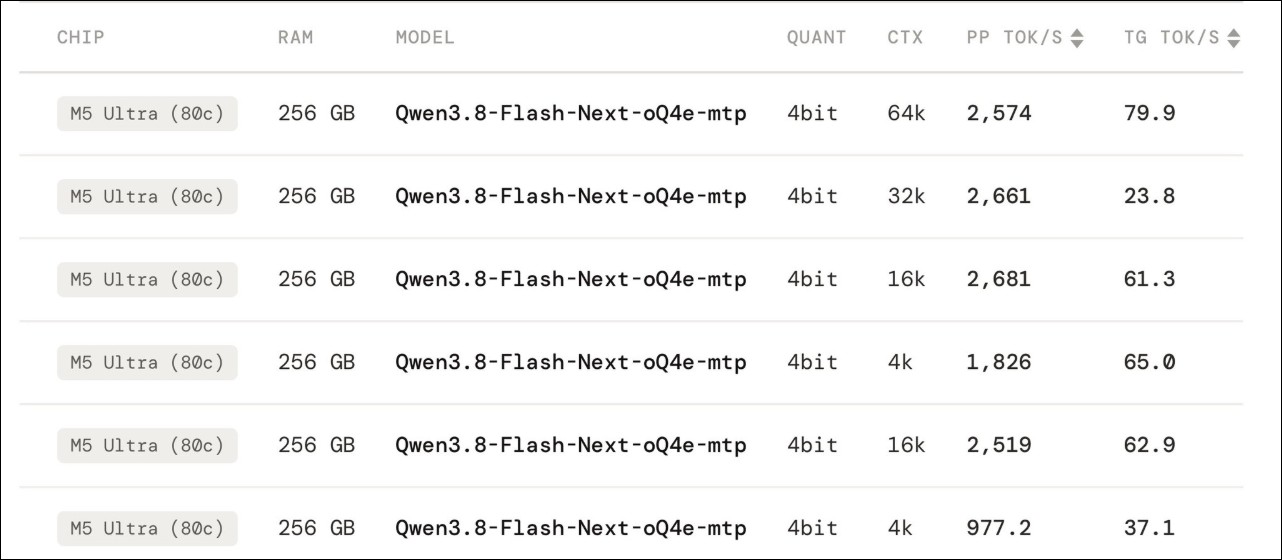
根據流出數據,M5 Ultra 在不同模型與量化組合下的表現如下:
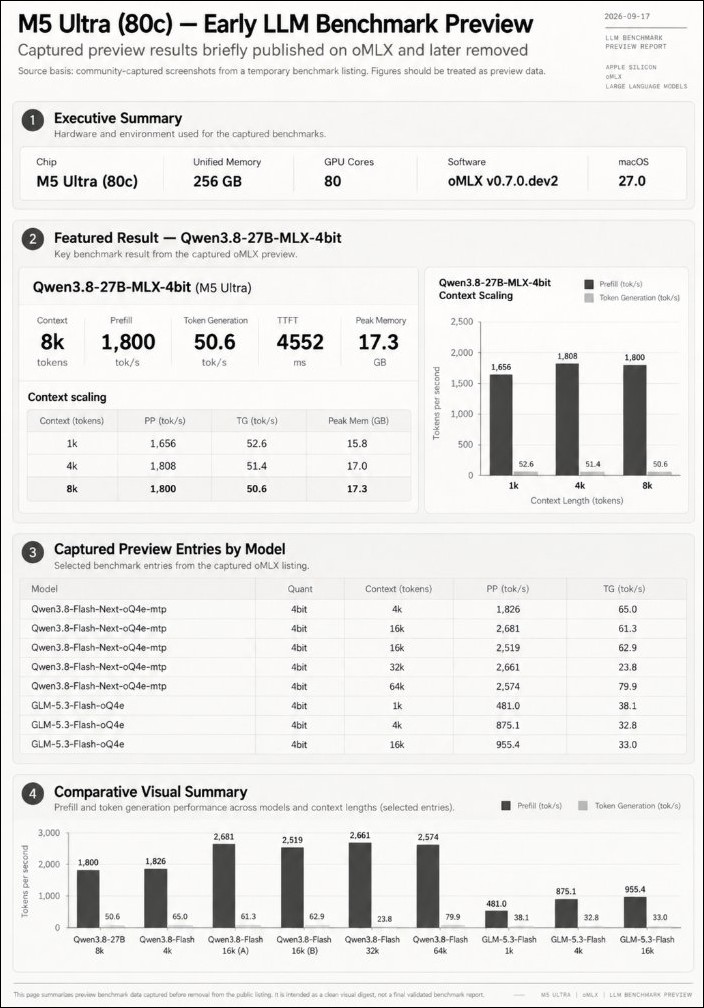
- Qwen3.8-27B(Q4 量化,8K 上下文):prefill(提示處理)1,800 tokens/s、decode(文字生成)51 tokens/s
- Qwen3.8-Flash-Next(Q4 量化 + MTP,64K 上下文):prefill 2,574 tokens/s、decode 80 tokens/s
- GLM 5.3 Flash(oQ4e 量化,16K 上下文):prefill 955.4 tokens/s、decode 33.0 tokens/s
- Qwen3.8-Flash-Next(Q4 量化 + MTP,32K 上下文):prefill 2,661 tokens/s、decode 23.8 tokens/s
- Qwen3.8-Flash-Next(Q4 量化 + MTP,16K 上下文):prefill 2,681 tokens/s、decode 61.3 tokens/s
其中 Qwen3.8-Flash-Next 在 16K 上下文跑出最高 2,681 tokens/s 的 prefill 速度,64K 上下文維持 2,574 tokens/s,顯示 M5 Ultra 的提示處理能力幾乎不隨上下文長度明顯衰退。
另一名開發者也有存到相關數值,可作為補充:
世代升級的關鍵:prefill 快了 3-4 倍
對比同樣由社群跑出的 M3 Ultra 數據,這次升級最有感的環節是 prefill(預填充處理)速度。在 MLX 官方社群的 M3 Ultra 系統性測試中,Qwen 32B Q4 量化在 8K 上下文只有約 27.5 tokens/s 的 decode 速度,1K 上下文時 Q2 量化才達到約 47.6 tokens/s。 當時的測試也點出 M3 Ultra 的 prefill 受計算瓶頸(約 54 TFLOPS FP16)限制,與量化程度無關。
AI 社群觀察到,M5 Ultra 與同級 M3 Ultra 配置相比,prefill 速度約提升 3 到 4 倍,被認為是這代晶片最大的世代進步之一。這與蘋果官方宣稱「AI 峰值運算效能達 M3 Ultra 的 4.3 倍」的方向一致。
decode (解碼)速度方面,M5 Ultra 在 27B 模型上約 50-80 tokens/s 的表現,與 M3 Ultra 的 30B 級模型數據相比也有明顯增長,但兩者使用的模型與量化方式不同,數值只能參考方向,不宜直接畫上等號。 從 MLX 社群的經驗來看,decode 階段的瓶頸主要是記憶體頻寬而非算力,M5 Ultra 的 1.2TB/s 頻寬對文字生成速度的幫助,會比 prefill 更直接反映在長上下文、長輸出的應用情境。
數據曝光後隨即被移除
這批數據在網路上引起討論後,oMLX 上的 M5 Ultra 項目已經消失。發文者在後續推文中表示,無法確認是原始測試者自行刪除,還是 oMLX 平台事後下架。
Some of the first M5 Ultra Studio performance numbers have been posted on oMLX and they are looking very good.
Qwen3.8-27B at Q4:
1,800 tokens per second prefill
51 tokens per second decode at 8k contextQwen3.8-Flash-Next at Q4 MTP:
2,574 tokens per second prefill
80 tokens… pic.twitter.com/UgN3z6VQXf— Mike Bradley (@MikeBradleyAI) September 17, 2026
關鍵問題是:M5 Ultra Mac Studio 要到 9 月 22 日才正式開始出貨給一般消費者,也就是說,提交這批數據的人至少在正式出貨前 5 天就拿到了機器,可能是媒體、開發者或提前收到樣機的內部人士。 這也解釋了數據為何會被移除:在產品尚未正式開賣前,非官方公布的效能數據通常會涉及保密協議或產品上市節奏考量。
台灣市場的部分,搭載 M5 Ultra 的 Mac Studio 已於 8 月 27 日起開放預購,售價 NT$199,900 起(教育優惠價 NT$185,390 起),配備 512GB 統一記憶體的版本預計 10 月底推出。
Apple 突襲發表 Mac mini M6 與 M5 Pro:首搭 2 奈米晶片,AI 效能提升 4 倍,台灣 29,900 元起
本地 AI 落地的意義
這份數據對開發者社群而言,象徵的是「旗艦級本地 AI」的門檻又下修了一階。過往要在 Mac 上順暢跑 70B 等級以上的模型,往往需要忍受不快的文字生成速度,或是在長上下文下明顯變慢。M5 Ultra 的定位則不同:80 核心 GPU 加上最高 512GB 統一記憶體,可以同時容納多個 30B 級模型,prefill 2,500+ tokens/s 的速度也讓「丟大量文件進去分析」的場景變得實際。蘋果官方也曾提到,多台 Mac Studio 可以透過 Thunderbolt 5 與 RDMA 串聯成叢集,四台組成的叢集 AI 推理速度最高可達單台的 3 倍,進一步擴展本地推理的規模上限。
對於台灣市場的開發者與 AI 研究者來說,M5 Ultra Mac Studio 的價格帶(NT$199,900 起)仍屬於專業工作站等級,但考量到它可以完全不依賴雲端、在本地執行大型模型的特性,對照雲端 GPU 租用的長期成本,確實有一定吸引力。 不過,512GB 記憶體版本要到 10 月底才推出,真正想挑戰最大規模模型的用戶還得再等一個月。
總結
雖然流出的數據只涵蓋 80 核心 GPU + 256GB 記憶體的配置,而且已經被下架,但方向相當明確:M5 Ultra 在預填充(prefill)階段的效能躍升是這代晶片最值得期待的部分,官方宣稱的「AI 效能 4.3 倍提升」並不是紙上數字。 對於打算在 Mac 上跑大型語言模型、甚至透過 Thunderbolt 5 串聯多台 Mac Studio 組成叢集的開發者來說,9 月 22 日出貨後,真正的實測數據很快就會陸續出現。